Python处理大型JSON文件:分块读取与内存优化方案
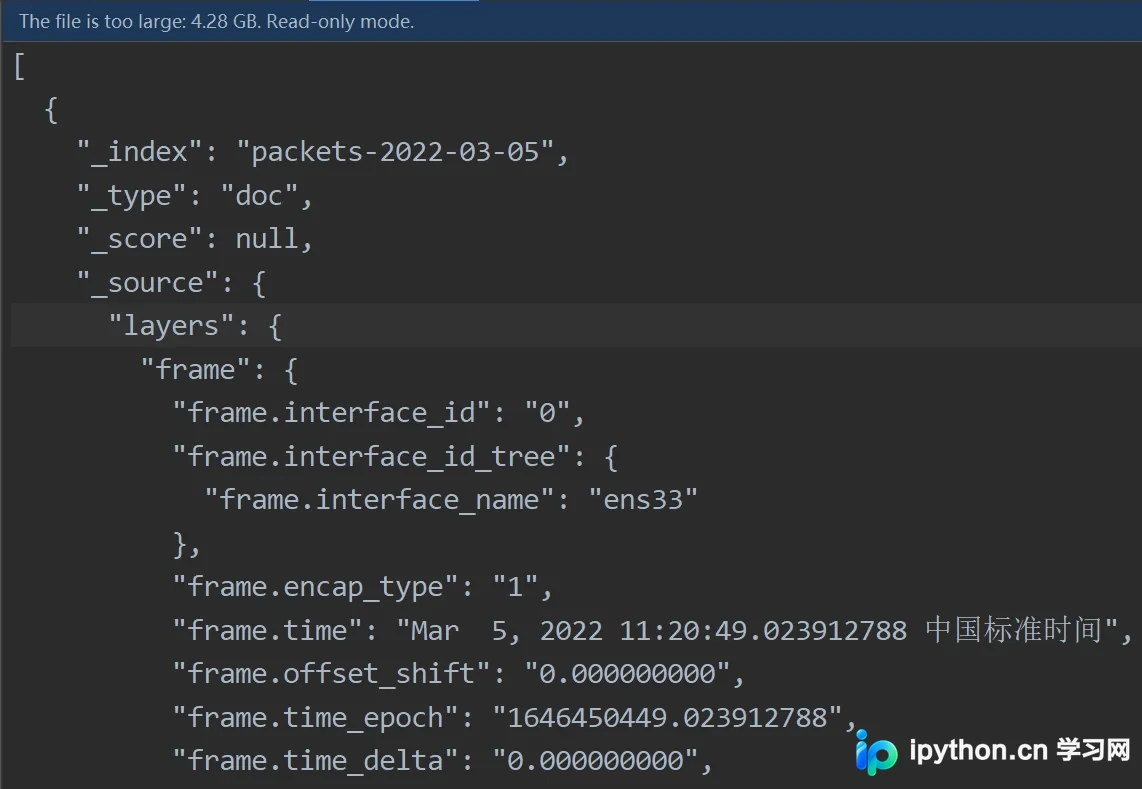
针对Python中json.load()处理大型JSON文件导致内存溢出或卡死的问题,本文提出一种基于逐行读取与括号计数法的预处理方案。通过统计花括号数量判断完整JSON对象边界,将数组元素逐个提取并转换为JSON字符串写入临时文件,从而避免一次性加载全部数据至内存,实现高效的大规模数据处理。
10-15
5




针对Python中json.load()处理大型JSON文件导致内存溢出或卡死的问题,本文提出一种基于逐行读取与括号计数法的预处理方案。通过统计花括号数量判断完整JSON对象边界,将数组元素逐个提取并转换为JSON字符串写入临时文件,从而避免一次性加载全部数据至内存,实现高效的大规模数据处理。
本文针对Python使用openpyxl处理60MB以上Excel文件时遇到的写入报错及内存占用过高问题,提供了两种核心解决方案:手动释放内存与安装lxml依赖以启用流式处理。同时深入探讨了遍历大范围单元格导致的内存瓶颈,通过限制遍历范围至ZZ5000、切换X64环境及定时重新读取文件等策略,将内存占用控制在2G以内,实现了高效的数据对比与处理。

本文介绍如何利用 PHP 配合 HTTP Range 协议实现大文件的断点续传功能。通过解析 $_SERVER['HTTP_RANGE'] 请求头,服务器可返回 206 Partial Content 状态码及指定字节范围的数据。该方案不仅能满足播放器缓冲需求,还能在用户中断下载时节省带宽资源。文中提供了完整的 PHP 代码示例,涵盖 MIME 类型检测、Content-Range 头部设置及文件流读取逻辑。
本文介绍在Python中处理包含大量数据的大文件时,如何避免全量加载导致内存溢出。通过分段读取与覆盖写入的策略,定位目标行后利用seek和truncate方法实现单行删除,确保低内存占用下完成文件修改操作。
本文分析Python处理大文件时速度逐渐变慢的现象,排查了GC和Git同步等干扰因素,最终定位到使用in dict.keys()进行键存在性检查导致的性能瓶颈。通过对比测试,推荐使用in dict直接判断或has_key()方法,显著提升处理效率,并解释了Python3中has_key()被移除的背景。
本文介绍了使用Python处理大文件的常见场景,包括内存溢出和传输困难问题。通过提供具体的Python代码示例,展示了如何按后缀或前缀管理文件列表,并实现大文件的分割与合并操作,帮助开发者高效处理大型数据文件。
在PHP中处理GB级日志或数据文件时,直接全量读取会导致内存溢出。利用fseek函数从文件末尾向前移动指针是高效解决方案。本文对比了逐行扫描与批量块读取两种实现方式,通过控制参数调整读写步长,大幅降低I/O开销并提升执行效率,适用于需要快速获取文件最后N行数据的场景。
本文探讨Python在合并大量TXT文件时出现的写入不完整问题,即预期十万行仅写入4k多行。分析指出这可能是由于程序执行过快导致文件关闭时内容未完全落盘,或IDE显示限制造成的误解。文章提供了两种解决方案:通过flush和os.fsync强制刷新缓冲区,以及在循环中引入sleep机制确保写入完成,帮助开发者解决大文件处理中的数据完整性问题。
本文介绍在Python中处理如4GB大小的超大文本文件时,如何高效地逐行读取内容并写入目标文件。通过对比直接迭代文件对象与使用readlines()方法的差异,提供具体的代码实现,帮助开发者在避免内存溢出的同时完成文件数据的迁移与处理。
本文探讨Python中处理大文件解压与读取的常见问题,重点解决因编码格式不一致导致的解压失败。通过引入'ignore'参数规避严格编码检查,并对比不同读取方式的性能,验证了逐行读取处理百万级数据行的可行性与效率,为大数据文件操作提供参考。
本文介绍Python中处理大txt文件的三种逐行读取与分割方法。通过示例代码展示如何利用readline、迭代器及readlines配合内存限制策略,实现高效的数据分割。重点解析不同方法在内存占用和执行效率上的差异,帮助开发者根据实际场景选择合适的文件处理方案,避免内存溢出问题。
本文针对2.9G大文件逐行读取场景,对比Python四种常见读取方式。测试环境为i7-6820HQ及32G内存。结果显示:readlines()内存飙升但速度较快;readline()内存稳定但耗时最长;直接迭代fh最快且内存低;fileinput模块最慢。推荐大文件处理使用直接迭代方式,兼顾效率与内存安全。



