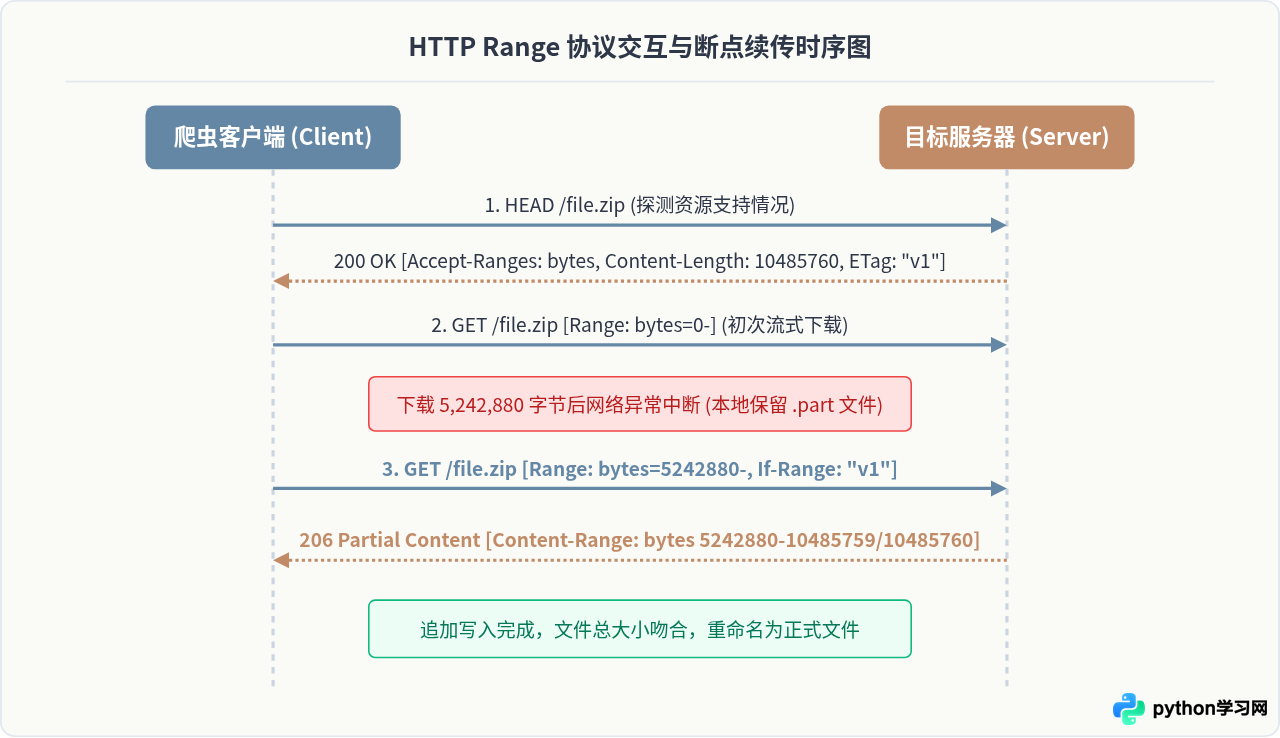
Python爬虫下载断点续传怎么实现?Range请求头详解
系统讲解Python爬虫如何利用HTTP Range请求头实现大文件断点续传,涵盖Accept-Ranges、Content-Range头解析、206与416状态码处理、文件追加写入及完整健壮代码实现。
10-27
14




系统讲解Python爬虫如何利用HTTP Range请求头实现大文件断点续传,涵盖Accept-Ranges、Content-Range头解析、206与416状态码处理、文件追加写入及完整健壮代码实现。
本文通过Java代码演示如何实现支持多线程并发与断点续传的文件下载功能。核心在于利用RandomAccessFile进行随机写入,并通过HTTP协议的Range头部指定下载字节范围。程序在本地创建进度文件记录已下载位置,重启时读取该位置继续下载,从而提升大文件传输效率并避免重复流量消耗。
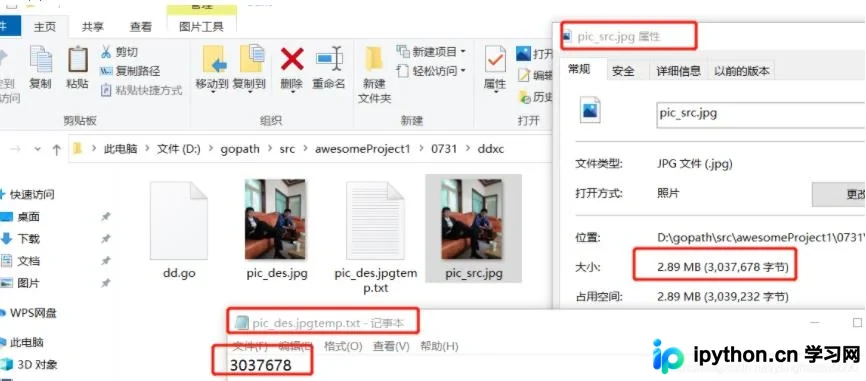
本文介绍了使用Go语言实现文件断点续传的完整方案。通过结合 os.File.Seek() 设置读写偏移量,并利用临时文本文件记录已传输的字节数,确保程序中断后可从上次位置继续传输,从而实现高效且可靠的大文件拷贝。
本文介绍如何利用 PHP 配合 HTTP Range 协议实现大文件的断点续传功能。通过解析 $_SERVER['HTTP_RANGE'] 请求头,服务器可返回 206 Partial Content 状态码及指定字节范围的数据。该方案不仅能满足播放器缓冲需求,还能在用户中断下载时节省带宽资源。文中提供了完整的 PHP 代码示例,涵盖 MIME 类型检测、Content-Range 头部设置及文件流读取逻辑。
本文详细介绍如何在PHP中实现支持断点续传的文件下载功能。通过解析HTTP请求头中的Range字段,配合Content-Range和206状态码,确保网络中断后可从上次位置继续下载。提供完整的函数代码及关键参数说明。
本文介绍使用Python通过HTTP协议下载大体积视频或音频文件的方法。核心在于利用HTTP请求头中的Range字段实现断点续传,并通过对比Content-Length与已接收文件大小来判断下载是否完成。文中提供了基于requests库的完整示例代码,支持大文件稳定下载。
本文介绍基于Python Socket实现的文件传输功能,涵盖文件MD5校验、实时进度条打印及断点续传机制。通过客户端与服务端示例代码,演示如何构建自定义协议以支持大文件传输中的异常中断恢复,适用于需要稳定文件交互场景的开发参考。



