


怎么使用Python字符串切片[::-1]实现反转
详细解析在Python中如何使用字符串切片[::-1]实现字符串反转,阐明步长与缺省索引寻址原理、底层执行机制、边界情况及与其他反转方式的对比。
在Python中反转字符串,最常用且最直接的方式是使用切片表达式 s[::-1]。例如定义一个变量 s = "Python",直接执行 s[::-1] 就能获得反转后的结果 "nohtyP"。这种写法无需借助外部模块或循环,利用的是Python切片中第三个参数“步长”(step)的机制。当步长被设为 -1 且省略起始和终止边界时,解释器会自动从右往左按步长1依次截取字符,生成一个顺序颠倒的新字符串。
一、核心语法与最简操作示例
很多刚接触Python的开发者在需要逆序输出一段文本时,可能会直觉性地去寻找类似于列表 reverse() 的方法。但由于Python中的字符串属于不可变类型(immutable),字符串对象本身并没有提供原地修改的 reverse() 方法。切片语法 [::-1] 正是解决该问题的官方推荐方案。
在终端环境或Python脚本中,反转操作的代码实现如下:
# 示例:基础字符串反转
original_str = "Hello, World!"
reversed_str = original_str[::-1]

print("原字符串:", original_str)
print("反转后:", reversed_str)
示例输出:
原字符串: Hello, World!
反转后: !dlroW ,olleH
如示例所示,整个反转过程被精简为一行表达式。原变量 original_str 保持完好,而 reversed_str 接收到了完全逆序的新字符串对象。
二、拆解切片语法:为什么 [::-1] 能够实现反转
要透彻理解 [::-1] 的运行逻辑,需要回到Python切片的基础定义。Python序列切片的完整表达形式为:sequence[start:stop:step],其中包含三个由冒号隔开的参数:
- start(起始索引): 切片开始的位置(包含该位置)。
- stop(结束索引): 切片结束的位置(不包含该位置)。
- step(步长与方向): 每次指针移动的跨度以及遍历的方向。
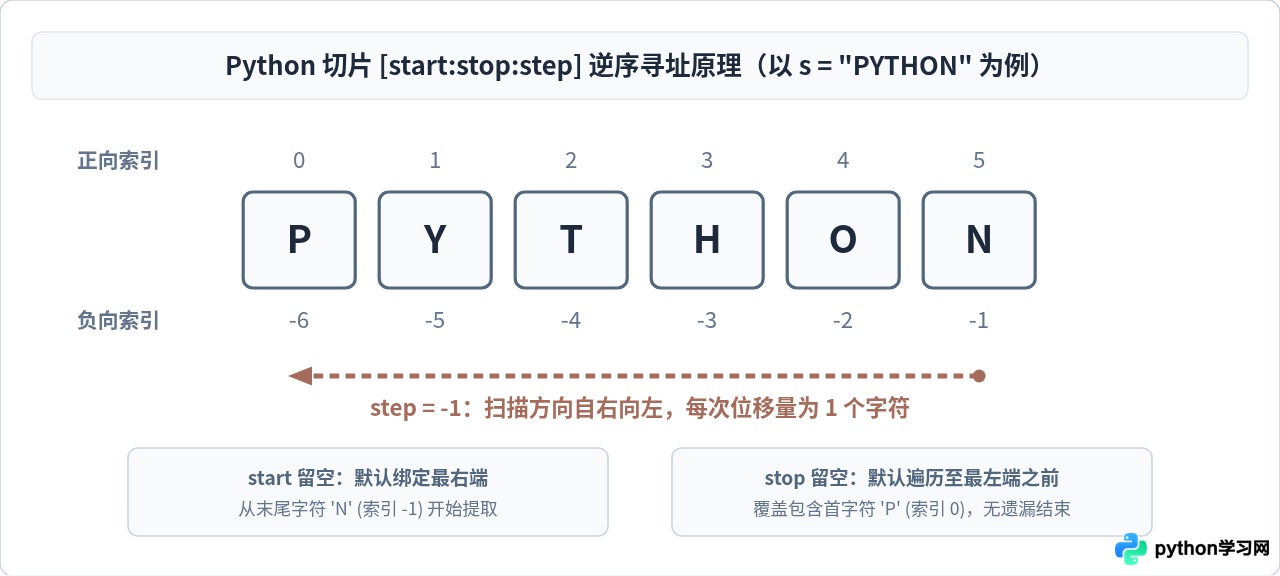
在通常的正向切片中,步长默认为 1,遍历指针从左向右移动。但当 step 被赋予负数(如 -1)时,切片的方向机制发生反转:指针改为从右向左移动。
关键的细节在于 start 和 stop 的缺省规则:当 step 为负数且 start 留空未写时,Python 会自动将 start 默认绑定为序列的最右侧末尾(即索引 -1 或 len - 1);当 stop 同样留空未写时,Python 会将终止位置延伸至序列最左端元素之前,确保索引 0 处的字符也被包含在内。因此,双冒号加负一 [::-1] 完整覆盖了自末尾至开头的整个序列。
三、执行过程与内存机制分析
很多初学者容易误以为 s[::-1] 会像指针交换一样就地改变原字符串,实际上并非如此。由于Python中的 str 对象在设计上是不可变的,任何涉及内容变动的操作都必须生成新对象。
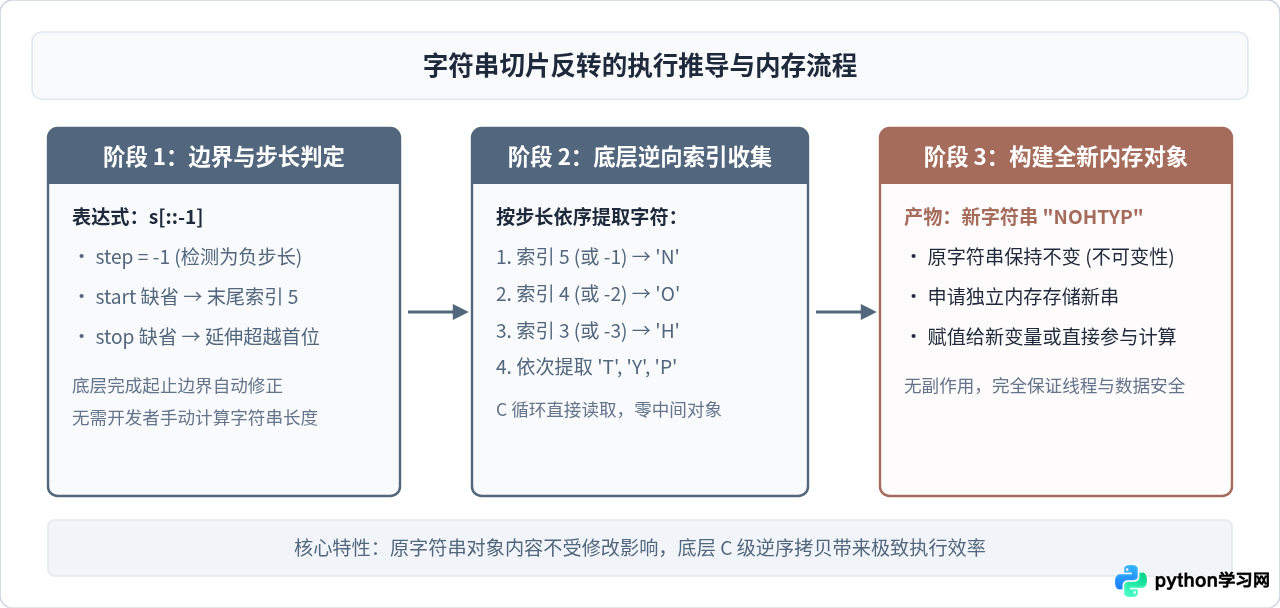
当执行 reversed_str = s[::-1] 时,底层解释器实际执行了三个阶段:
- 参数解析与边界修正: 检查切片参数,识别出步长为
-1,根据负步长规则自动填充未给定的起始位置与终止位置。 - 底层字符指针遍历: 在 CPython 的内部实现中,直接通过 C 语言级别的指针从后向前逐项读取字符的编码数据。这一步骤由底层原生实现,无需在 Python 解释器虚拟机中循环调度指令。
- 分配新内存: 计算目标字符串所需的连续内存空间,将逆向读取的数据一次性写入新分配的内存块,并构造出全新的字符串对象返回。
四、常见反转方案对比与选型依据
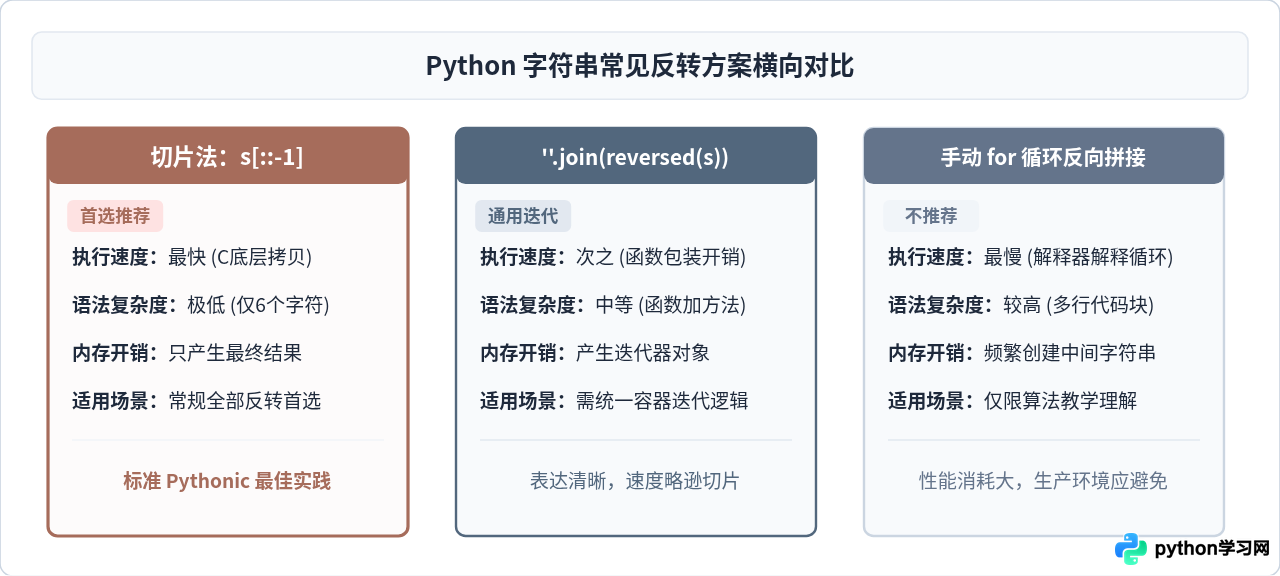
除了切片法,在Python社区中还有其他常见的字符串反转实现方式。理解这些写法的差异,有助于在实际项目中作出合理的选型判断。
1. 内置函数 reversed() 与 join()
Python 提供了内置函数 reversed(),该函数接收序列并返回一个逆序迭代器。由于它返回的是迭代器而不是字符串,必须配合字符串的 join() 方法重新组装:
s = "Python"
reversed_str = "".join(reversed(s))
这种写法的好处在于语义直白,即使完全不懂切片语法的读者也能一眼看出意图。但在性能表现上,由于需要创建迭代器对象并在Python层面逐项驱动迭代,其运行耗时通常是切片语法的数倍。
2. 显式 for 循环逐步拼接
通过倒序循环手动拼接字符串:
s = "Python"
reversed_str = ""
for char in s:
    reversed_str = char + reversed_str
这种方式在循环内部不断生成临时字符串对象,内存开销呈阶梯式增长,效率极低,在生产代码中应完全避免使用,仅在算法基础教学中用于讲解递归或累加概念。
五、边界场景与编码安全注意事项
在实际编码中,处理各种极端情况或复杂多语言字符时,切片 [::-1] 表现出了极高的容错性:
1. 空字符串与单字符边界
与直接访问单个索引 s[0] 容易触发 IndexError 不同,切片操作具备内建的越界保护机制:
# 空字符串安全处理
empty_s = ""
print(repr(empty_s[::-1]))  # 输出: '',安全返回空串

# 单字符处理
single_char = "A"
print(repr(single_char[::-1])) # 输出: 'A',安全返回原字符无论字符串是空串、只有一个字符,还是长达数兆字节的文本,[::-1] 都不会抛出越界异常。
2. 中文及 Unicode 多字节字符支持
Python 3 原生采用 Unicode 存储字符串。每个中文字符在 Python 内部都被作为一个独立的字符单位对待,而不是像早期底层语言那样视为多字节孤立字节片段。因此反转中文或中英混排文本完全安全:
chinese_str = "Python编程实战"
print(chinese_str[::-1])  # 输出: 战实程编nohtyP
注意复合字形(Grapheme Clusters):对于带有组合变音符号的拉丁字母(如 e 加上组合重音符 ́)或者由多个零宽连字组成的复杂 Emoji 表情,Unicode 规范中它们由多个独立的码点(Code Points)构成。此时切片 [::-1] 会精确逆转各个码点,可能导致修饰符与原字符错位。若业务涉及严谨的人类视觉字符反转,需使用第三方库如 regex 模块的字形簇切分。
六、全景总结与要点速查
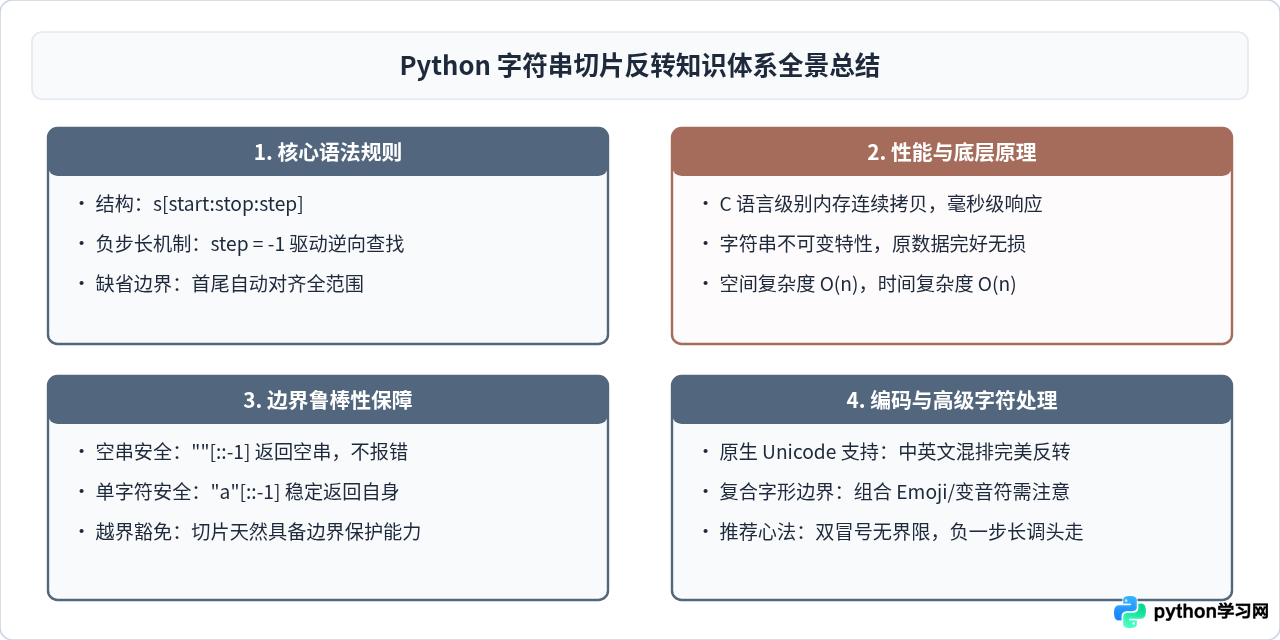
利用切片 [::-1] 反转字符串是 Python 中兼具效率与优雅的标准做法。牢记其本质:步长 -1 改变了扫描方向,留空的起止参数自动契合了完整的逆向区间,而底层的连续内存拷贝则保障了高性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















