Anaconda安装配置指南:搭建Python机器学习开发环境
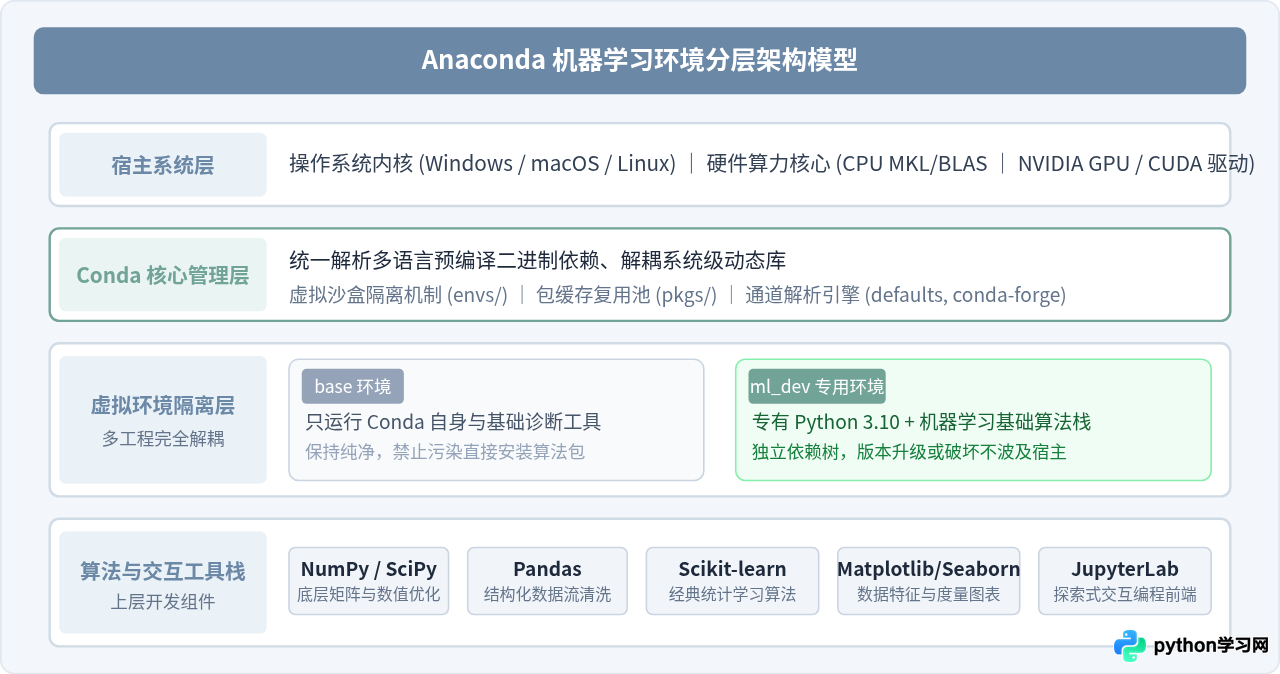
针对初学者与工程实践者的完整Anaconda安装与配置指南,涵盖安装细节、环境隔离机制、镜像源配置、机器学习专用虚拟环境搭建及核心依赖验证全流程。
10-22
10




针对初学者与工程实践者的完整Anaconda安装与配置指南,涵盖安装细节、环境隔离机制、镜像源配置、机器学习专用虚拟环境搭建及核心依赖验证全流程。
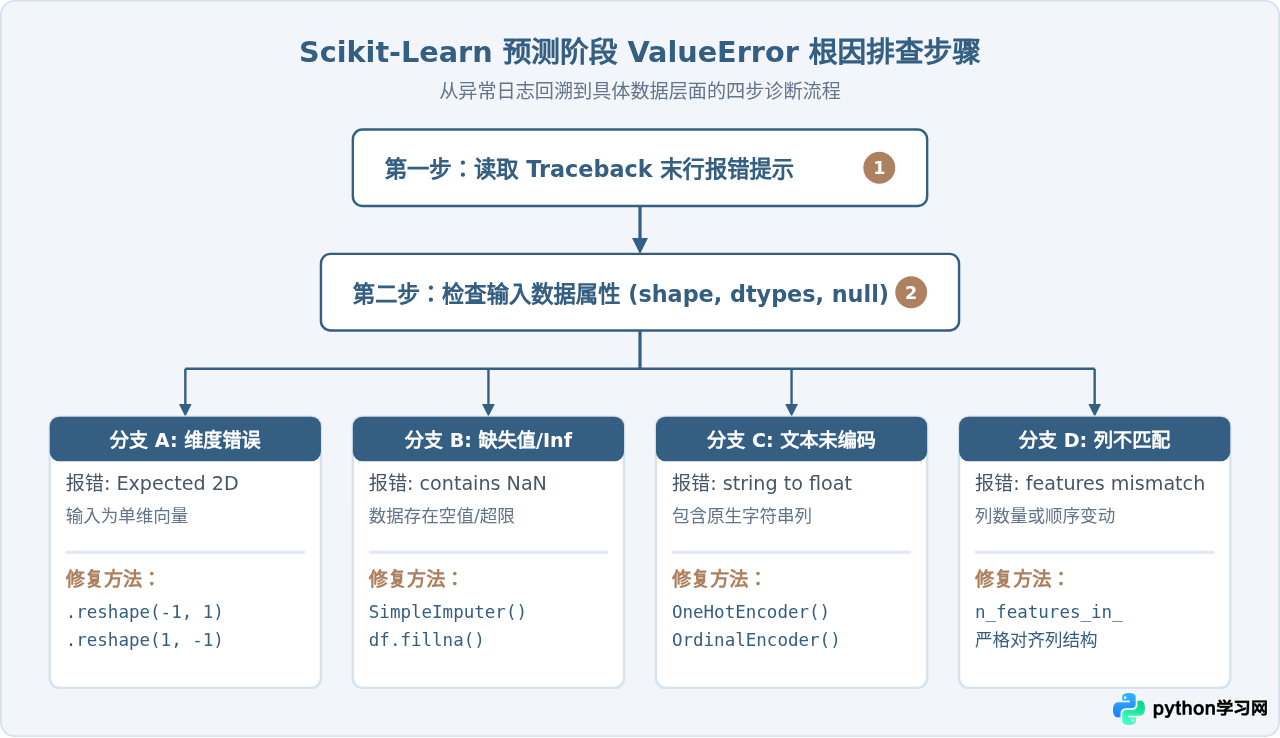
深入解析Python中scikit-learn(sklearn)预测模型抛出ValueError的常见场景,包括维度不匹配、缺失值未处理、类别字符串未编码及特征对齐失效等根本原因,提供详细排查步骤与完整可运行的修复方案。

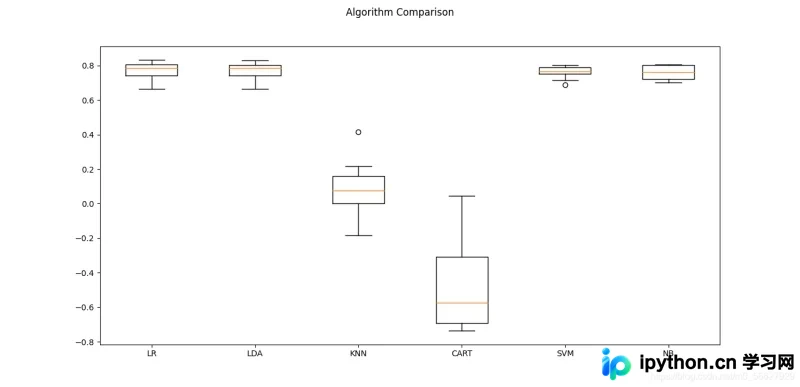
本文详细介绍在Python机器学习项目中如何进行算法审查。通过逻辑回归、LDA、KNN、SVM等分类算法,以及线性、岭、套索、弹性网络等回归算法的对比实验,展示如何利用scikit-learn进行10折交叉验证。文章提供了完整的代码模板和评估结果,帮助开发者科学选择最优算法。
本文详细介绍Python机器学习库scikit-learn的安装步骤及基础应用。涵盖NumPy、SciPy等依赖配置,演示数据加载、归一化、特征选择与提取流程,并实战朴素贝叶斯、k近邻及决策树算法,帮助开发者快速上手数据挖掘与分析。
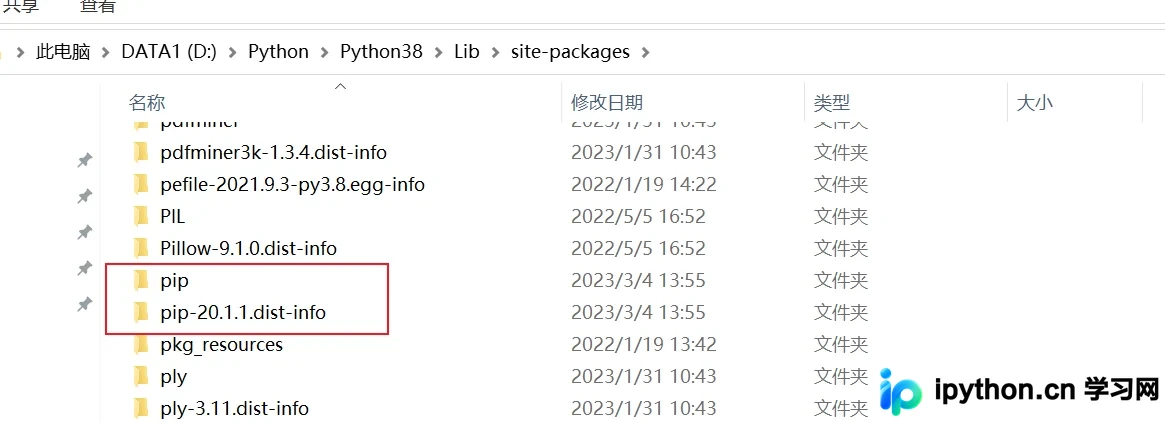
本文介绍如何将Python库升级至指定版本,以scikit-learn为例演示具体操作。针对升级后仍提示需升级的常见现象,提供两种解决方案:一是删除旧安装包后重新安装,二是直接通过pip命令升级至指定版本。同时涵盖pip工具本身的修复方法,帮助开发者解决依赖冲突与环境配置问题。
本文总结Python中处理缺失值的五种主要方法,包括忽略元组、人工填写、全局常量、均值填充及最可能值预测。结合Scikit-learn库的Imputer类,演示如何使用均值策略填充NaN数据,并分析各方法的适用场景与局限性,帮助开发者选择合适的数据预处理方案。
本文深入解析Python机器学习中的数据预处理技术,涵盖标准化、归一化、正则化、离散化和白化五大核心方法。通过Scikit-learn库的实战代码示例,详细阐述各方法的原理、适用场景及参数设置,帮助开发者优化模型输入特征,提升算法精度与训练效率。
本文介绍如何利用Python的Scikit-learn库中的OneHotEncoder类,对分类特征进行One-Hot编码处理。通过具体代码示例,展示如何配置编码器、拟合训练数据并转换训练集与测试集,帮助开发者高效完成特征工程步骤。



