Python数据合并详解:concat、merge与join函数用法对比
本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
2026-10-15
0



本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
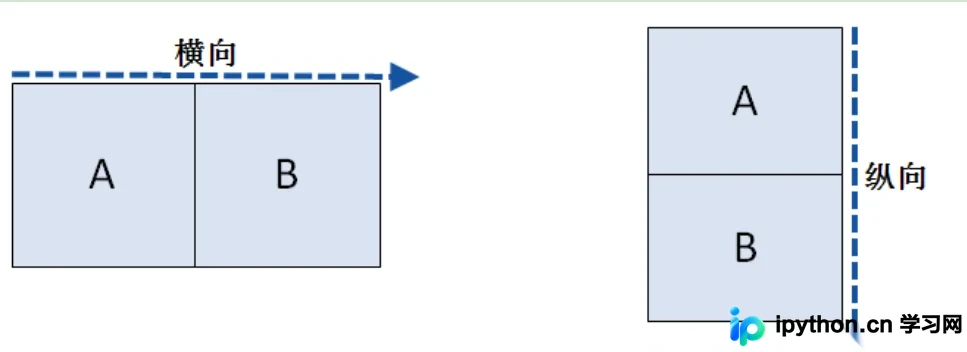
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。
本文详细介绍高性能 Go Web 框架 Iris 的安装方法及快速上手技巧。通过 go module 获取最新代码后,可轻松实现路由注册、参数解析及 JSON 响应。内容涵盖 RESTful API 的增删改查操作、路径参数捕获以及静态文件目录挂载,为开发者构建高效 Web 应用提供基础参考。
本文全面解析Python中的各类运算符,涵盖算术、逻辑、赋值、成员、身份、比较及三目运算符。详细讲解加减乘除、取余、幂次、逻辑与或非、复合赋值及比较判断的具体用法与区别,并深入剖析运算符的优先级规则,帮助开发者准确掌握Python编程基础。
本文介绍 MySQL 中利用 ON DUPLICATE KEY UPDATE 子句实现“存在则更新,不存在则插入”的高效方法。通过解析唯一索引冲突逻辑、受影响行数判断及 VALUES() 函数在多行插入中的应用,帮助开发者简化业务逻辑,提升数据操作性能。
本文详细介绍Python标准库itertools中的内置无限迭代器,包括count()生成自然数序列、cycle()循环序列、repeat()重复元素以及takewhile()截取有限序列的方法,并演示chain()串联和groupby()分组技巧,帮助开发者高效处理迭代对象。
本文详解Go语言的Mutex和RWMutex机制。通过银行账户存取款案例,演示如何使用sync.Mutex解决竞态条件,并分析RWMutex在读多写少场景下的性能优势及读写分离原则,附带完整代码与运行结果对比。
本文详细介绍Python中Fuzzywuzzy模块的使用方法,涵盖fuzz和process两大核心模块。通过fuzz.ratio、partial_ratio、token_sort_ratio及token_set_ratio等函数实现字符串相似度计算,并利用process.extract和extractOne从候选集中快速检索最相似文本,附带完整代码示例与参数说明。
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
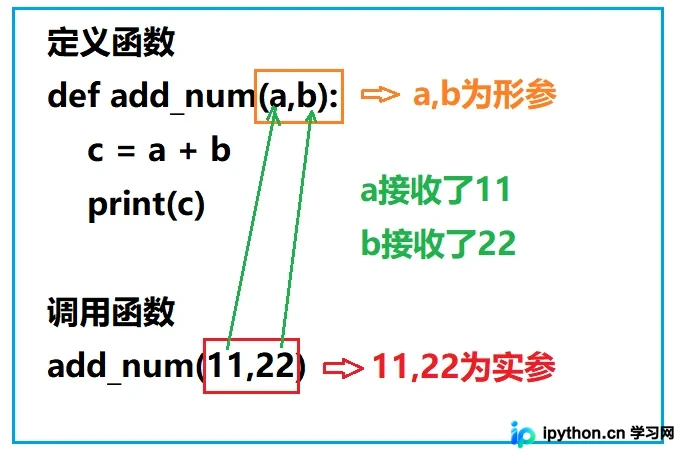
本文详细解析Python中函数的参数定义与调用机制,区分形参与实参概念。重点讲解位置参数、关键字参数的传参顺序,以及必备参数、默认参数的定义规则。深入剖析不定长参数*args与**kwargs的使用场景、拆包技巧及注意事项,帮助开发者掌握Python函数传参的核心规范。
本文介绍如何利用Python实现卡方(Chi)特征检验以提取关键文本特征。通过计算单词与类别间的依赖关系,筛选出最具区分度的词汇。文章提供了完整的代码示例,包括基础实现与简化算法,并分析了二分类场景下的公式推导及实际运行结果,帮助开发者理解特征选择的原理与应用。
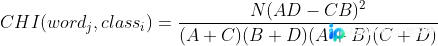
本文深入解析Go语言中的两种核心同步原语:互斥锁(Mutex)和读写锁(RWMutex)。通过模拟银行存取款场景,演示如何解决并发竞态条件,并对比两者在读多写少场景下的性能差异。文章包含完整的代码示例、运行结果分析及最佳实践建议,帮助开发者安全有效地管理共享资源。



