Python数据分析与AI开发:十大核心库详解
本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
2026-10-16
0



本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
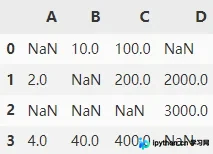
本文详解Python Pandas中缺失值的检测与处理技巧。通过info()、isnull()等方法识别NaN数据,并深入解析dropna()删除策略(axis、how、thresh、subset参数)及fillna()填充方法(直接指定、ffill/bfill前向/后向填充、limit限制)。掌握这些核心参数,高效完成数据清洗。
本文详解Python中True和False的使用陷阱,重点区分逻辑取反not与按位取反~的差异。解析if条件语句中非零值自动转为True的机制,以及pandas DataFrame.loc中布尔索引与Series取反行为的特殊性,帮助开发者避免常见错误。
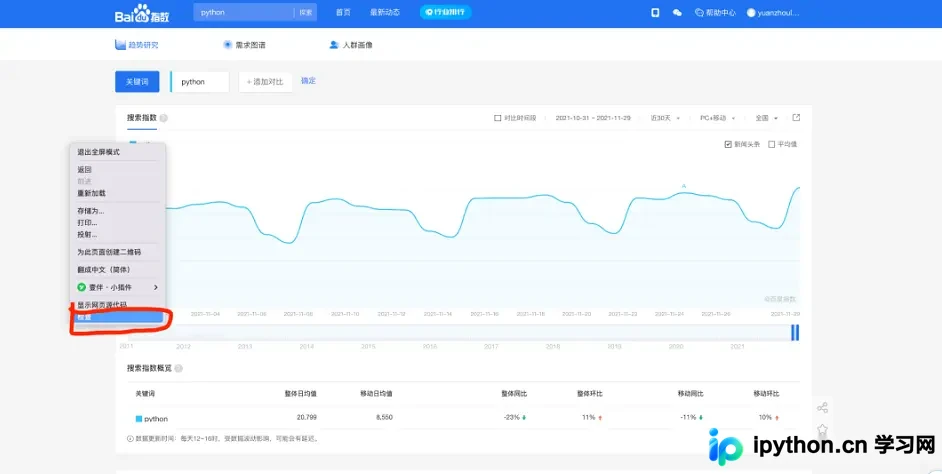
本文介绍如何使用Python脚本获取百度指数数据。通过提取登录Cookie,利用自定义类解析API返回的加密数据,生成Pandas DataFrame。文章包含获取Cookie的步骤、核心代码示例、数据保存为CSV的方法,以及使用Plotly进行时间序列可视化的完整流程,帮助开发者便捷地获取并分析关键词热度趋势。
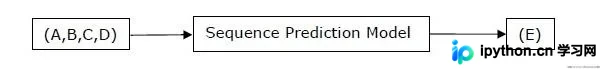
本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
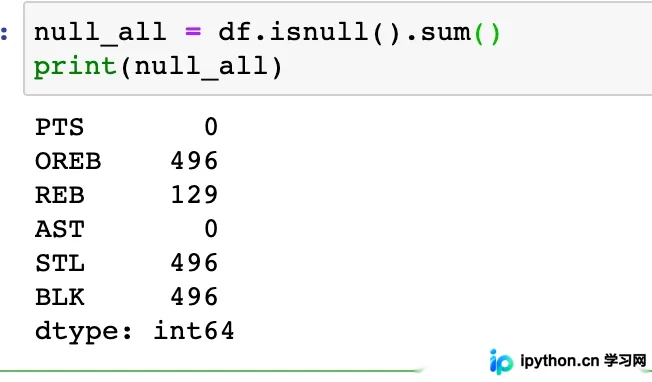
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。
本文详细介绍Python字典的常用操作,涵盖初始化、合并、推导式及collections标准库的使用。重点讲解defaultdict和Counter的高级用法,以及字典与JSON、Pandas DataFrame/Series之间的转换方法,帮助开发者高效处理数据结构。
本文详解Python中处理缺失值的完整流程。从导入数据、替换异常符号为NaN开始,利用isnull()统计缺失数量。重点讲解dropna()直接删除策略(含axis、how、thresh参数)与fillna()填充策略(均值/中位数/前后向填充),并引入sklearn的KNNImputer进行基于邻居的插补,提供完整代码示例。
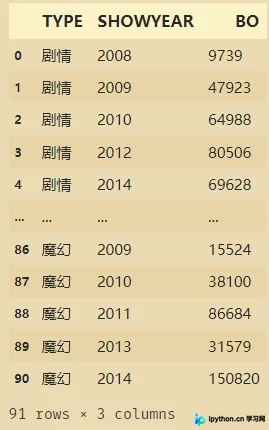
本文记录使用 Python pyecharts 库绘制 Boxplot 箱线图的完整过程。内容涵盖从 Excel 读取数据、利用 pandas 进行分组聚合与转置处理,到构建 y_data 列表并调用 pyecharts 的 Boxplot 类生成交互式图表。文中提供了详细代码示例,包括数据清洗、循环提取及最终渲染步骤,适用于需要展示电影票房等数据统计分布的场景。
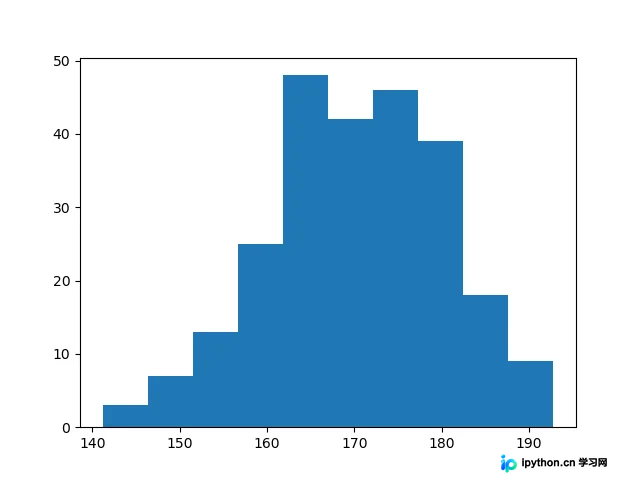
本文详细介绍在Python中生成直方图的两种主要方法。通过NumPy生成正态分布数据,分别使用Matplotlib和Pandas库绘制基础及定制直方图,展示参数设置与可视化效果,帮助读者掌握数据分布的可视化技巧。
本文介绍如何使用Python对月饼电商数据进行清洗与可视化分析。通过Pandas处理价格、销量及店铺信息,利用Pyecharts生成销量Top10店铺与商品柱状图、不同价格区间销量占比饼图以及各省销量分布地图,帮助直观了解市场趋势与热门产品。
本文详细介绍Python中help函数的使用方法。通过交互式命令行,开发者可以利用help()查看模块、类方法、变量及内置函数(如print)的详细文档。文章演示了如何通过命令查看pandas模块及其read_csv函数的接口说明,并指导用户通过回车键分页浏览长文档,解决英文文档阅读障碍,提升开发效率。