


Python与AI分析时间序列数据

本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
简介
时间序列数据是指在特定时间间隔内记录的一系列数据。若要在机器学习中构建序列预测模型,必须处理顺序数据和时间因素。时间序列数据本质上是顺序数据的集合,其中数据的时间排序是其关键特征。
序列分析或时间序列分析的基本概念
序列分析(或时间序列分析)旨在基于先前观察到的数据,在给定输入序列的情况下预测下一个值。预测目标可以是符号、数字、次日天气、下一个语音等任何可能的结果。序列分析在股票市场预测、天气预报及产品推荐等应用场景中具有重要价值。
示例
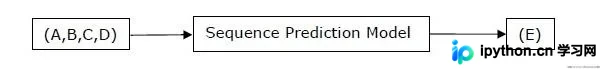
请参考以下示例以理解序列预测过程。假设已知值A、B、C、D,您需要利用序列预测模型来预测值E。
安装实用软件包
进行时间序列数据分析时,需安装以下Python软件包:
Pandas
Pandas是一个开源的BSD许可库,提供高性能且易于使用的数据结构和Python数据分析工具。可使用以下命令安装Pandas:
pip install pandas若使用Anaconda并通过conda包管理器安装,可执行以下命令:
conda install -c anaconda pandashmmlearn
这是一个开源的BSD许可库,包含用于学习Python中隐马尔可夫模型(HMM)的简单算法和模型。可通过以下命令安装:
pip install hmmlearn若使用Anaconda并通过conda包管理器安装,可执行以下命令:
conda install -c omnia hmmlearnPyStruct
这是一个用于结构化学习和预测的库。PyStruct中实现的算法包括条件随机场(CRF)、最大边缘马尔可夫随机网络(M3N)或结构支持向量机等。可通过以下命令安装:
pip install pystructCVXOPT
该库用于基于Python语言的凸优化,也是一个免费软件包。可通过以下命令安装:
pip install cvxopt若使用Anaconda并通过conda软件包管理器安装,可执行以下命令:
conda install -c anaconda cvdoxtPandas:处理,切片和从时间序列数据中提取统计数据
处理时间序列数据时,Pandas是非常有用的工具。借助Pandas,您可以执行以下操作:
- 使用pd.date_range()函数创建日期序列
- 使用pd.Series()将带有日期的数据索引为Pandas对象
- 使用ts.resample()函数进行重新采样
- 更改数据频率
示例
以下示例展示了如何使用Pandas处理和切片时间序列数据。请注意,此处使用的是每月北极涛动(AO)数据,来源为monthly.ao.index.b50.current.ascii,可转换为文本格式供使用。
处理时间序列数据
处理时间序列数据需执行以下步骤:
第一步涉及导入以下软件包:
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
接下来,定义一个函数,从输入文件中读取数据,代码如下:
def read_data(input_file):
input_data = np.loadtxt(input_file, delimiter = None)
现在,将此数据转换为时间序列格式。为此,需创建时间序列的日期范围。本例中保持每月数据频率,文件数据起始于1950年1月。
dates = pd.date_range('1950-01', periods = input_data.shape[0], freq = 'M')在此步骤中,借助Pandas Series创建时间序列数据,如下图所示:
output = pd.Series(input_data[:, index], index = dates)
return output
if __name__=='__main__':
输入输入文件的路径,如下所示:
input_file = "/Users/admin/AO.txt"现在,将列转换为时间序列格式,如下所示:
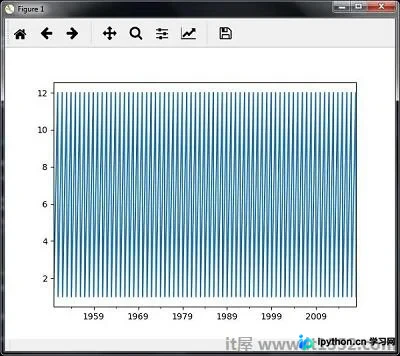
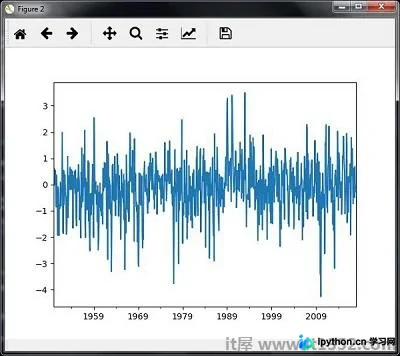
timeseries = read_data(input_file)最后,使用plt.plot()和plt.show()命令绘制并可视化数据:
plt.figure()
timeseries.plot()
plt.show()
您将观察到如下图所示的图形:
切片时间序列数据
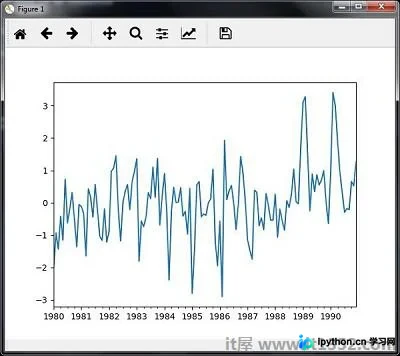
切片仅涉及检索时间序列数据的特定部分。作为示例,我们仅对1980年至1990年的数据进行切片。执行此任务的代码如下:
timeseries['1980':'1990'].plot()
  <matplotlib.axes._subplots.AxesSubplot at 0xa0e4b00>
plt.show()
运行切片时间序列数据的代码后,您可将以下图表视为图中显示的结果:
提取来自时间序列数据的统计数据
若需得出重要结论,必须从给定数据中提取统计数据。平均值、方差、相关性、最大值和最小值是常见的统计指标。若要从给定时间序列数据中提取此类统计数据,可使用以下代码:
平均值
可使用mean()函数查找均值,如下所示:
timeseries.mean()然后,您将针对所讨论的示例观察到以下输出:
-0.11143128165238671
最大值
可使用max()函数查找最大值,如下所示:
timeseries.max()然后,您将针对所讨论的示例观察到以下输出:
3.4952999999999999
最小值
可使用min()函数查找最小值,如下所示:
timeseries.min()然后,您将针对所讨论的示例观察到以下输出:
-4.2656999999999998
一次性获取所有内容
若想一次性计算所有统计数据,可使用describe()函数,如下所示:
timeseries.describe()然后,您将针对所讨论的示例观察到以下输出:
count 817.000000 mean -0.111431 std 1.003151 min -4.265700 25% -0.649430 50% -0.042744 75% 0.475720 max 3.495300 dtype: float64
重新采样
您可以将数据重新采样到不同的时间频率。执行重新采样的两个参数是:
时间段
方法
使用mean()重新采样
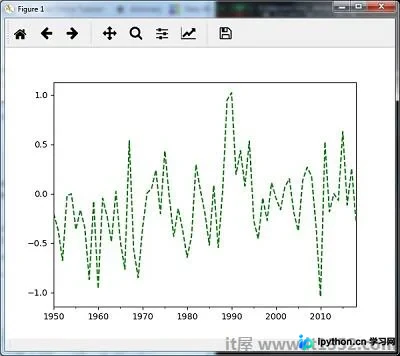
可使用以下代码使用mean()方法重新采样数据,这是默认方法:
timeseries_mm = timeseries.resample("A").mean()
timeseries_mm.plot(style = 'g--')
plt.show()
然后,您可以观察以下图表作为重采样使用mean()的输出:
Re -sampling with median()
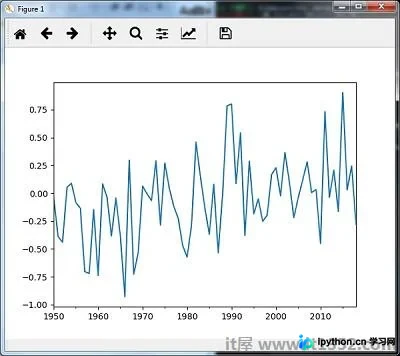
可使用以下代码使用median()方法重新采样数据:
timeseries_mm = timeseries.resample("A").median()
timeseries_mm.plot()
plt.show()
然后,您可以观察下图作为重新采样的输出,其中位数为():
滚动平均值
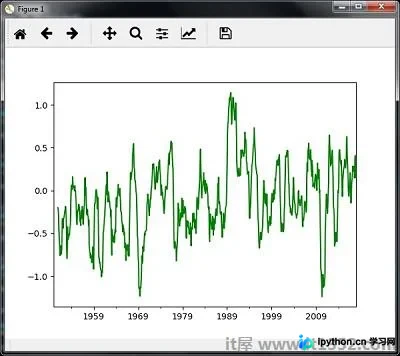
可使用以下代码计算滚动(移动)均值:
timeseries.rolling(window = 12, center = False).mean().plot(style = '-g')
plt.show()
然后,您可以观察下图作为滚动的输出(移动)mean:
通过隐马尔可夫分析顺序数据模型(HMM)
HMM是一种统计模型,广泛用于具有延续性和可扩展性的数据,如时间序列股票市场预测、健康检查和语音识别。本节详细介绍使用隐马尔可夫模型(HMM)分析顺序数据。
隐马尔可夫模型(HMM)
HMM是一个随机模型,建立在马尔可夫链概念基础上,该假设未来统计数据的概率仅取决于当前过程状态,而不依赖于之前的任何状态。例如,在掷硬币时,我们不能说第五次抛掷的结果将是正面。这是因为硬币没有记忆,下一个结果不依赖于之前的结果。
数学上,HMM由以下变量组成:
状态(S)
它是HMM中存在的一组隐藏或潜在状态,由S表示。
输出符号(O)
它是HMM中存在的一组可能的输出符号,由O表示。
状态转换概率矩阵(A)
它是从一个状态转换到另一个状态的概率,由A表示。
观察发射概率矩阵(B)
它是在特定状态下发射/观察符号的概率,用B表示。
先验概率矩阵(Π)
它是从系统的各种状态开始于特定状态的概率,由Π表示。
因此,HMM可以定义为λ=(S,O,A,B,π),
其中,
S = {s1,s2,...,sN}是一组N个可能的状态,
O = {o1,o2,...,oM}是一组M个可能的观察符号,
A是N
以上就是Python与AI分析时间序列数据的详细内容,更多关于Python AI分析时间序列的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















