Python实现报表自动化生成与邮件发送全流程
本文详细介绍如何利用Python实现报表自动化流程,涵盖从数据源读取、DataFrame计算、统计指标处理到图表生成的全过程。重点讲解使用Matplotlib和Echarts绘制可视化图表,并通过smtplib与email模块实现报表自动打包及发送至指定邮箱的功能,旨在提升数据分析效率并减少人工操作错误。
2026-10-16
0



本文详细介绍如何利用Python实现报表自动化流程,涵盖从数据源读取、DataFrame计算、统计指标处理到图表生成的全过程。重点讲解使用Matplotlib和Echarts绘制可视化图表,并通过smtplib与email模块实现报表自动打包及发送至指定邮箱的功能,旨在提升数据分析效率并减少人工操作错误。
本文介绍如何使用pandarallel库实现Pandas数据的多进程并行处理,以显著提升数据清洗速度。通过对比单进程与多进程在处理100万条数据时的耗时,展示pandarallel在apply、map等操作中的加速效果,并附带完整代码示例。
本文介绍如何在Python DataFrame中统计行列零值的个数,以及如何在列表中小于0的数。通过列表推导式和filter函数两种方法,实现高效的数据处理。
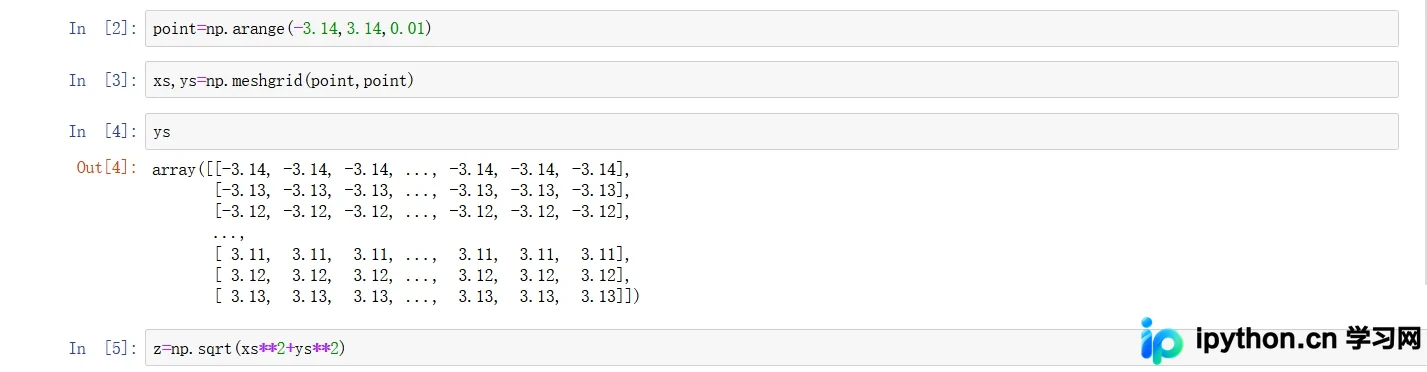
本文详解Python Numpy库中面向数组编程的核心操作。通过向量化计算替代循环,显著提升数据处理效率。深入解析np.where三元表达式、sum/mean等统计聚合函数、布尔数组判定以及unique等集合操作,提供从基础生成到复杂逻辑处理的完整代码示例,助力高效数据分析。
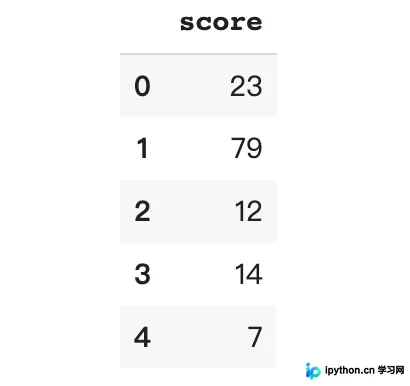
本文详细总结Pandas中对数值变量进行分箱(离散化)的四种常用方法。通过合成学生成绩数据,演示如何使用between结合loc、pd.cut、pd.qcut以及value_counts实现不同场景下的分箱需求,包括固定区间划分、等频分箱及基于统计量的分组,并对比各方法的参数设置与结果差异。
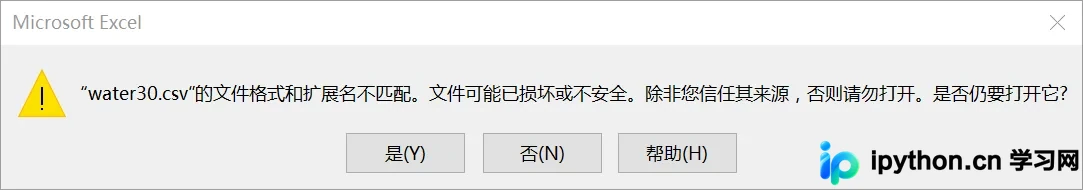
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
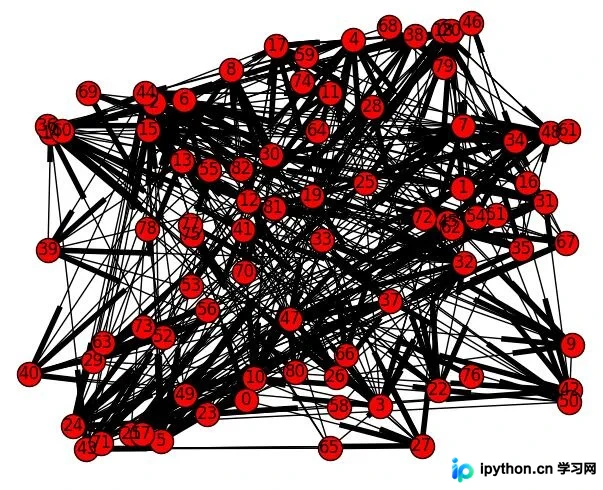
本文详细介绍如何使用Python的NetworkX库结合Matplotlib绘制高质量网络图。内容涵盖Graph、DiGraph等四种图类型的创建,节点与边的添加方法,以及nx.draw()函数的核心参数解析。通过详解布局算法、颜色、大小及透明度设置,帮助读者摆脱基础红点图,实现专业级网络可视化效果,并提供了相关源码参考链接。
本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
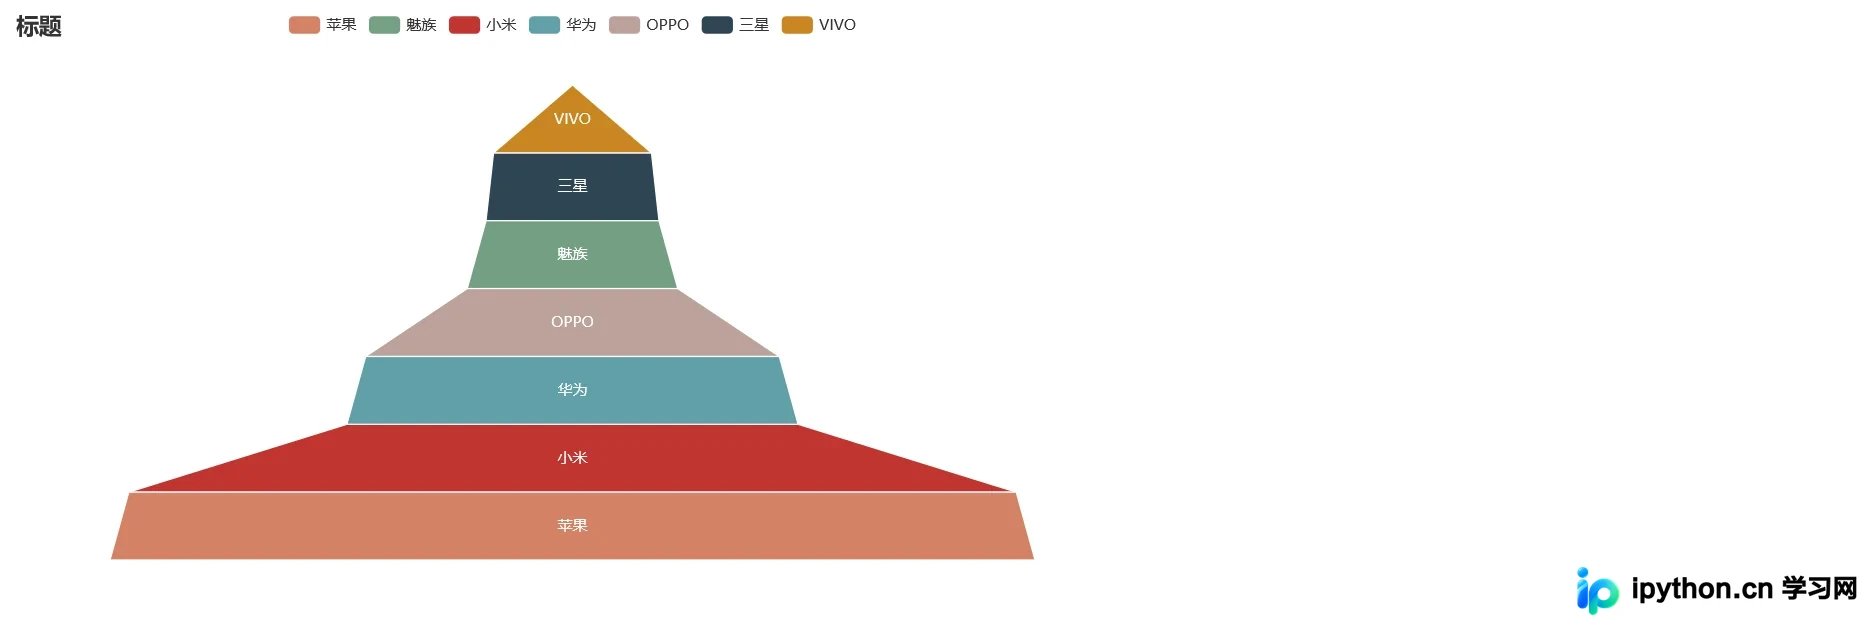
本文介绍使用 Python 库 pyecharts 绘制漏斗图的方法。首先阐述漏斗图在 Meta 分析中用于评估发表偏倚的原理,包括样本量与效应量的关系。随后提供尖顶型、锥子型、三角形及连接型四种模板的代码实现与可视化效果,帮助开发者快速掌握数据预处理与绘图技巧。
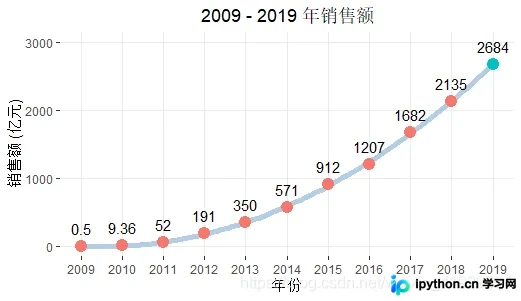
针对淘宝历年双十一销售额数据的拟合争议,通过R语言的ggplot2包对2009至2019年的销售额及增长率数据进行可视化重构。利用双Y轴设计清晰展示销售额的总量增长与增长率的变化趋势,验证数据分布的合理性并直观呈现经济学规律。
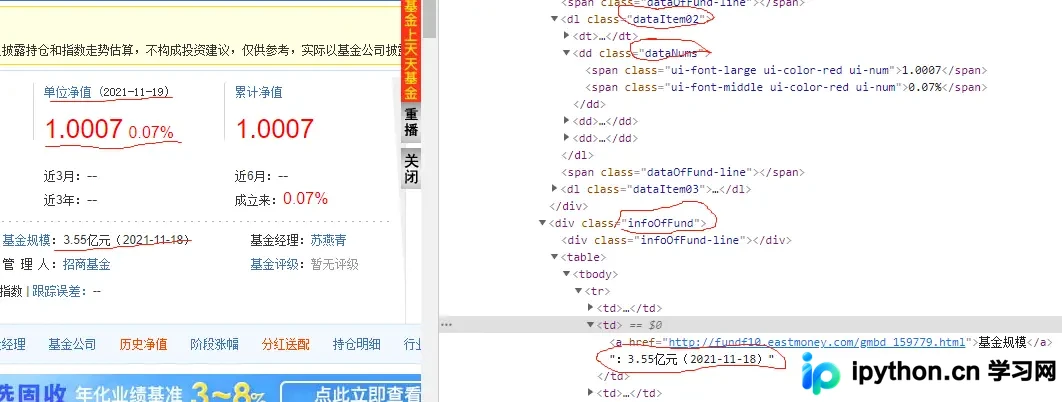
本文详解如何使用Python爬虫获取基金最新交易日的单位净值、涨跌幅及基金规模数据。通过解析HTML标签定位关键信息,并结合pymysql库进行数据库连接配置与SQL操作,实现数据的结构化存储,为后续基金分析与投资决策提供数据支持。