


Pandas数值分箱的4种实现方式:between、cut、qcut与value_counts详解

本文详细总结Pandas中对数值变量进行分箱(离散化)的四种常用方法。通过合成学生成绩数据,演示如何使用between结合loc、pd.cut、pd.qcut以及value_counts实现不同场景下的分箱需求,包括固定区间划分、等频分箱及基于统计量的分组,并对比各方法的参数设置与结果差异。
前言
介绍如何利用Pandas中的between、cut、qcut以及value_counts函数对数值变量进行离散化处理。
分箱(Binning),亦称分桶或离散化,是一种常见且重要的数据预处理技术。其核心目的是将连续的数值区间划分为若干个离散的“箱”或“桶”,以便于后续分析。本文将深入探讨使用Python Pandas库实现数值分箱的四种具体方法。
为了直观演示,我们首先构建一组合成数据集。
import pandas as pd # version 1.3.5
import numpy as np
def create_df():
 df = pd.DataFrame({'score': np.random.randint(0,101,1000)})
 return df

create_df()
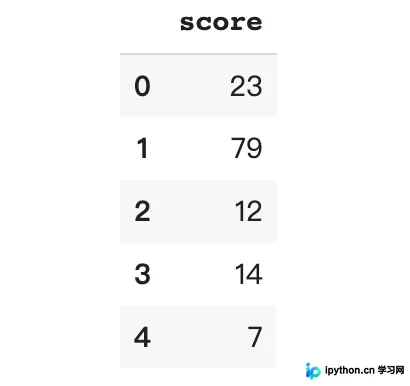
df.head()
该数据集包含1000名学生的考试成绩,分数范围在0到100之间。本次任务的目标是将这些连续的数值分数转换为离散的等级标签,分别标记为“A”、“B”和“C”,其中“A”代表最高等级,“C”代表最低等级。
1、between结合loc方法
Pandas提供的.between()方法会返回一个布尔Series,指示原Series中的元素是否位于指定的左边界left和右边界right之间。
该方法主要包含以下三个关键参数:
- left:定义区间的左边界值。
- right:定义区间的右边界值。
- inclusive:指定是否包含边界值,可选值包括“both”(两端都包含)、“neither”(两端都不包含)、“left”(仅包含左边界)和“right”(仅包含右边界)。
根据以下区间规则,我们将学生成绩划分为对应的等级:
- A级:(80, 100]
- B级:(50, 80]
- C级:[0, 50]
注:方括号“[”表示包含该边界值,圆括号“)”表示不包含。我们需要判断每个分数所属的区间,并赋予相应的等级标签。请留意不同参数对边界包含性的影响。
df.loc[df['score'].between(0, 50, 'both'), 'grade'] = 'C'
df.loc[df['score'].between(50, 80, 'right'), 'grade'] = 'B'
df.loc[df['score'].between(80, 100, 'right'), 'grade'] = 'A'
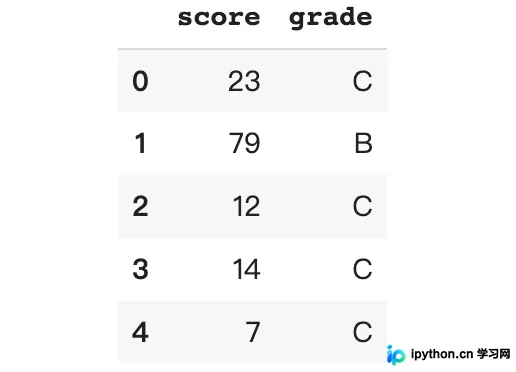
统计各分数区间内的人数分布:
df.grade.value_counts()
C 488 B 310 A 202 Name: grade, dtype: int64
由于该方法需要为每个分箱单独编写处理逻辑,因此它仅适用于分箱数量较少的场景。
2、cut方法
可以使用pd.cut()将数值分类到离散的间隔中。该函数在将连续变量转换为分类变量时尤为有用。
cut函数的主要参数如下:
- x:待分箱的一维数组或Series。
- bins:标量或序列,用于定义非均匀宽度的分箱边缘。
- labels:指定返回结果中分箱的标签,其长度必须与bins参数定义的区间数量一致。
- include_lowest:布尔值,指示第一个区间是否包含左边界。
bins = [0, 50, 80, 100]
labels = ['C', 'B', 'A']
df['grade'] = pd.cut(x = df['score'],
                      bins = bins,
                      labels = labels,
                      include_lowest = True)
通过上述步骤,我们创建了一个包含分箱边界值的bins列表,以及对应的分箱标签列表。
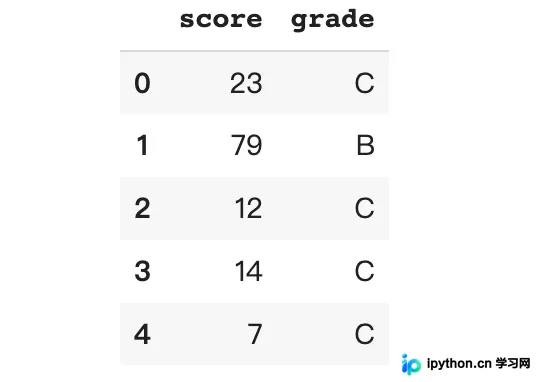
查看各区间的人数统计:
df.grade.value_counts()
C 488 B 310 A 202 Name: grade, dtype: int64
此结果与前述示例完全一致。
3、qcut方法
qcut()可以根据排名或基于样本分位数,将变量离散化为大小大致相等的桶[3]。
在前面的示例中,我们为每个等级定义了固定的分数间隔,这导致各等级内的学生数量不均匀。在下面的示例中,我们尝试将1000名学生划分为3个等级,使得每个等级包含大致相等数量的学生。理论上,每个分箱应包含约333名学生。
qcut函数的参数说明如下:
- x:待分箱的输入数组,必须是一维的。
- q:分位数,可以是整数(如10表示十分位数,4表示四分位数)或分位数序列(如[0, .25, .5, .75, 1.]表示四分位数)。
- labels:指定分箱的标签,长度必须与生成的分箱数量一致。
- retbins:布尔值,若为True,则返回分箱边界和标签。
df['grade'], cut_bin = pd.qcut(df['score'],
                          q = 3,
                          labels = ['C', 'B', 'A'],
                          retbins = True)
df.head()
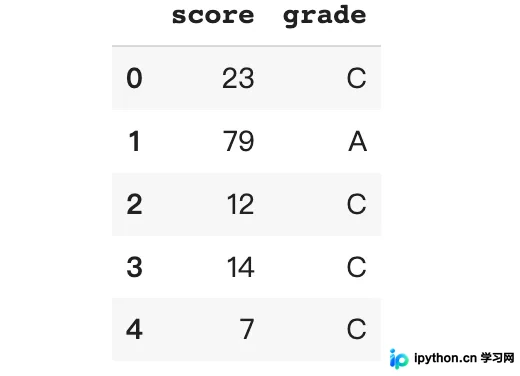
print (cut_bin)
>> [  0.  36.  68. 100.]
生成的分数区间如下:
- C级:[0, 36]
- B级:(36, 68]
- A级:(68, 100]
使用.value_counts()检查每个等级包含的学生数量。理想情况下,每个箱应包含约333名学生。
df.grade.value_counts()
C 340 A 331 B 329 Name: grade, dtype: int64
4、value_counts方法
虽然Pandas的.value_counts()通常用于计算Series中唯一值的出现频次,但它也可以通过bins参数将值分组到半开区间中。
df['score'].value_counts(bins = 3, sort = False)
默认情况下,.value_counts()会按值出现的降序对返回的Series进行排序。若希望按索引升序排列,可将sort参数设置为False。
(-0.101, 33.333]    310
(33.333, 66.667]    340
(66.667, 100.0]     350
Name: score, dtype: int64
返回的Series索引表示每个分箱的区间范围,其中方括号“[”和圆括号“)”分别表示包含和不包含边界值。Series的值则代表每个分箱中包含的记录数。
与.qcut不同,.value_counts生成的每个分箱中记录数不一定完全相等。.value_counts并非将相同数量的记录分配到类别中,而是根据最高分和最低分将分数范围划分为3个相等的部分。由于分数最小值为0,最大值为100,因此这3个部分的宽度约为33.33。这也解释了为何分箱边界是33.33的倍数。
我们还可以通过传入边界列表来自定义分箱边界。
df['score'].value_counts(bins = [0,50,80,100], sort = False)
(-0.001, 50.0] 488 (50.0, 80.0] 310 (80.0, 100.0] 202 Name: score, dtype: int64
此结果与示例1和示例2的结果相同。
以上即为Pandas对数值进行分箱操作的4种方法总结,更多关于Pandas数值分箱的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















