


Pandas多进程加速数据清洗:pandarallel实战与性能对比

本文介绍如何使用pandarallel库实现Pandas数据的多进程并行处理,以显著提升数据清洗速度。通过对比单进程与多进程在处理100万条数据时的耗时,展示pandarallel在apply、map等操作中的加速效果,并附带完整代码示例。
前言:
Python内置了multiprocessing模块用于并行计算,但在Pandas数据处理场景中直接使用该模块往往效果不佳。常见现象是CPU风扇高速运转,但程序迟迟无法完成,效率反而不如预期。
为了提升数据清洗的效率,本文介绍一个专门针对Pandas优化的多进程库:pandarallel 。通过实际测试,我们将验证其性能提升效果,并详细展示具体操作流程。
【注】文末提供技术交流方式
需要注意的是,对于小规模数据集(如1万条数据),多进程的开销可能超过其带来的收益,导致运行速度甚至慢于单进程。因此,本次测试采用100万条数据以充分展现多进程的优势。
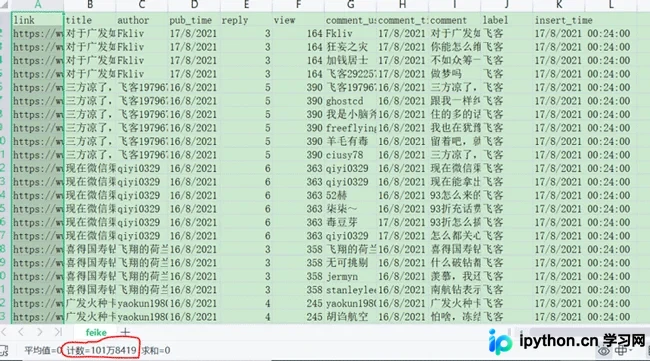
利用上述数据集,执行以下处理步骤:
- 剔除 title 和 comment 两列文本中的表情符号。
- 对 title 和 comment 两列进行分词处理,并将结果覆盖原列。
1、单进程
在交互式环境中输入如下命令:
'''单进程'''
import jieba
import re
import time
import pandas as pd

def filter_emoji(desstr, restr=''):
    if (desstr is None) or str(desstr) == 'nan':
        return ''
    # 过滤表情
    try:
        co = re.compile(u'[\U00010000-\U0010ffff]')
    except:
        co = re.compile(u'[\uD800-\uDBFF][\uDC00-\uDFFF]')
    return co.sub(restr, desstr)

if __name__ == '__main__':
    start = time.time()
    data = pd.read_csv('feike.csv',encoding='gbk')
    data['comment'] = data['comment'].map(filter_emoji)
    data['title'] = data['title'].map(filter_emoji)
    data['comment'] = data['comment'].map(lambda s: jieba.lcut(s))
    data['title'] = data['title'].map(lambda s: jieba.lcut(s))
    end = time.time()
    print(end - start)
输出:
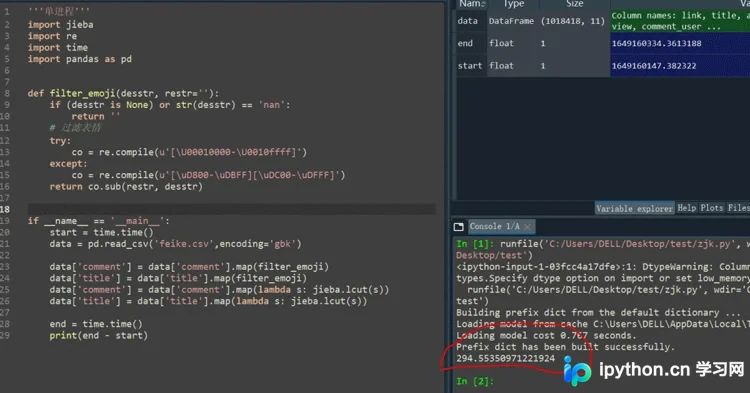
在单进程模式下,可以看到总耗时为 294s,接近 5min 。
2、多进程
使用 multiprocessing 的多进程写法,这种写法在网络上广泛存在,代码逻辑本身无误,多进程任务也能正常执行。
例如,当 run_task 函数中的任务是执行爬虫代码时,通常没有问题;但如果是执行数据清洗代码,经测试会发现运行时间极长,甚至无法完成。
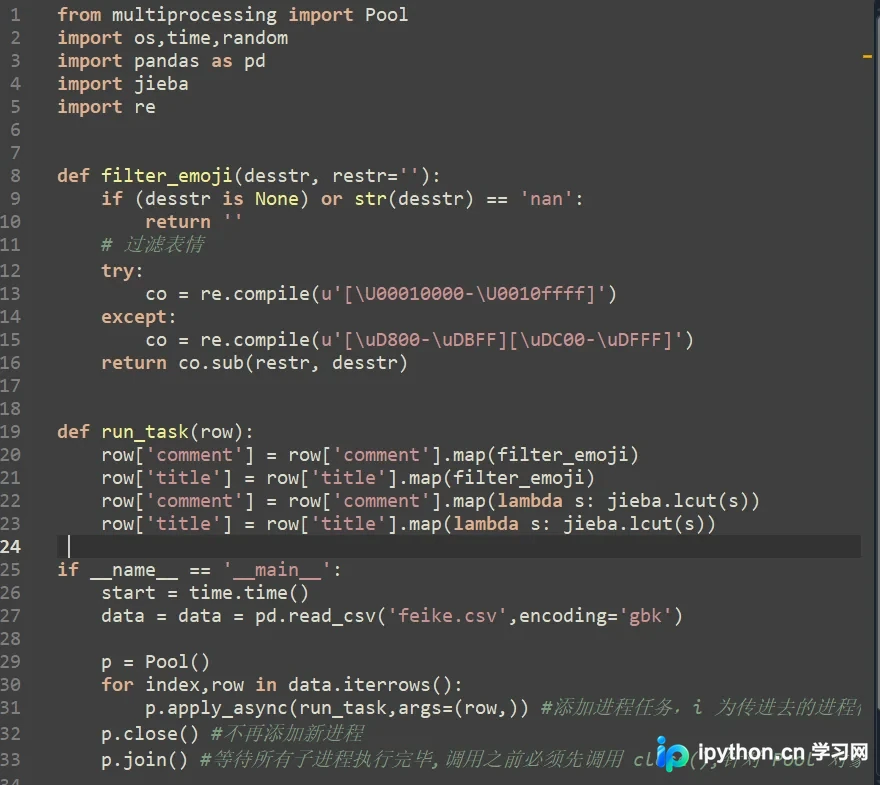
接下来,我们改用 Pandas 多进程库 pandarallel 的写法:
'''pandarallel 多进程'''
import jieba
import re
import time
import pandas as pd
from pandarallel import pandarallel
pandarallel.initialize(nb_workers=4)

def filter_emoji(desstr, restr=''):
    if (desstr is None) or str(desstr) == 'nan':
        return ''
    # 过滤表情
    try:
        co = re.compile(u'[\U00010000-\U0010ffff]')
    except:
        co = re.compile(u'[\uD800-\uDBFF][\uDC00-\uDFFF]')
    return co.sub(restr, desstr)

if __name__ == '__main__':
    start = time.time()
    data = data = pd.read_csv('feike.csv',encoding='gbk')
    data['comment'] = data['comment'].parallel_apply(filter_emoji)
    data['title'] = data['title'].parallel_apply(filter_emoji)
    data['comment'] = data['comment'].parallel_apply(lambda s: jieba.lcut(s))
    data['title'] = data['title'].parallel_apply(lambda s: jieba.lcut(s))
    end = time.time()
    print(end - start)
输出:
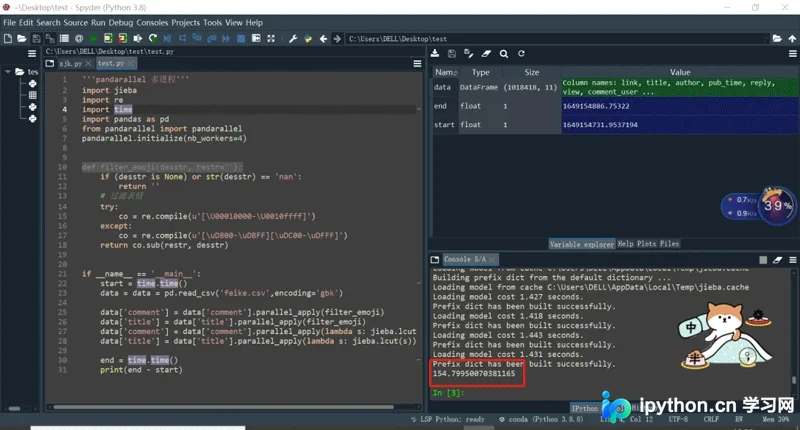
可以看到,改写后耗时为 154s(2min30s),相比单进程速度提升了一倍。关于 pandarallel 的更多用法,可查阅官方文档。
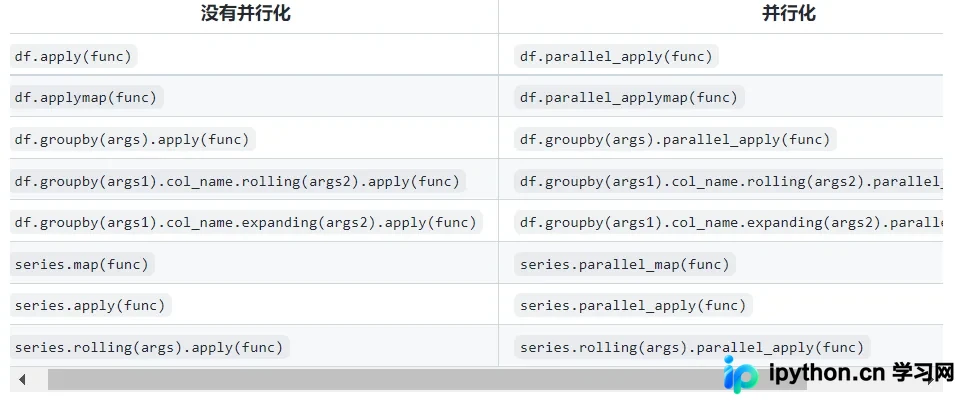
对应的多进程写法函数对照表,Pandas中的 apply,applymap,map 三个函数的区别,写对应的代码:
到此这篇关于Pandas 多进程处理数据提高速度的文章就介绍到这了,更多相关Pandas 多进程处理数据内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















