Python读取Word文档中嵌入Excel文件的两种方法
本文详解在Python中读取Word文档内嵌Excel文件的两种方案。第一种利用Windows COM接口调用宏,依赖Office或WPS环境;第二种通过解析Word ZIP结构中的OLE二进制文件,结合olefile与openpyxl实现跨平台快速读取。
2026-10-16
0



本文详解在Python中读取Word文档内嵌Excel文件的两种方案。第一种利用Windows COM接口调用宏,依赖Office或WPS环境;第二种通过解析Word ZIP结构中的OLE二进制文件,结合olefile与openpyxl实现跨平台快速读取。
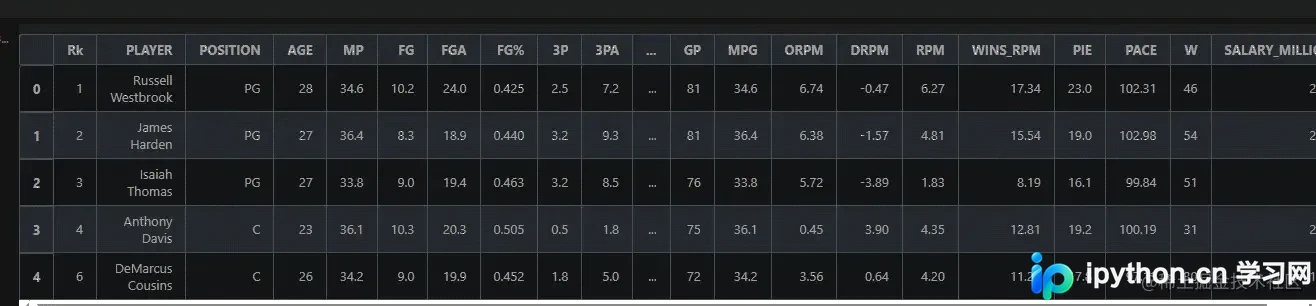
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
本文介绍如何利用Python的datetime和time库实现多脚本的定时运行。通过获取本地时间、设定执行窗口(如2点至6点)以及使用timedelta进行日期推移,构建一个持续运行的循环机制,确保脚本在指定时间段内自动执行并每日更新状态。
本文介绍Python中从HTML提取纯文本的三种常用方法:使用正则表达式移除标签、调用NLTK库的clean_html函数以及自定义HTMLParser解析器。文章对比了各方案的代码实现、依赖要求及适用场景,帮助开发者根据项目需求选择最高效的文本提取方案。
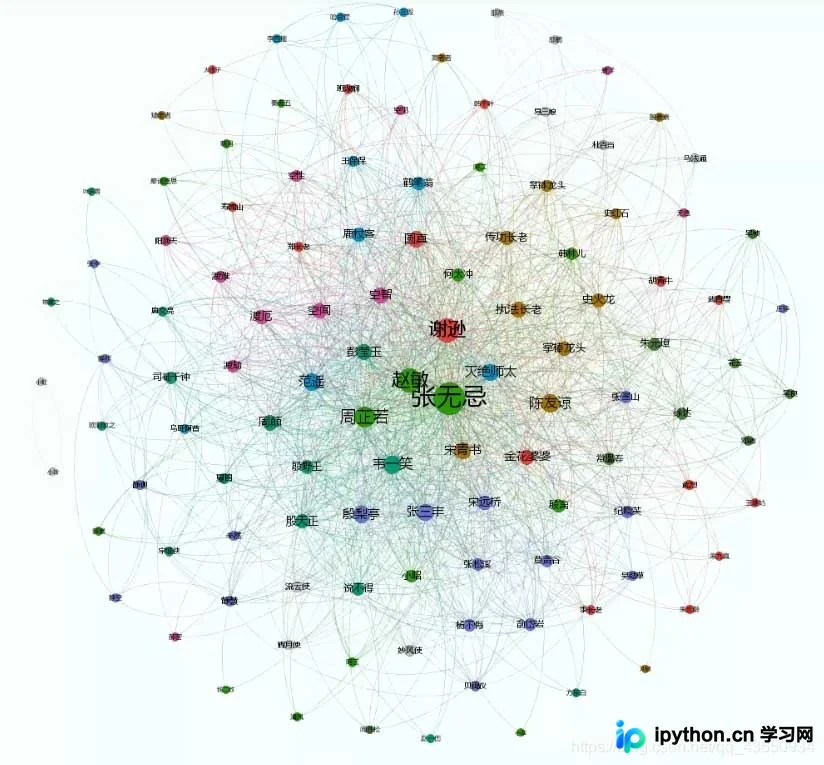
本文详细解析Python中如何构建共现矩阵并进行可视化。通过jieba分词提取关键词,利用二维数组统计词对共同出现次数,生成对称矩阵。文章提供了完整的Python代码实现,包括矩阵构建、清洗及占比计算,帮助开发者理解词组亲密度分析原理。
本文介绍如何使用Python进行图像颜色量化。通过调整图像尺寸优化处理速度,利用extcolors库提取主色并设置容差与数量限制,再将RGB转换为HEX代码。最终通过Matplotlib生成饼图与色板,直观展示图像中的主要色彩分布及占比。
本文介绍Python数据分析中Numpy库的核心使用方法。涵盖通过array、arange及random模块创建多维数组,详解dtype、ndim和shape属性以查看数据类型与维度,并简述ones、zeros等辅助创建函数,帮助初学者快速掌握Numpy基础操作。
本文详细介绍Python中openpyxl模块的使用方法,涵盖创建新Excel文件、读取现有xlsx工作簿、管理工作表(增删改查)以及单元格数据的定位与赋值。重点说明openpyxl仅支持.xlsx格式的读写限制,并提供完整的代码示例与操作参数说明。
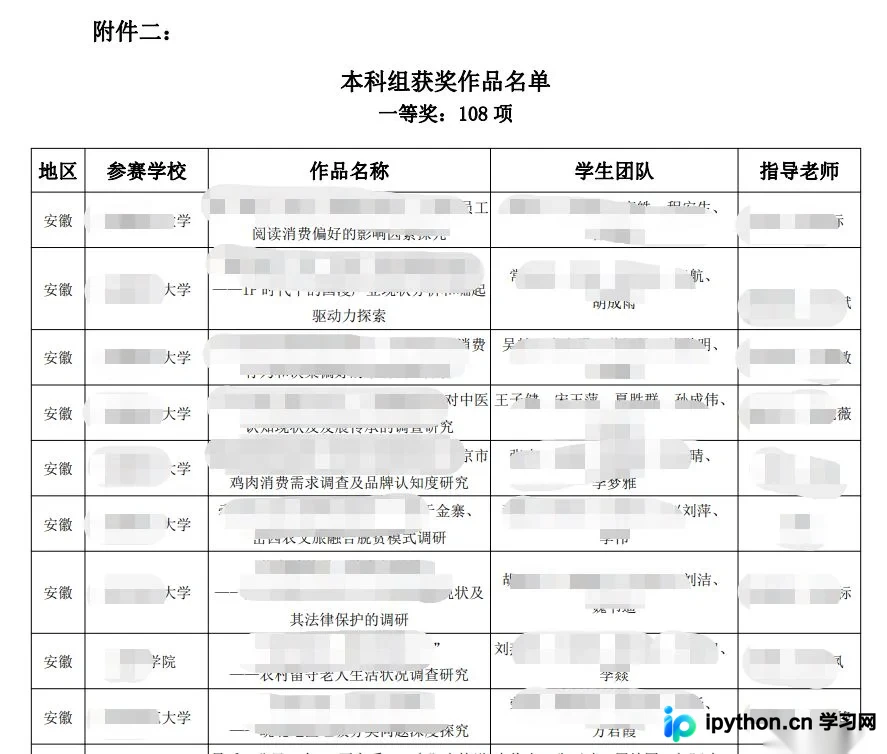
本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
本文详细介绍如何使用Python的xlrd和xlwt库进行Excel文件的自动化读写操作。重点讲解xlrd对xls/xlsx/xlsm文件的读取方法及xlwt对xls文件的写入限制,涵盖安装步骤、工作簿与工作表操作、单元格数据获取及保存技巧,帮助开发者高效处理Excel数据。
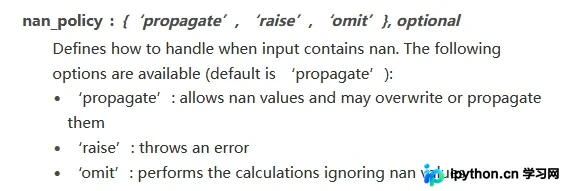
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
本文详解NumPy中数组叠加的多种实现方式,包括使用np.r_和np.c_进行行列堆叠,以及hstack和vstack函数的具体应用。重点解析一维数组在叠加时自动转为二维的机制,以及不同维度数组混合叠加时的行为差异,帮助开发者掌握高效的数组处理技巧。



