Vaex:秒开100GB+数据集的Python高性能分析库
本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。
2026-10-15
0



本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。
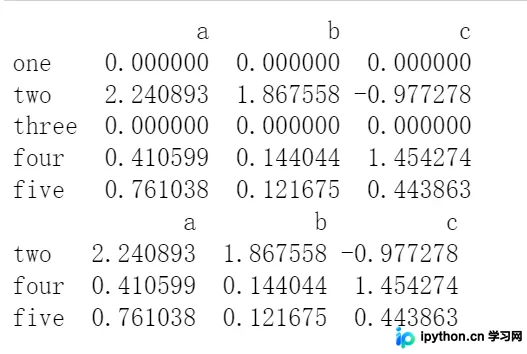
本文详细介绍在Python数据分析中删除DataFrame值为0行的多种方法。涵盖使用replace替换、loc筛选、dropna删除以及lambda函数应用,帮助开发者高效处理包含零值的数据集,提升数据预处理效率。
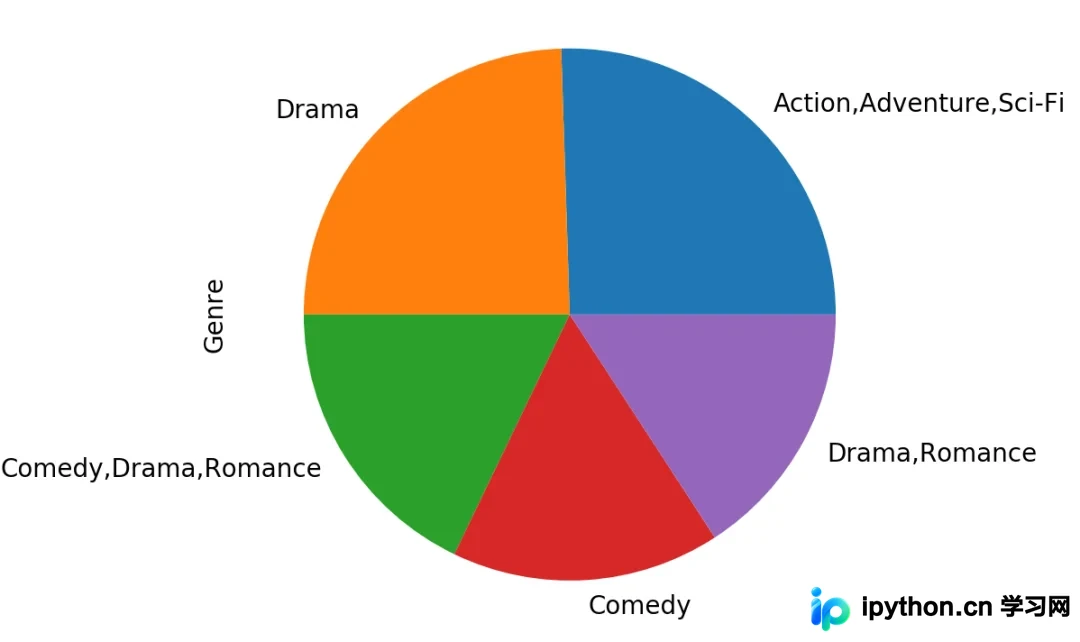
本文介绍Python中Pandas库的三个实用数据处理技巧。首先演示如何使用pop方法高效移除指定列并验证结果;其次讲解利用str.count方法统计标题中单词数量的方法;最后通过value_counts和matplotlib展示电影Genre的频次统计及Top5可视化分析,帮助开发者快速掌握数据清洗与基础统计操作。
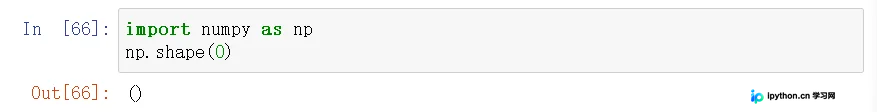
本文详解Python中numpy.core.fromnumeric模块下的shape()函数,用于读取矩阵长度与维度信息。通过解析输入参数为一维或二维矩阵时的返回值,以及利用shape[0]和shape[1]分别获取行数和列数的具体操作,帮助开发者掌握数组维度的判断方法。同时解释了Debug场景中shape(?,2,3)里问号代表的批处理个数含义,为数据分析提供基础支持。
本文介绍在R语言中处理TCGA等大规模生物信息数据的技巧,重点解决如何批量读取指定路径下的多个文本文件。通过遍历目录、提取元数据映射ID、使用data.table::fread加速读取,并结合for循环或lapply函数将各文件的第二列(如基因表达量)合并为一个完整的数据框,最终生成包含所有样本的表达式矩阵。
本文介绍如何使用Python库datacompy高效对比两个几乎相同的DataFrame,快速定位并直观展示数据差异。通过示例演示从环境安装到生成详细对比报告的全过程,帮助开发者轻松识别数据不一致之处。
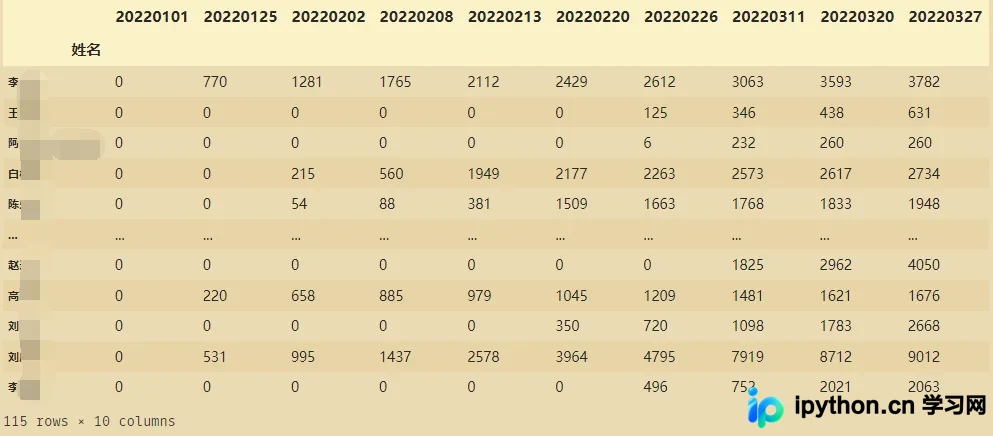
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
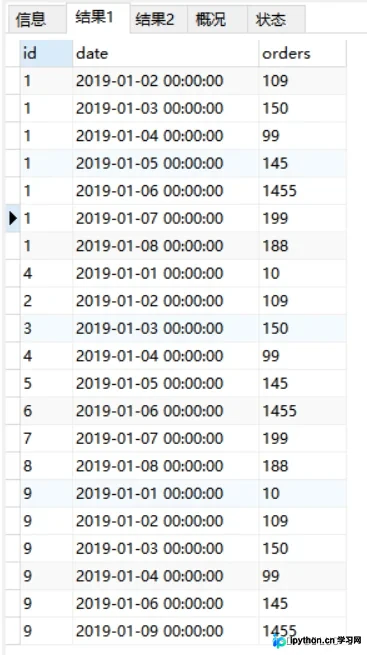
本文介绍使用 MySQL 窗口函数 ROW_NUMBER() 结合日期减法,解决“连续 N 天登录用户”查询的技术方案。通过为每日记录排序并减去天数,生成恒定日期分组,从而利用 COUNT 和 HAVING 筛选出满足连续天数要求的用户及起止时间。
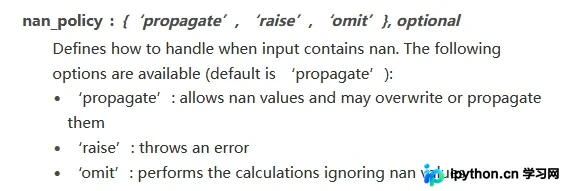
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
本文详细解析Python pandas库中pd.cut()与pd.qcut()两个数据离散化函数的区别。pd.cut()基于固定区间或数量进行等距划分,而pd.qcut()基于分位数确保各区间样本数量一致。文章通过具体代码示例对比了参数如bins、q、right、include_lowest及duplicates的使用场景,帮助开发者根据数据分布特征选择合适的离散化方法。
本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。
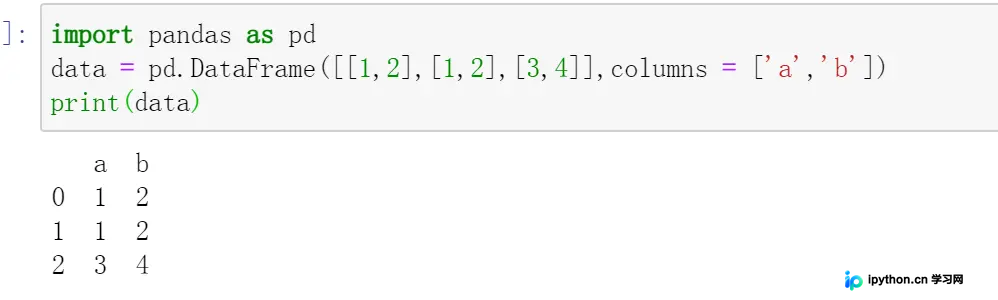
本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。



