


Python数据分析:删除DataFrame中值为0的行多种方法详解

发布时间:2026-10-16 |
9人浏览过
本文详细介绍在Python数据分析中删除DataFrame值为0行的多种方法。涵盖使用replace替换、loc筛选、dropna删除以及lambda函数应用,帮助开发者高效处理包含零值的数据集,提升数据预处理效率。
前言
在获取大量数据后,首要任务是进行数据预处理。当数据中存在空值或不符合预期的零值时,我们需要对这些数据进行删除或修改。以下将展示针对该示例进行数据删除和修改的具体操作。
>>> df
out[]:
   salary   age   gender
0   10000    23     男
1   15000    34     女
2   23000    21     男
3     0      20     女
4   28500     0     男
5   35000    37     男
一、数据处理
首先介绍df.replace()方法,该方法可将“男”替换为1,“女”替换为0。
>>> df.replace(["男", "女"], [1, 0])
out[]:
   salary   age   gender
0   10000    23     1
1   15000    34     0
2   23000    21     1
3     0      20     0
4   28500     0     1
5   35000    37     1
其次,可以使用pd.DataFrame.loc()方法来指定筛选出列中数据不为0的行。
>>> df = df.loc[~((df['salary'] == 0) | (df['age'] == 0))]
>>> df
out[]:
   salary   age   gender
0   10000    23     1
1   15000    34     0
2   23000    21     1
3   35000    37     1
此外,还可以采用另一种写法:
df = df.loc[df['salary'] * df['age'] != 0]
二、删除某行方法的使用
1. 删除全行均为0的行
具体代码如下:
>>> df.loc[~(df==0).all(axis=1)]从代码对称性角度看,也可以这样编写:
>>> df.loc[(df!=0).any(axis=1)]或者使用dropna方法来执行删除操作:
>>> new_df = df[df.loc[:]!=0].dropna()2. 用nan替换零,然后删除所有数据均为nan的行,最后再将nan替换回零。
具体代码如下:
import numpy as np
df = df.replace(0, np.nan)# 把0替换成nan
df = df.dropna(how='all', axis=0)# 删除所有为nan的行
df = df.replace(np.nan, 0)# 再把nan替换成0
3. 删除某行中特定值为0的行
具体代码如下:
>>> df= df[df['salary'] != 0]4. 使用lambda函数来删除行
具体代码如下:
import pandas as pd
import numpy as np

np.random.seed(0)

df = pd.DataFrame(np.random.randn(5,3),
                  index=['one', 'two', 'three', 'four', 'five'],
                  columns=list('abc'))

df.loc[['one', 'three']] = 0 # 把第一行和第三行改为0

print(df)
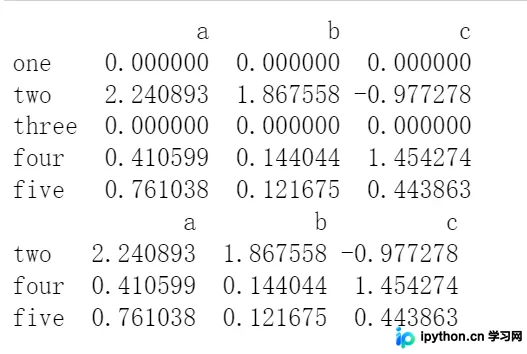
print(df.loc[~df.apply(lambda row: (row==0).all(), axis=1)])
运行输出结果为:
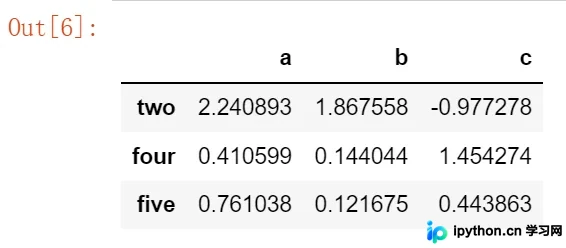
若需删除任何行中所有值为0的列,可参考以下操作:
new_df = df[df.loc[:]!=0].dropna()
new_df
运行输出结果为:
总结
至此,关于Python数据分析中如何删除value=0行的介绍已完成。如需了解更多相关Python删除value=0行的内容,请搜索本站历史文章或继续浏览后续相关文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















