PHP校验ISBN码的函数代码
本文提供基于PHP实现的ISBN-10与ISBN-13格式校验函数。核心逻辑通过计算前N位数字的加权和并取模,推导最后一位校验码,并与实际输入进行比对。代码涵盖权重计算、校验码生成(含ISBN-10的'X'处理)及长度验证,可直接调用以判断图书编码的结构合法性。
2026-10-15
0



本文提供基于PHP实现的ISBN-10与ISBN-13格式校验函数。核心逻辑通过计算前N位数字的加权和并取模,推导最后一位校验码,并与实际输入进行比对。代码涵盖权重计算、校验码生成(含ISBN-10的'X'处理)及长度验证,可直接调用以判断图书编码的结构合法性。
TypeScript 的类型缩小是指在特定执行路径中缩小变量类型的过程,主要依赖类型保护机制。本文详解四种常用保护符:typeof 用于基础类型区分,平等比较利用 switch/== 实现字面量收窄,instanceof 处理对象实例判断,in 操作符基于属性存在性区分类别。通过具体函数示例掌握这些语法,提升代码安全性与智能提示准确性。
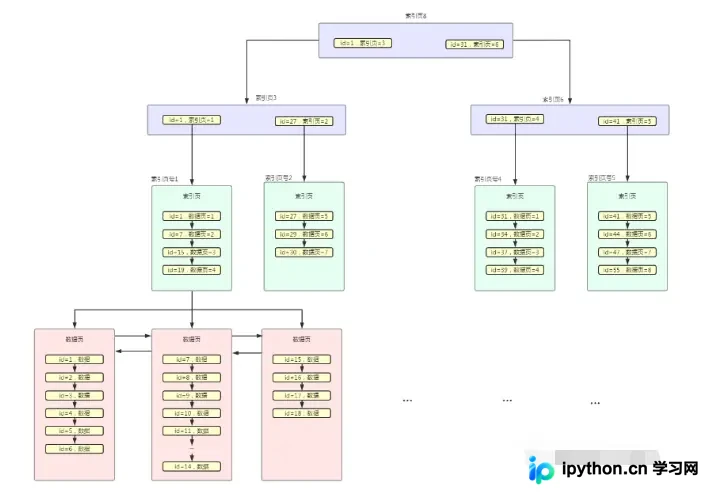
在MySQL开发中,即使建立了指索,查询依然缓慢往往是因索引失效所致。本文深入剖析导致索引失效的七种典型场景:字段类型隐式转换、表达式计算、使用内置函数、左模糊匹配、违背最左前缀原则、OR条件缺失索引以及IN/NOT IN的影响。通过EXPLAIN分析执行计划,可精准定位问题并制定优化策略。
本文介绍如何使用Go语言的singleflight机制解决热点Key缓存失效导致的数据库冲击问题。文章通过代码示例详细阐述了其去重合并请求的核心原理,展示了如何确保同一时刻对同一Key只执行一次数据获取操作,从而降低系统负载并优化高并发场景下的性能表现。
本文详细解析R语言中常用的apply系列函数,包括按行列操作的apply、返回列表的lapply、简化返回类型的sapply、分组聚合的tapply以及多参数并行的mapply。通过iris数据集等真实示例,说明各函数的输入参数、运行逻辑及返回值类型差异,帮助快速掌握数据批量处理技巧。
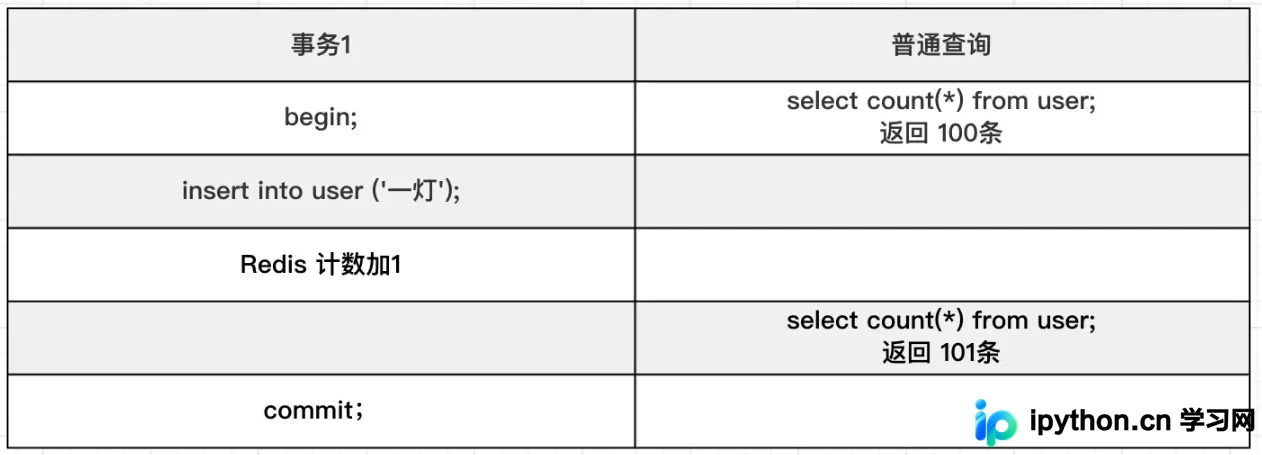
针对MySQL InnoDB引擎下count(*)统计耗时过长的问题,分析MyISAM与InnoDB的行数记录机制差异。介绍使用show table status估算行数的快速方案,对比count(*)、count(id)及count(字段)的性能差异,并指出Redis等缓存方案在处理高并发事务时的局限性,提供实用的查询优化建议。
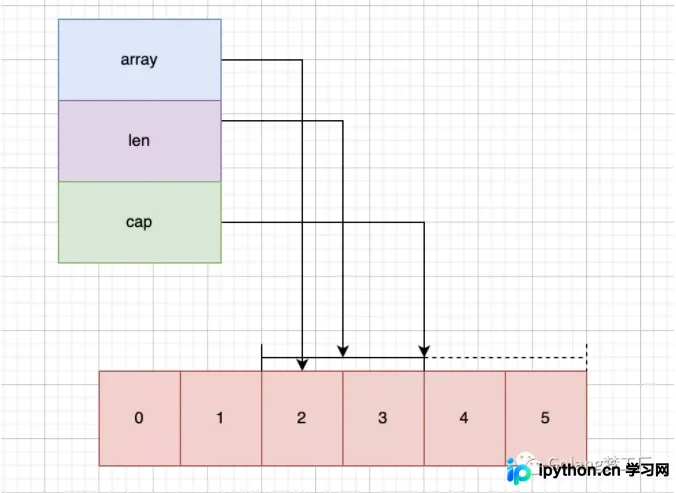
本文深入解析Go语言中切片的常见面试考点。涵盖切片与数组的区别、切片内部结构对性能的影响、零值/空值/Nil切片的辨析,重点剖析growslice源码揭示的2倍及1.25倍扩容逻辑,并详细演示参数传递时的引用失效陷阱以及Range遍历时的值拷贝误区,帮助开发者避开底层隐患。
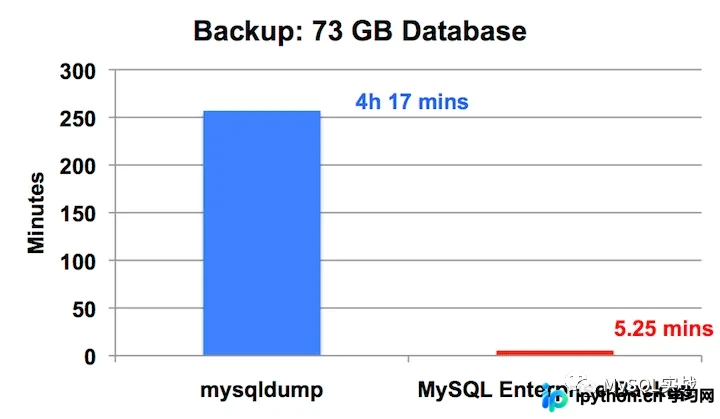
选择MySQL备份工具需综合评估RTO、RPO及存储成本。物理备份速度快但文件大,逻辑备份灵活且移植性强。XtraBackup适合热备全量数据,mysqldump和mydumper常用于逻辑导出。通过定期有效性检测和优化恢复流程,可显著降低数据丢失风险和服务中断时间。
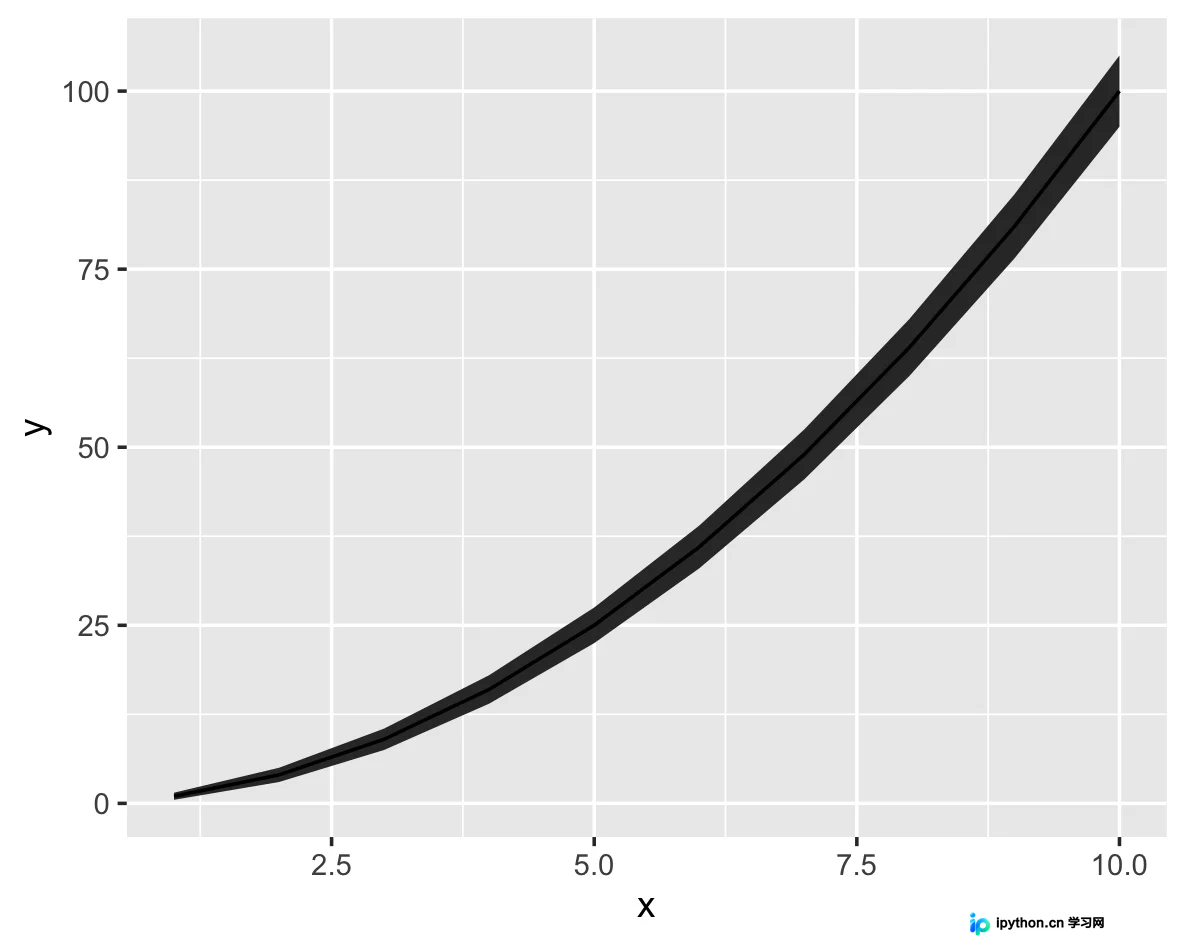
本文详解如何利用 R 语言的 ggplot2 库绘制包含置信区间的折线图。针对单组数据集,演示了 geom_ribbon() 基础用法;针对多组情况,分别讲解了通过 factor 分组和手动指定 aes 参数的两种方法。此外,还提供了调整透明度、线型及去除边框的完整美化代码,帮助开发者快速输出专业的统计图形。
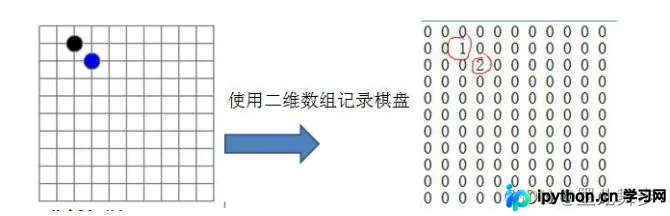
当二维数组中包含大量默认值(如0)时,使用稀疏数组可大幅减少存储空间。本文介绍稀疏数组的原理,并通过Go语言实现将11x11的五子棋棋盘转换为稀疏数组进行存盘,再从稀疏数组还原回原始棋盘,展示具体的代码逻辑与执行流程。
深入解析C++中结构体与类的本质差异及函数调用的三种传参方式。重点对比值传递、引用传递与指针传递的内存地址变化及性能优劣,阐明 struct 默认公有与 class 默认私有的权限控制区别,并提供标准的头文件.h与源文件.cpp代码组织规范,帮助开发者写出高效且符合规范的C++代码。
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。