


R语言apply系列函数实例详解

在R语言数据分析中,批量处理矩阵、数据框或列表是常见需求。apply系列函数提供了简洁高效的运算方式。本文深入解析apply、lapply、sapply、tapply和mapply五种核心函数的定义、操作顺序、参数设置及结果判断方法,结合鸢尾花(iris)等经典数据集演示具体代码,帮助用户根据数据类型正确选择最合适的函数。
一、apply():针对矩阵或数组的行/列运算
当需要对二维数据结构(如矩阵或数据框)进行整体的行或列统计时,apply() 是最基础的选择。它能够将指定函数应用到数组的边缘维度上。
第1步:理解apply参数含义
apply() 的核心参数如下:
X:目标数组或矩阵对象。MARGIN:指定应用方向。1表示按行计算,2表示按列计算。FUN:要执行的函数,例如sum(求和)、mean(均值)等。
第2步:执行矩阵行列求和测试
构建一个包含数字1至9的矩阵,分别计算其行和与列和。
s <- matrix(1:9, ncol = 3)
# 按行(MARGIN=1)求和
apply(s, 1, sum)
# 按列(MARGIN=2)求和
apply(s, 2, sum)
预期将得到以下数值序列:
[1] 12 15 18
[1] 6 15 24
第3步:应用于内置数据集 iris
对 iris 数据集中前四列数值型数据进行列求和,验证其在实际数据框上的表现:
apply(iris[, 1:4], 2, sum)控制台输出结果为各变量的总和:
Sepal.Length Sepal.Width Petal.Length Petal.Width
876.5 458.6 563.7 179.9
注:R语言也提供了 rowSums()、colMeans() 等专用函数用于特定场景的行列运算。
二、lapply():统一返回列表结构的遍历器
若输入对象为列表、向量或数据框,且希望保持结果的原始结构一致性,lapply() 总是返回列表(list)。适用于需要对每一列提取单一标量指标的场景。
第1步:使用lapply计算均值
以 iris 数据为例,直接调用 lapply() 获取每列数据的均值:
lapply(iris[, 1:4], mean)该操作会返回一个命名列表,包含四个数值结果(约等于:5.84, 3.06, 3.76, 1.20)。
第2步:将结果转换为向量
若后续需要将该列表转换为标准向量进行处理,可使用 unlist() 函数:
unlist(
 X = lapply(iris[, 1:4], mean),
 recursive = FALSE,
 use.names = TRUE
)
结果将呈现为一个带名称标签的单维向量,保留原有的列名对应关系。
三、sapply():智能简化的Apply
sapply() 是 lapply() 的封装形式。它在底层执行 lapply 后,尝试简化(simplify)结果。如果结果是多个单值元素,则自动合并为向量;若是多个相同长度的向量组合,则转置为矩阵。
第1步:生成简化后的向量结果
继续对 iris 前四列使用 sapply() 求和:
sapply(iris[, 1:4], sum)此处不再返回嵌套的列表,而是直接打印出一组带有变量名的纯数值结果。
第2步:产生多值映射成矩阵的情况
当传递的函数对每个元素返回多个结果时,sapply() 会自动将其排列成矩阵。
x <- sapply(iris[, 1:4], function(x) { x > 3 })
class(x)
因为匿名函数 function(x) { x > 3 } 实际上是对向量进行逐元素比较并返回布尔值向量,所以最终生成的 x 是一个巨大的矩阵。可以使用以下图片查看其完整的布尔矩阵分布: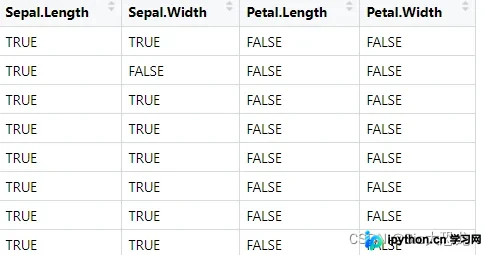
四、tapply():基于分组的向量聚合
当需要根据某个分类变量(INDEX)将数据进行分组,并对每个分组单独应用函数时,应使用 tapply()。这是典型的“拆分-应用-合并”模式中的“拆分”工具。
第1步:理解索引重复分配机制
首先观察基础数值分配:将1到10分为两组。
tapply(1:10, rep(1:2, 5), sum)其中 rep(1:2, 5) 生成了长度为10的因子 c(1, 2, 1, 2, 1, 2, 1, 2, 1, 2)。奇数位置的数被归入组1,偶数位置归入组2。求和后分别得到25和30。
第2步:利用Species字段统计不同品种花瓣长度
利用 iris 数据集中的 Species 列作为分组依据:
tapply(iris$Sepal.Length, iris$Species, sum)系统按照 setosa、versicolor、virginica 三种花色分别汇总其花萼长度,得到三个数值结果。
第3步:多维索引下的矩阵式分组
在更复杂的场景中,可以传入由多个因子构成的列表来实现二维分组统计。假设有四个季节、两个性别(male/female)的销售数据,通过位置索引建立多重分组条件:
m <- matrix(1:8, ncol = 2,
            dimnames = list(c("春","夏","秋","冬"),
                            c("female","male")))
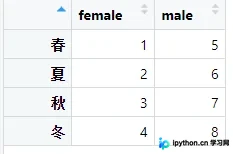
接着创建复合分组向量进行跨维度聚合:
tapply(m, list(c(1,1,2,2,1,1,2,2), c(1,1,1,1,2,2,2,2)), sum)上述代码构建了一个类似于透视表的分组逻辑,将原始矩阵元素重新归类计算,获得交叉维度的汇总数值。
五、mapply():支持多参数并行处理的Apply
当需要同时向一个函数传入多个等长向量(或多组列表数据),并将它们打包传递给函数执行时,mapply() (multivariate apply) 十分合适。
第1步:对多列数据同步执行Sum
虽然本例中仅演示了对单列集的应用,但其原理是将 iris 的四列视为四个独立的输入序列,传给 sum 函数:
mapply(sum, iris[, 1:4])此时产生的结果与使用 sapply() 的效果完全一致,均为各列的总计和。在处理含有多个自变量需逐一代入方程计算的场景中,mapply 比循环更加高效直观。
总结
以上就是R语言apply系列函数:apply lapply sapply tapply mapply用法与区别解析的详细内容,更多关于R语言apply函数数据处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















