


MySQL InnoDB中count(*)计数慢的优化思路与替代方案

随着数据量增长,MySQL InnoDB引擎中的count(*)操作可能成为严重的性能瓶颈。本文剖析了不同存储引擎在行数统计上的底层逻辑,评估了使用系统命令估算行数的可行性,对比了多种聚合函数的执行效率,为解决复杂场景下的计数性能问题提供清晰的技术路径。
InnoDB计数慢的本质:行锁与MVCC的影响
在探讨解决方案前,需先明确为何count(*)在数据量大时会变慢。这与存储引擎的设计密切相关:
- MyISAM引擎:会将表的总行数单独保存在磁盘文件中。因此,
select count(*)时可直接读取该数值,速度极快。但在存在WHERE条件的查询中,由于需要满足筛选条件,无法直接返回预存值,仍需遍历累加。 - InnoDB引擎:为支持事务(ACID特性),引入了多版本并发控制(MVCC)和行级锁。不同的事务可能对同一时刻的数据有不同视图。如果强行在内存中维护一个“精确的实时总数”,每次插入或更新都要进行复杂的同步操作,这会极大降低吞吐量。
因此,InnoDB在执行 count(*) 时,只能利用辅助索引,从叶子节点逐一遍历并过滤空值(对于非主键字段),这在大表上必然导致I/O增多和执行时间延长。
方案一:利用 SHOW TABLE STATUS 估算行数
如果对数据的绝对精度要求不高(例如显示网站大概有多少用户、商品库存量级等),可以直接调用MySQL内置命令获取估算值。
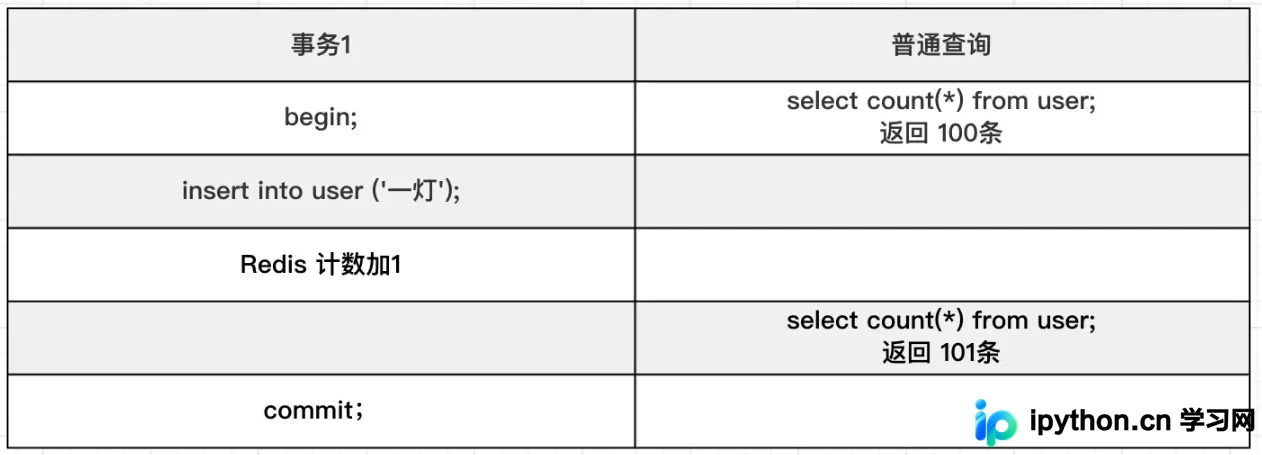
SHOW TABLE STATUS LIKE 'your_table_name';
执行后,查看结果集中的 Rows 列即为预估行数。官方文档指出,这是通过B+树叶子节点的平均值计算得出的。
- 优点:毫秒级响应,不阻塞业务线程,不受事务隔离级别影响。
- 缺点:结果仅为估算值,误差通常在合理范围内(如百万级数据可能有少量偏差),不适用于涉及金额计算的精准统计。
- 适用场景:仪表盘概览展示、数据总量监控等允许有一定误差的场景。
方案二:理解COUNT系列的性能差异
在实际开发中,开发者常混淆 count(*)、count(id)、count(常量) 和 count(字段名) 的区别。在InnoDB 5.7及以上版本中,MySQL对 count() 进行了显著优化。
-- 定义测试表结构
CREATE TABLE `user` (
  `id` int NOT NULL AUTO_INCREMENT COMMENT '主键',
  `name` varchar(100) DEFAULT NULL COMMENT '姓名',
  `age` tinyint NOT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_name` (`name`),
  KEY `idx_age` (`age`)
) ENGINE=InnoDB;

-- 查看执行计划,观察Count函数选择了哪个索引
EXPLAIN SELECT COUNT(*) FROM user;
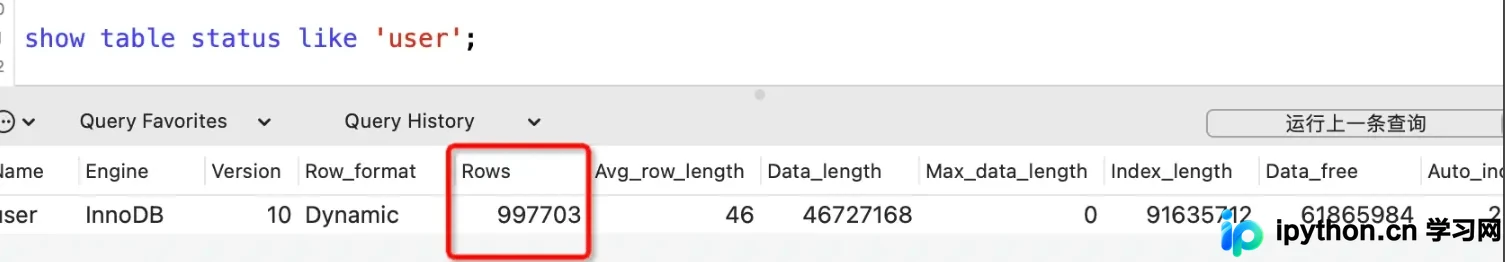
通过执行计划(Explain)可以观察到,即使使用的是 COUNT(*),优化器也会自动选择数据量最小的那个**辅助索引(Secondary Index)**来完成遍历,而不是回表查询整行数据。这是因为辅助索引比聚簇索引更紧凑,扫描速度更快。
各COUNT方式的现代表现对比:
count(*)/count(1):现代InnoDB引擎下,两者等价且效率最高,均会自动选择最优索引。count(id):与count(*)效果一致(假设id是主键索引中较小的一列或使用了辅助索引)。count(特定字段):仅统计该字段不为NULL的记录。如果字段可被设为NOT NULL,其性能可与count(*)持平;若存在大量NULL值,会因额外的判断逻辑产生微小开销,但不再需要回表(若建立了覆盖索引)。
结论:请直接使用 SELECT COUNT(*),无需刻意更换写法。避免使用低效的 SELECT *,因为前者只计数,后者需检索所有列数据。
为什么不建议用Redis做计数器?
部分架构师曾尝试将数据库的总数同步到 Redis 中进行查询,但这在高并发事务系统中往往带来更大的坑:
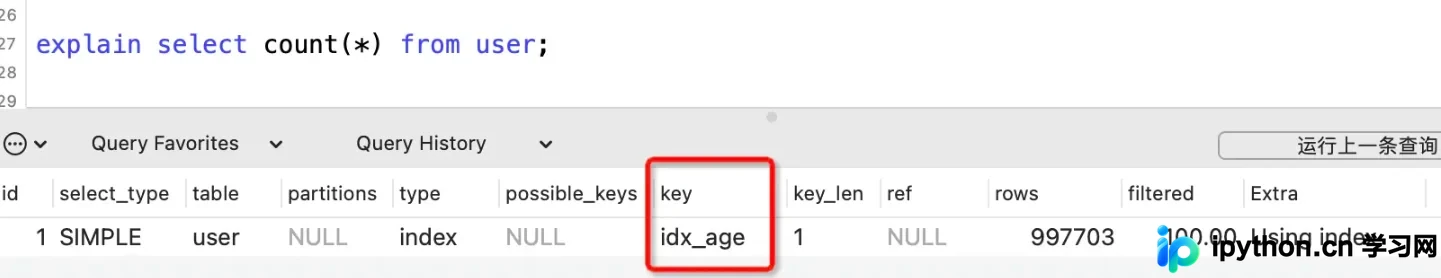
主要风险如下:
- 数据一致性难题:在事务提交前修改了 Redis 的数量,会导致其他会话发生“脏读”;若在事务提交后才修改,则在高并发竞争下极易丢失更新(Aba-Bcb问题)。
- 操作复杂度:虽然可用 Lua 脚本保证原子性,但必须兼顾数据库事务的回滚(一旦DB事务失败,Redis数量还得退回去),系统变得极其脆弱。
- 持久化隐患:Redis 作为非关系型持久化组件,其核心定位不是承载全量的业务主数据。依靠它来充当“真实”的业务计数器,违背了CAP定理的选择初衷。
终极优化建议与总结
当 count(*) 成为真正的主线瓶颈时(而非偶尔运行),单纯优化SQL已无意义,应从架构层面解决:
- 异步汇总/物化视图:开启Binlog,通过 Canal 监听数据库变化,实时推送至 ClickHouse 或 Elasticsearch 进行实时统计分析,前端展示走这些宽表而非OLTP的主库。
- 分区表结合估算:对超大数据表按日期分区,利用上述
SHOW TABLE STATUS快速获取大致范围。 - 读写分离 + 延迟容忍:如果系统允许秒级的查询延迟,可从主库切分出的只读副本中查询近似值。
综上所述,面对 MySQL count 慢查询问题,首先应确认是否为高频刚需;若非如此,善用 MySQL 自身提供的估算接口往往是最经济高效的解法。
以上就是MySQL select count(*)计数很慢优化方案的详细内容,更多关于MySQL InnoDB性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















