基于Java与SQL Server的简易图书管理系统开发指南
本文详细演示如何使用Java语言结合JDBC技术连接SQL Server数据库,构建一个具备书籍浏览、查询、新增、借还及删除功能的简易图书管理系统。内容涵盖环境配置、核心SQL语句编写及资源释放规范,帮助开发者快速掌握Java数据库交互的核心逻辑。
2026-10-15
0



本文详细演示如何使用Java语言结合JDBC技术连接SQL Server数据库,构建一个具备书籍浏览、查询、新增、借还及删除功能的简易图书管理系统。内容涵盖环境配置、核心SQL语句编写及资源释放规范,帮助开发者快速掌握Java数据库交互的核心逻辑。
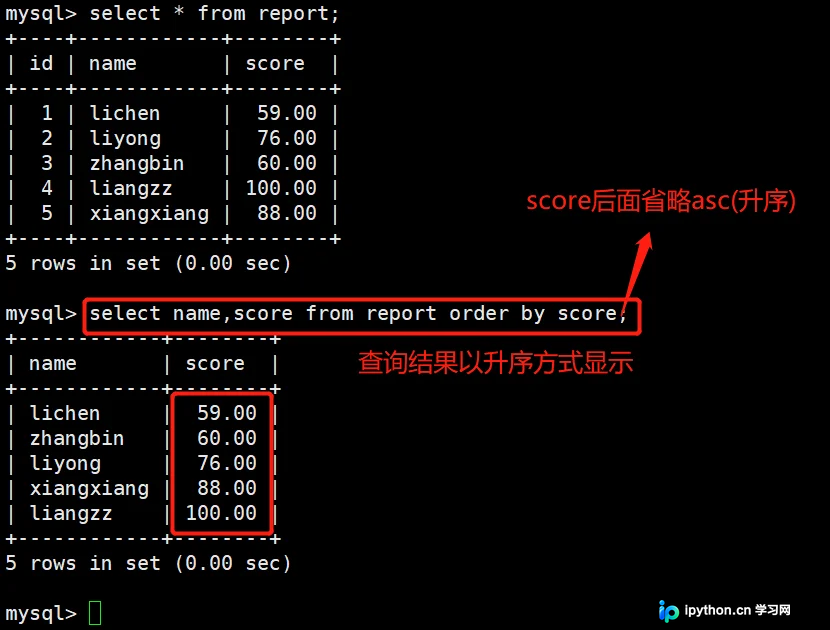
本文详细介绍MySQL数据库中常用的高级SQL查询语句,包括如何使用ORDER BY进行单字段或多字段排序,利用AND/OR实现复杂条件过滤,通过DISTINCT去除重复记录,结合聚合函数使用GROUP BY进行数据分组统计,以及运用LIMIT限制返回结果数量。同时涵盖别名设置与LIKE通配符模糊匹配等实用技巧,帮助开发者高效处理数据集。
本文详细介绍使用Flask框架搭建轻量级API服务的完整流程。内容涵盖数据库配置、全局DB对象定义及数据转码工具类的构建。重点演示了五种SQL查询接口的实现方式,包括无参查询、常规参数传递及复杂的IN参数处理。针对IN参数在URL中的多种传值形式(逗号分隔或多次重复键),提供了可靠的解析方案,并展示了标准化的错误处理与JSON响应返回机制,旨在为开发者提供一套可直接复用的API开发模板。
解决 SQL Server 处理大量数据时的性能瓶颈。本文介绍一个通用的分页存储过程 execByPage,通过动态生成带标识列的临时表,兼容原有 SQL 语句,无需修改应用层代码即可高效返回指定页数据及总记录数,避免游标和复杂 ID 依赖,显著提升大数据量查询速度。
本文详细解析SQL中UNION与UNION ALL的核心区别:前者自动去重并排序,后者保留所有记录且性能更高。通过具体查询示例说明字段数量、数据类型及顺序的一致性要求,重点剖析在聚合统计场景下因类型混淆导致的数值累加错误,并提供避免此类陷阱的实操建议。
本文详细解析MySQL中慢SQL优化的完整流程,涵盖如何开启并查看慢查询日志,通过mysqldumpslow分析高频耗时语句,以及SQL编写层面的核心优化规范。同时探讨慢SQL对数据库I/O资源及应用体验的影响,明确主从架构下的治理优先级,为排查和解决数据库性能瓶颈提供实用思路。
本文详解SQL Server中两种常用的表数据复制语句:INSERT INTO SELECT和SELECT INTO。前者需目标表已存在,支持指定列或全部列复制;后者自动创建目标表,但要求目标表不存在且通常只能执行一次。通过具体代码案例对比两者优先级、适用场景及语法细节,帮助开发者高效进行数据备份与迁移。
本文详解SQL Server中行列互转的两种核心场景。行转列推荐使用PIVOT操作或动态CASE WHEN聚合,适用于将多行记录合并为单行宽表;列转行推荐使用UNPIVOT或UNION ALL拼接,适用于将宽表数据还原为长表格式。文章提供从SQL Server 2000到2005+版本的动态SQL生成逻辑及静态示例,涵盖静态列、动态列及聚合统计(如总和)的实现细节。
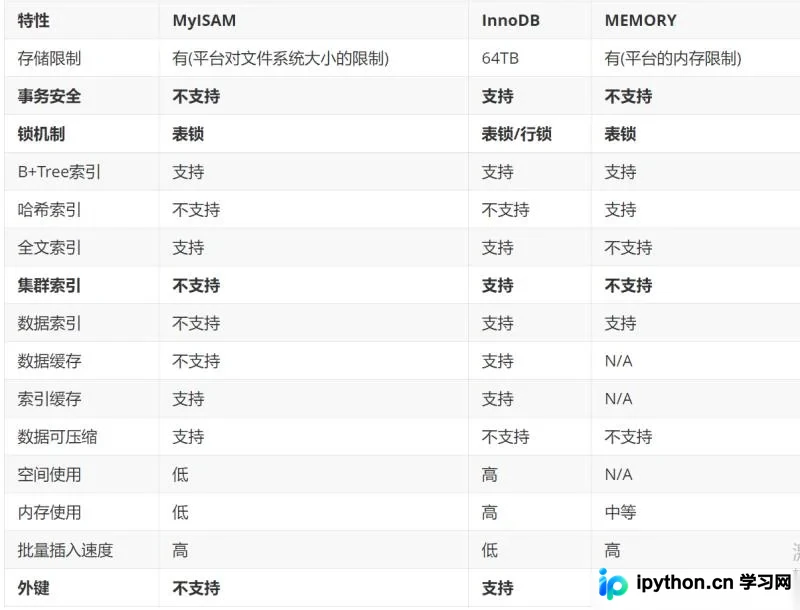
面对数据量激增与高并发挑战,MySQL 性能优化需从存储引擎选择、索引结构设计及集群架构入手。本文详解 InnoDB 与 MyISAM 的适用场景,剖析 B+Tree 索引原理,并提供避免全表扫描、合理使用分页等核心 SQL 优化方案,助力构建高可用、高并发的数据库系统。
本文介绍在Python中连接SQL Server数据库并获取指定表所有列名的两种方法。第一种方法通过SysColumns系统视图获取,但结果无序;第二种方法利用INFORMATION_SCHEMA.COLUMNS视图,可精确提取COLUMN_NAME字段。文章提供了完整的连接代码、SQL语句及fetchall()等结果获取方式,帮助开发者实现数据库元数据查询。
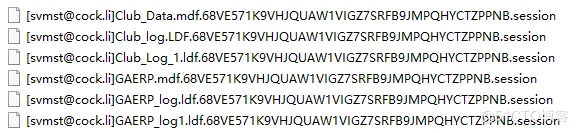
当SQL Server数据库遭遇加密攻击且MDF、LDF文件名被修改时,直接附加通常失败。本文介绍基于8K页大小的底层分析原理,通过查找数据库页起始标志01 0F,结合结构错开的备份文件提取未加密页进行修复的技术方案,实现数据抢救。
本文详解如何在 SQL Server 中为外部账号仅授予创建表的权限。针对直接授权导致的 DROP/ALTER 风险,提供两种解决方案:一是使用 DDL 触发器拦截非建表操作;二是利用独立 Schema 实现物理隔离。通过具体代码演示,帮助 DBA 在保障数据安全的的前提下实现精细化的权限控制。