Python索引与切片核心机制:从基础到NumPy/Pandas实战避坑
本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
2026-10-16
0



本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
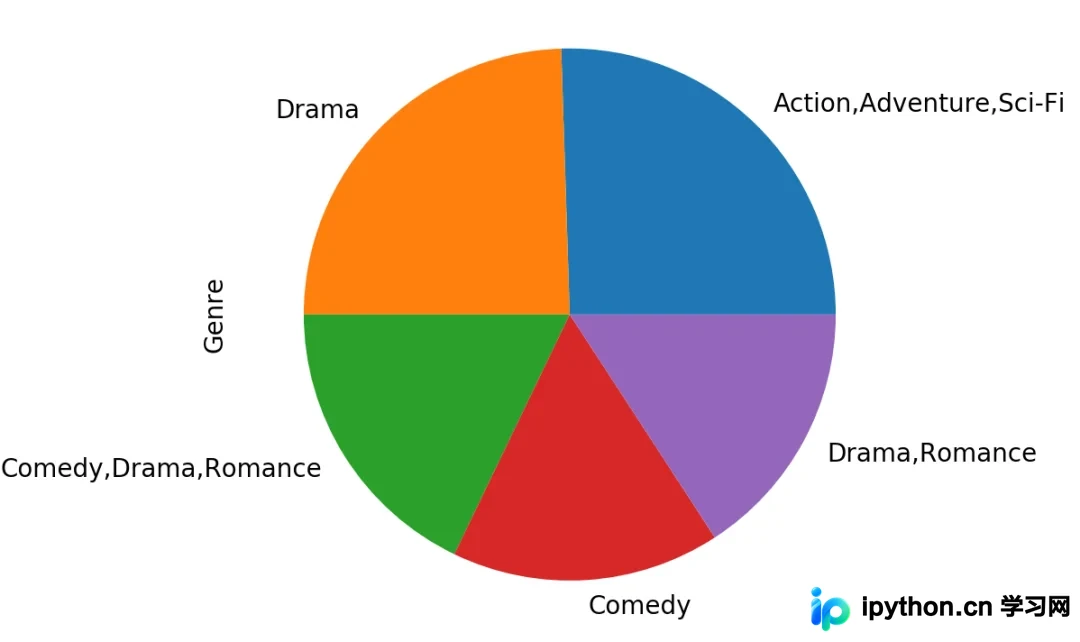
本文介绍Python中Pandas库的三个实用数据处理技巧。首先演示如何使用pop方法高效移除指定列并验证结果;其次讲解利用str.count方法统计标题中单词数量的方法;最后通过value_counts和matplotlib展示电影Genre的频次统计及Top5可视化分析,帮助开发者快速掌握数据清洗与基础统计操作。
本文详细介绍Python中处理CSV文件的两种核心方式。首先解析内置csv库的reader与DictReader用法,涵盖delimiter、quotechar等关键参数及处理含逗号字段的技巧;随后深入Pandas库,演示如何快速读取、格式化日期及写入CSV文件,提供从基础到进阶的完整代码示例。
本文详解Python Pandas中DataFrame.apply函数的多列与多行操作技巧。重点解析axis=1对列操作与axis=0对行操作的差异,演示如何通过result_type="expand"或zip打包实现单行生成多列,以及跨行计算新数据的方法。
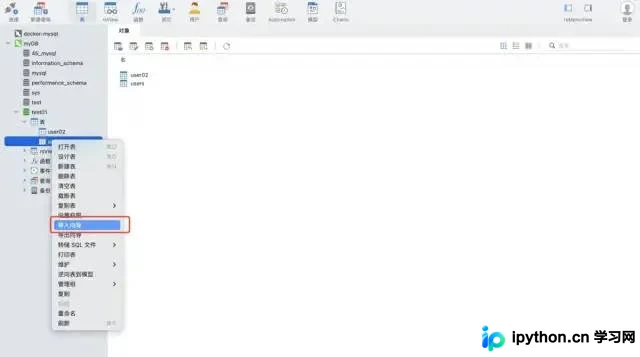
本文系统分享将千万级数据写入 MySQL 的两种场景及对应方案。针对非频繁写入,推荐使用 Navicat 导入向导;针对增量自动化写入,对比了 Pymysql 与 Pandas+SQLAlchemy 两种 Python 实现方式。测试显示,Pandas 方案仅需五行代码且耗时约 4 分钟,远优于 Pymysql 的 12 分 47 秒,且无需预先建表,推荐作为高效首选。
本文系统整理了Python中Pandas库的45个高频实用命令,涵盖数据读取、类型转换、缺失值处理、时间序列分析及数据可视化等核心场景。通过具体代码示例,帮助开发者快速掌握高效处理大型数据集的方法,提升数据分析与建模效率。
本文详细总结Pandas中对数值变量进行分箱(离散化)的四种常用方法。通过合成学生成绩数据,演示如何使用between结合loc、pd.cut、pd.qcut以及value_counts实现不同场景下的分箱需求,包括固定区间划分、等频分箱及基于统计量的分组,并对比各方法的参数设置与结果差异。
本文详细介绍在Python数据分析中删除DataFrame值为0行的多种方法。涵盖使用replace替换、loc筛选、dropna删除以及lambda函数应用,帮助开发者高效处理包含零值的数据集,提升数据预处理效率。
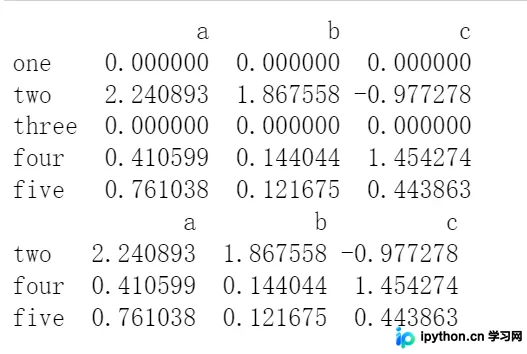
本文详细解析Python pandas库中pd.cut()与pd.qcut()两个数据离散化函数的区别。pd.cut()基于固定区间或数量进行等距划分,而pd.qcut()基于分位数确保各区间样本数量一致。文章通过具体代码示例对比了参数如bins、q、right、include_lowest及duplicates的使用场景,帮助开发者根据数据分布特征选择合适的离散化方法。
本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。
本文整理了八个Python数据清洗的常见场景及对应代码,涵盖删除多列、转换数据类型、分类变量数值化、检查缺失值、处理字符串异常及空格、条件拼接字符串以及时间戳转换。通过封装函数,帮助开发者高效完成数据预处理工作,提升数据分析效率。
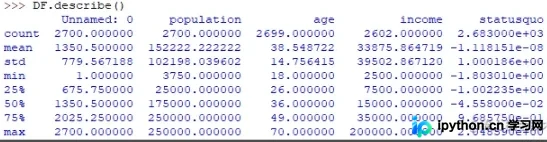
本文详解 Python 中的探索性数据分析(EDA)流程。通过 Pandas 的 describe() 和 value_counts() 快速获取数据分布与分类计数,利用 matplotlib 绘制箱线图识别异常值。进一步使用 groupby 进行分组统计,结合 scipy 的 f_oneway() 执行 ANOVA 方差分析,并通过 Pearson 相关系数评估变量间的相关性,帮助数据分析师深入理解数据特征与变量关系。