Python中HTML转义字符反转义的多种实现方案
本文详解Python中处理HTML转义字符反转义的几种方法。重点介绍Python 3.4+推荐的html.unescape函数,以及Python 2和3中HTMLParser模块的使用差异。同时提供xml.sax.saxutils.unescape的替代方案,帮助开发者在不同Python版本中正确解析HTML实体。



本文详解Python中处理HTML转义字符反转义的几种方法。重点介绍Python 3.4+推荐的html.unescape函数,以及Python 2和3中HTMLParser模块的使用差异。同时提供xml.sax.saxutils.unescape的替代方案,帮助开发者在不同Python版本中正确解析HTML实体。
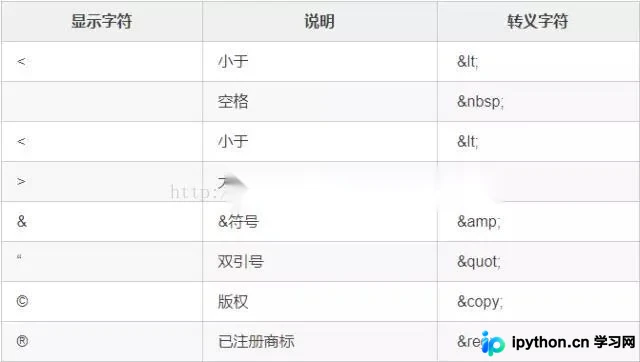
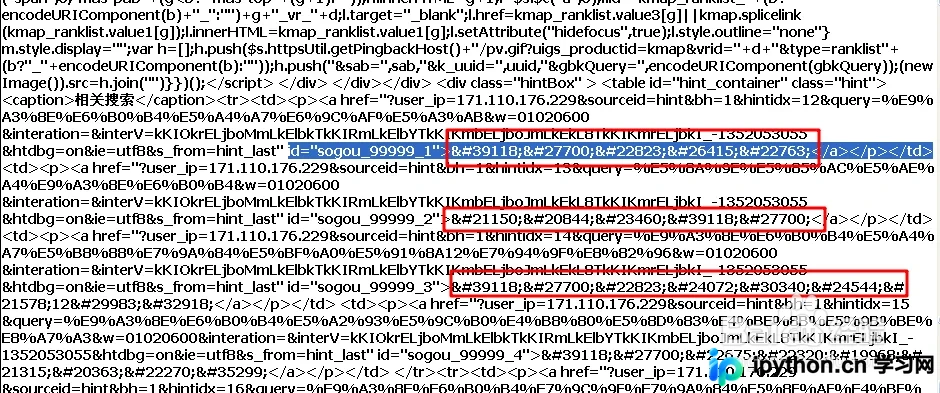
本文介绍在Python中处理以&#开头加数字的HTML字符编码(如风)的方法。针对Python 2.7版本,需导入HTMLParser模块并使用HTMLParser().unescape()进行转换;对于Python 3.7及以上版本,推荐使用html模块或from html import unescape直接处理字符串,实现从中文字符编码到正常文本的还原。
本文解析如何使用PHP将MySQL数据库中的新闻数据生成为静态HTML分页文件。通过计算总页数,循环读取数据库数据并替换模板占位符,最终写入独立的HTML文件。尽管使用了已废弃的mysql扩展,但该逻辑清晰展示了静态页面生成的核心步骤,适用于理解网页静态化机制。
本文介绍如何在Python中使用正则表达式过滤HTML标签并提取纯文本。通过定义多个正则规则,依次移除CDATA、Script、Style标签及HTML注释,并将换行符转换为标准格式,最后替换字符实体。该方法能有效清理HTML字符串,适用于网页内容抓取与数据处理场景。
本文介绍在C# WinForm应用中,利用WebBrowser控件实现前端HTML与后端C#代码的双向交互。核心在于设置ObjectForScripting属性并标记类为ComVisible,使双方能够直接调用对方暴露的方法,无需编写复杂的桥接代码。
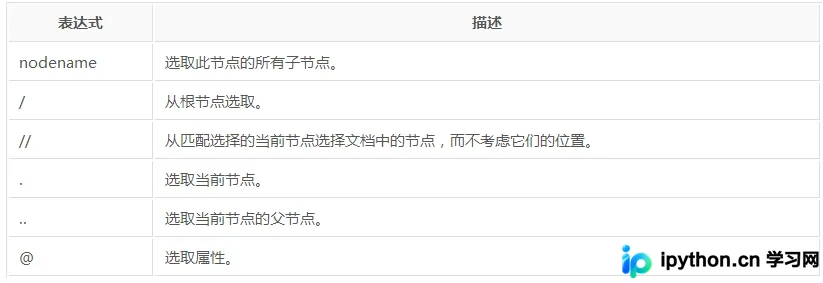
本文详细介绍Python中lxml库解析HTML文件的方法。涵盖DOM节点创建与属性获取、XPath绝对与相对路径筛选、文本提取及Scrapy爬虫实战示例。重点强调UTF-8解码必要性及常见解析错误处理,帮助开发者高效处理网页数据。
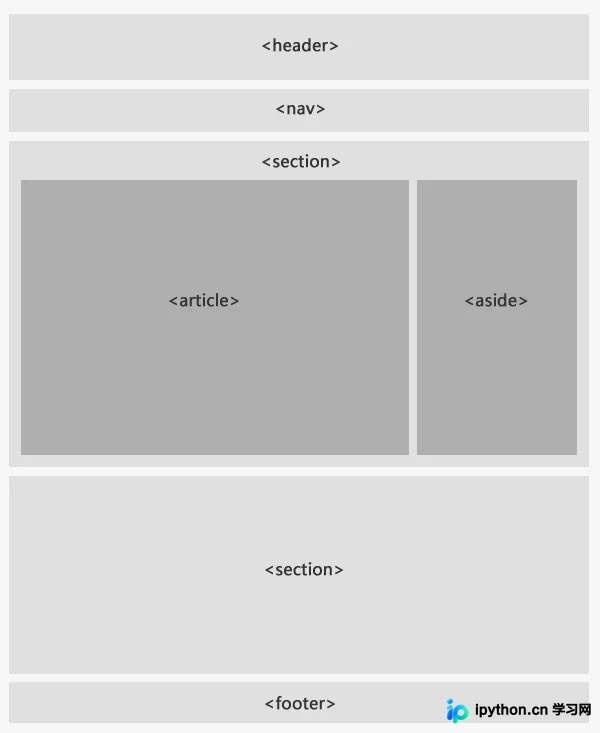
针对IE6/7/8无法识别HTML5语义化标签的问题,本文提供原生JavaScript创建元素、调用Google Html5Shiv库(含国内CDN镜像)及CSS块状初始化三种解决方案。同时补充了禁用脚本用户的容错处理建议。
本文详解 javascript:void(0) 的含义及其在超链接中的应用。重点解析 href='#' 会导致页面跳回顶部的缺陷,对比 void(0) 作为死链接的优势,并提供 onclick='return false'等无跳转交互的最佳实现方案,适用于需要触发JS而不改变URL的前端场景。
本文深入解析 HTML 4.01 规范附录中的默认样式表(User Agent Stylesheet),详细阐述其如何通过 CSS 实现跨浏览器渲染的一致性。分析该样式表的构建原理、对特定元素的布局定义,并指出在现代 Web 开发中因 CSS 能力局限而失效的部分。最后提供使用 Normalize.css 等现代重置库作为更优替代方案的实际建议。
本文介绍如何使用Python发送HTML格式的邮件。核心在于将MIMEText的subtype参数设置为html而非plain。通过示例代码展示如何配置163邮箱SMTP服务器、处理用户输入及发送带HTML内容的邮件,包含完整的连接、登录与发送逻辑。
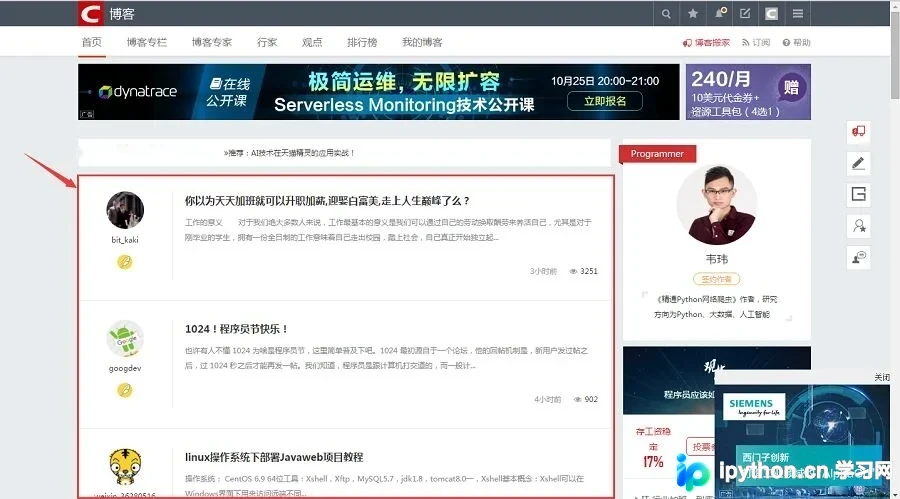
本文介绍使用Python从HTML页面中提取主要文本框的方法。通过BS4遍历所有div标签,利用正则表达式筛选并统计每个div内的中文字数,最终选取中文内容最长的div作为正文区域。文章提供了完整的requests请求、正则匹配及BeautifulSoup解析代码示例,适用于CSDN等博客类网站的正文抓取场景。
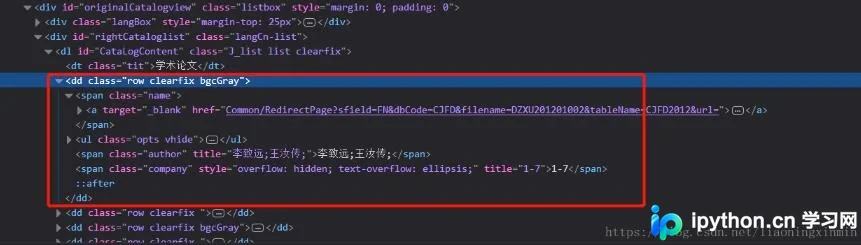
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。