
Python正则表达式匹配中文的完整指南
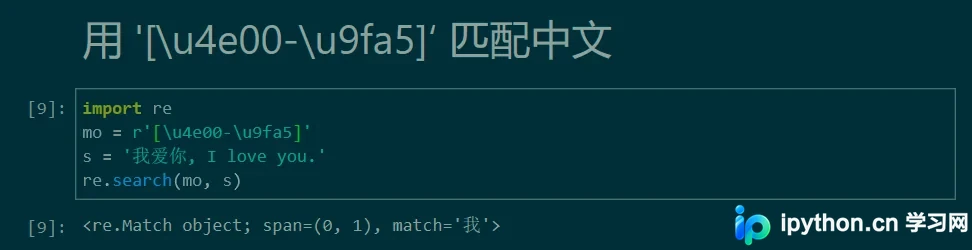
本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。



本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。
本文详解Python正则表达式(re模块)的核心语法、常用函数及高级用法。通过元字符对照表掌握模式匹配规则,结合re.match、re.search、re.findall等函数实现数据提取与替换,并给出基于正向预查断言的随机密码生成方案,帮助开发者高效处理复杂文本匹配任务。
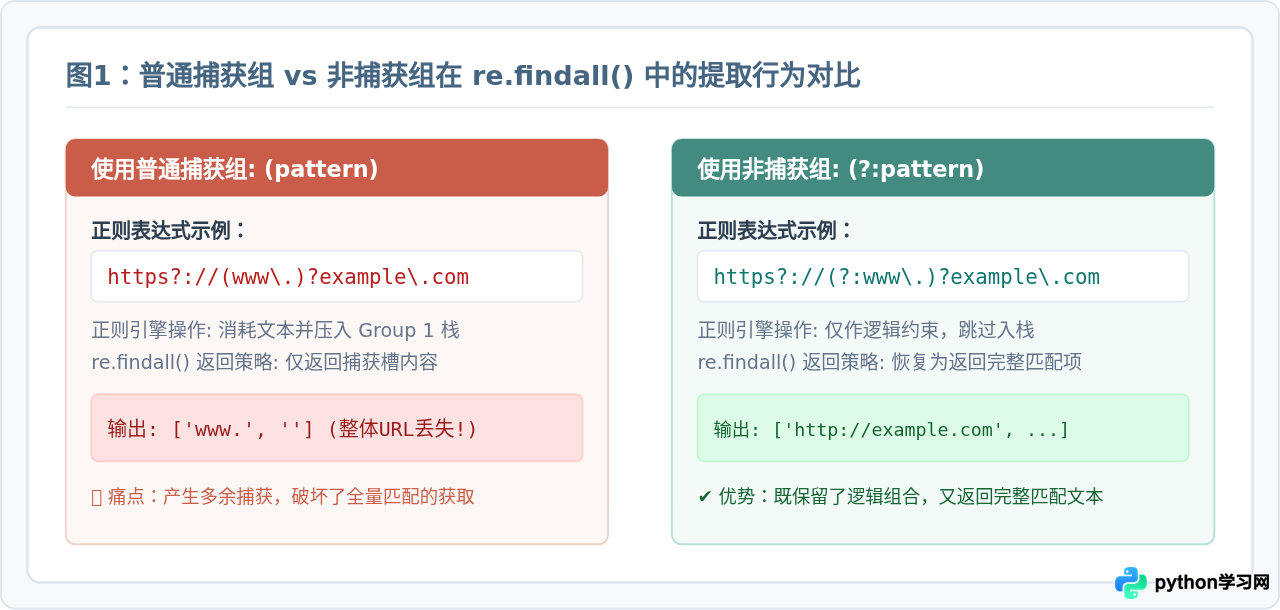
在Python中使用正则表达式进行逻辑分组时,如果不希望提取子内容,可使用非捕获组(?:...)。本文详细讲解非捕获组的原理、与普通捕获组的区别、re模块实战案例及避坑指南。
本文介绍如何在Python中利用正则表达式从TXT文件中提取包含换行符的特定字符串。通过分步策略,先截取目标区域前缀,再精准定位两个换行符之间的内容,结合[\s\S]模式实现跨行匹配,最终获取所需文本。
本文详细介绍在Python中使用正则表达式匹配中文字符的方法。核心思路是将字符串转换为Unicode格式,利用[u\u4e00-\u9fa5]模式进行匹配,并注意文件编码(如GBK)的转换。文中提供了完整代码示例及在线正则测试工具链接,帮助开发者高效处理中文文本。
本文介绍在Python中使用正则表达式同时匹配TAB和空格的方法。通过\s元字符或[\t ]字符组,可以精确捕获混合空白字符。文章结合re.match示例,演示如何正确分组提取包含TAB和空格的字符串内容,避免(.*)过度匹配的问题。
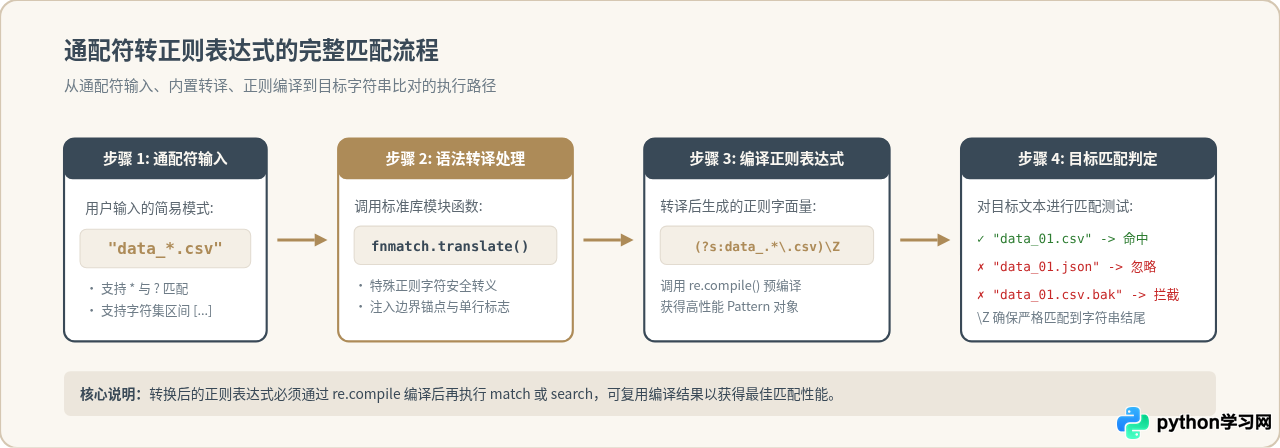
系统介绍如何在Python中使用标准库fnmatch.translate将通配符模式转换为正则表达式,深入解析转换规则、锚点机制、路径边界与自定义实现方案。
本文详细介绍Python中正则表达式的fullmatch()函数,该函数用于实现字符串与模式的全匹配。通过对比search()和match()函数,展示fullmatch()的具体用法及示例,帮助读者理解全匹配的概念与应用场景。
本文探讨Python网页采集中正则表达式匹配换行符的问题。默认情况下,正则中的点号(.)无法匹配换行符,导致数据采集失败。通过示例展示使用[\s\S]组合可匹配包括换行在内的任意字符,并简要介绍\s与\S的定义,帮助开发者解决HTML解析中的换行匹配难题。
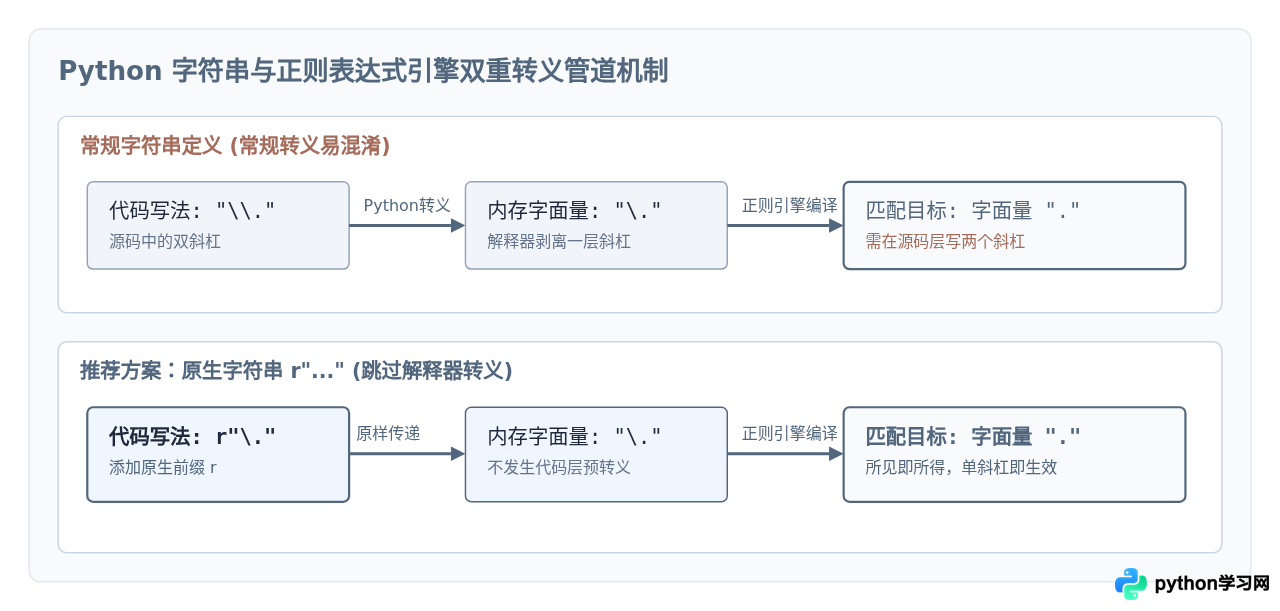
针对Python中使用re模块匹配点号、星号、美元符、反斜杠及方括号等特殊字符时常见的报错与匹配落空问题,系统分析双重转义机制与元字符特性,提供原生字符串r前缀、反斜杠转义与re.escape动态处理方案。
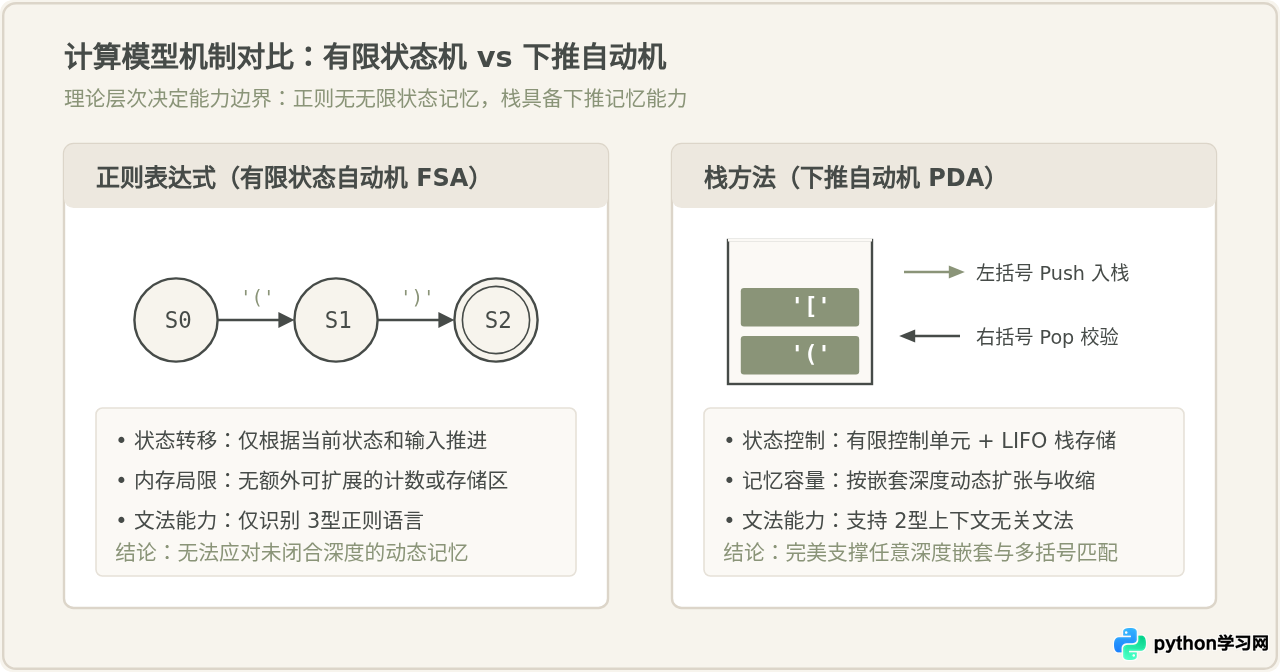
深入对比Python中使用栈方法与正则表达式匹配括号的机制差异、适用场景、实现代码与边界条件,解析任意嵌套匹配与单层扁平提取的技术选型。
在 Python 中使用正则表达式时,默认的 . 点符号无法匹配换行符,导致跨行文本获取失败。本文指出该限制并提供正确解决方案:使用 [\s\S]*、[\d\D]* 或 [\w\W]* 等字符类组合来匹配包括换行符在内的任意字符,确保能完整提取多行文本内容。



