


Python正则匹配含换行的特定字符串

发布时间:2026-10-14 |
4人浏览过
本文介绍如何在Python中利用正则表达式从TXT文件中提取包含换行符的特定字符串。通过分步策略,先截取目标区域前缀,再精准定位两个换行符之间的内容,结合[\s\S]模式实现跨行匹配,最终获取所需文本。
提取含换行的特定字符串
在处理原始TXT文件时,我们的目标是提取出“休闲服务”这一特定字符串,该字符串中间可能夹杂着换行符。
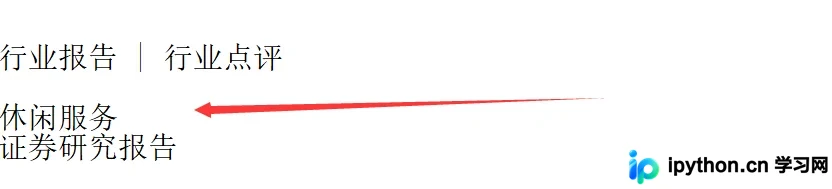
Notebook环境下的处理流程
将文件内容直接复制到Notebook环境中进行后续处理操作。
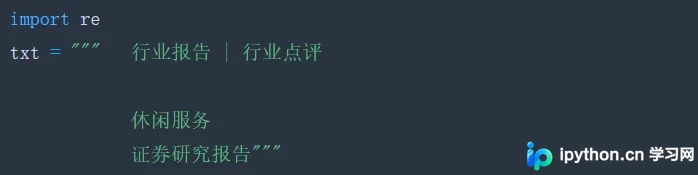
第一步:截取前缀内容
首先观察到需要提取的字符串均位于“证券研究报告”之前,因此第一步是将该前缀之前的所有内容(包括其中的换行符)全部提取出来。
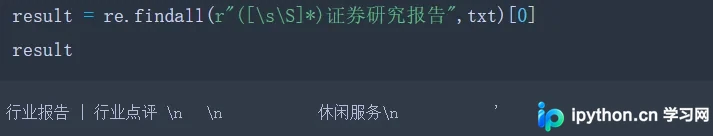
第二步:定位换行符间内容
接着发现目标字符串位于两个换行符(\n)之间,对此部分进行进一步处理。
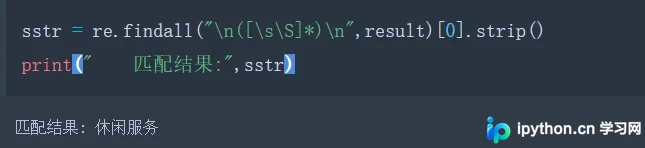
完整的实现代码如下。
完整代码实现
import re
txt = """ 行业报告 | 行业点评

   休闲服务
   证券研究报告"""
result = re.findall(r"([\s\S]*)证券研究报告",txt)[0]
sstr = re.findall("\n([\s\S]*)\n",result)[0].strip()
print(" 匹配结果:",sstr)
至此,关于Python使用正则表达式匹配TXT文件中特定字符串(含换行)的介绍已完成,更多相关内容可参考本站过往文章或继续浏览后续文章,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















