
Python爬虫实战:使用Bs4与Lxml进行数据解析
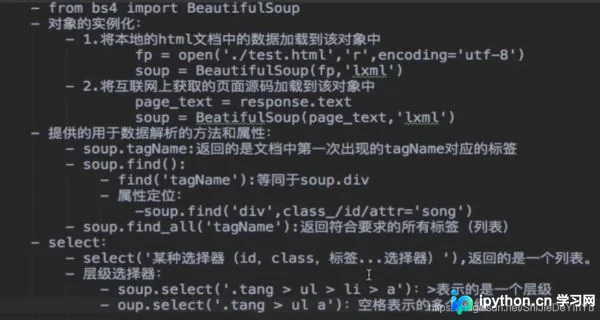
本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。



本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。
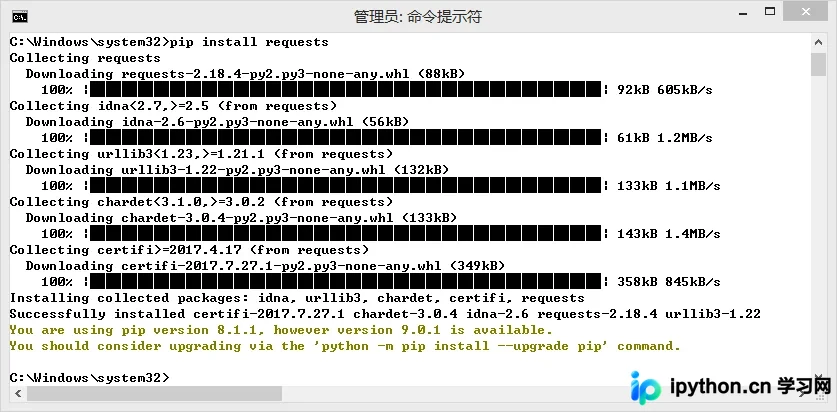
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
本文详细解析Python爬虫中正则表达式的应用,重点讲解re.I、re.M、re.S等修饰符的区别与用法。通过对比多行匹配与整体匹配的输出结果,帮助开发者准确处理文本数据。最后提供完整的糗事百科图片爬取代码,涵盖URL拼接、请求头设置、文件夹创建及持久化存储等关键步骤,适合Python初学者参考学习。
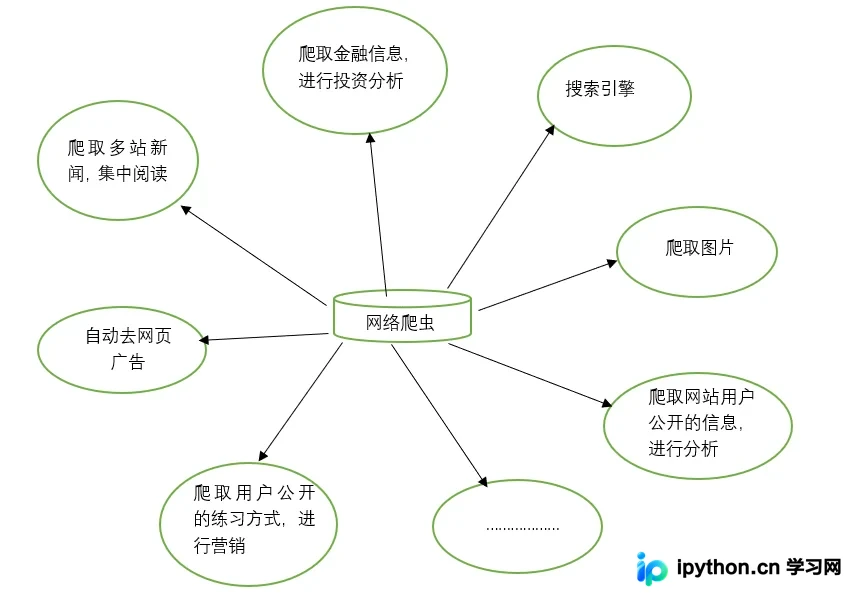
本文详细介绍Python网络爬虫的基础概念与核心功能,涵盖搜索引擎、图片抓取、金融分析及营销数据采集等应用场景。教程演示如何在Windows环境下通过pip安装requests第三方库,并提供完整的Python代码示例,展示如何获取淘宝首页HTML源码及使用BeautifulSoup进行初步数据解析,同时强调爬取频率控制与法律合规性注意事项。
本文介绍在 Python3 环境下,如何将爬取或接口返回的 bytes 格式图片数据直接保存为本地 JPG 文件。文章提供了两种主要实现方式:一是利用 urllib 库的 urlretrieve 方法直接下载保存;二是结合 requests 获取内容,并通过 PIL (Pillow) 库将字节流转换为图像对象后保存。文中包含具体的代码示例,涵盖从网络请求到本地文件写入的完整流程,适用于爬虫数据处理及 API 图像存储场景。



