


Python人工智能学习路线图:从基础语法到核心库的系统指南
针对人工智能学习者的系统进阶指南,结构化梳理从Python语法核心、科学计算与数据清洗双引擎(NumPy与Pandas),到探索性数据分析、Scikit-learn机器学习工程体系及深度学习演进的完整学习路径。
一、全景纵览:人工智能技术栈的层级解构
很多初学者在入门人工智能时,容易陷入两种极端:要么在Python基础语法中过度消耗时间,反复纠缠图形界面或网络爬虫等非关联模块;要么跳过数据处理,直接尝试运行复杂的深度学习网络模型,导致面对矩阵维度报错与特征异常时束手无策。
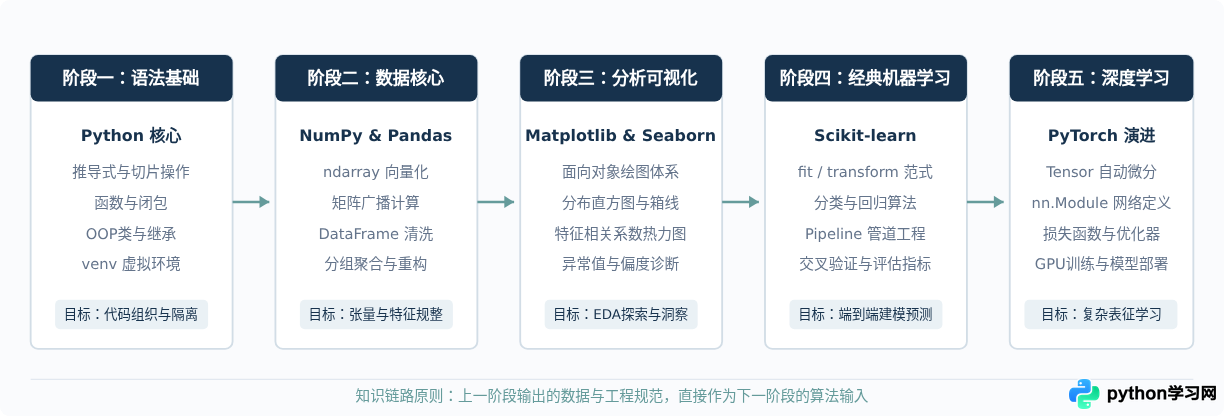
在工程体系中,人工智能是一条典型的数据流水线。算法模型的性能上限往往由特征工程与数据处理决定,而模型本身只是处理规范数据的计算载体。合理的知识结构应划分为五个相互依存的递进层级:
- 语法基石:掌握变量容器、控制流、函数式编程、面向对象与工程隔离工具。
- 数值与规整引擎:以NumPy矩阵向量化运算为核心,结合Pandas进行结构化表格的高效清洗与变换。
- 探索与表征:通过Matplotlib与Seaborn可视化数据分布与相关性,建立对特征空间的直观理解。
- 经典建模流水线:使用Scikit-learn实现标准化特征预处理、模型拟合、超参数搜索与交叉验证。
- 前沿深度计算:理解张量自动求导机制,在PyTorch等框架中构建神经网络架构。
二、阶段一:Python基础语法与工程素养储备
服务于人工智能的Python学习不需要面面俱到,重点在于掌握高频使用的核心语法与规范的工程隔离习惯。掌握以下四个模块即可满足后续算法库的使用需要:
1. 核心容器与推导式
在特征工程与样本处理中,频繁涉及集合变换与列表过滤。列表推导式与字典推导式能够提供清晰高效的单行变换表达。必须熟练使用切片语法(如 sequence[start:stop:step])和负数索引,这是后续理解多维数组切片的基础。
2. 函数式编程与闭包
理解高阶函数(接受函数作为参数或返回函数的函数)、lambda匿名函数以及常用的 map()、filter() 和 zip()。很多数据处理与特征管道在自定义转换逻辑时,依赖这种函数传递机制。
3. 面向对象编程(OOP)核心概念
所有的核心机器学习库(如Scikit-learn、PyTorch)都是基于类封装的。读者必须理解类(Class)与实例(Instance)的区别,熟练掌握 __init__ 构造方法、实例方法、继承与方法重写。例如,PyTorch的所有网络结构都继承自 torch.nn.Module,若对面向对象概念模糊,将很难看懂网络定义代码。
4. 虚拟环境与工程隔离
不同机器学习框架对底层库(如CUDA驱动、NumPy版本)有严格的版本依赖。切勿直接在全局系统环境中安装包,必须养成在每个项目根目录下初始化独立虚拟环境的习惯。
# 示例:创建并激活项目专属虚拟环境(macOS/Linux)
python3 -m venv ai_env
source ai_env/bin/activate

# 安装当前项目所需的核心依赖,指定稳定版本
pip install --upgrade pip
pip install numpy pandas matplotlib seaborn scikit-learn
三、阶段二:科学计算与数据规整双引擎(NumPy & Pandas)
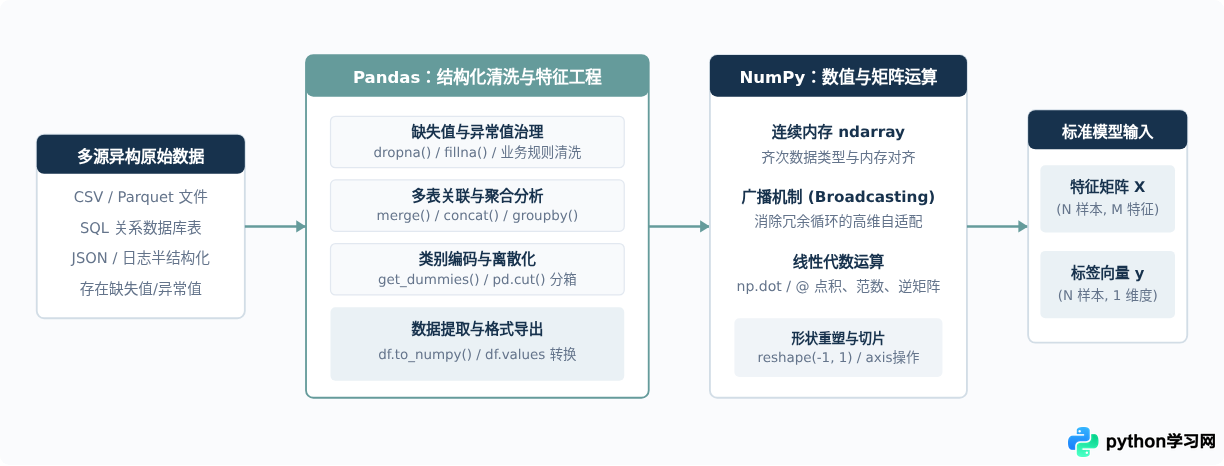
标准Python内置的 list 虽然灵活,但底层存储的是指向离散对象的指针,无法利用现代CPU的SIMD指令集与缓存局部性。NumPy与Pandas通过底层C语言扩展,提供了真正连续内存存储的数组与表格操作接口,构成了整个Python AI生态的基石。
1. NumPy 核心关注点
NumPy的核心数据结构是 ndarray。学习时必须掌握三个底层逻辑:
- 连续内存与向量化运算:避免使用Python的
for循环处理数值,使用诸如a + b或np.sin(a)等内置向量化操作,速度差异可达数十倍至上百倍。 - 广播机制(Broadcasting):当两个数组的维度形状不匹配时,NumPy根据严格的规则自动对轴进行拉伸对齐。规则简言之:两个维度要么长度相等,要么其中一个是1,否则触发广播错误。
- 轴(axis)概念:例如
np.mean(matrix, axis=0)表示沿着行的方向压缩求均值(得到每列的均值),axis=1表示沿着列方向压缩(得到每行的均值)。
2. Pandas 核心关注点
Pandas构建在NumPy之上,通过 Series(单列带索引数据)与 DataFrame(二维表格数据)解决现实业务数据的标签化与不规整问题:
- 索引对齐与定位:彻底区分基于标签的
.loc[]与基于整数位置的.iloc[]。 - 缺失值填充策略:利用
.isna().sum()统计缺失比例,结合.fillna()或插值方法处理缺失。 - 数据重塑与分组:熟练使用
.groupby()进行分桶统计,使用.merge()处理主键关联。
import numpy as np
import pandas as pd

# 示例:特征规整与NumPy矢量化计算
data = {
    'user_id': [101, 102, 103, 104],
    'age': [24, np.nan, 38, 29],
    'income': [7500, 12000, 18000, 9500]
}
df = pd.DataFrame(data)

# 1. 均值填充缺失值
df['age'] = df['age'].fillna(df['age'].mean())

# 2. 特征衍生与向量化操作(计算收入-年龄比率)
# 直接通过列运算调用NumPy底层的C实现,不遍历行
df['income_per_age'] = df['income'] / df['age']

# 3. 输出为机器学习算法需要的标准二维数组
X = df[['age', 'income', 'income_per_age']].to_numpy()
print("特征矩阵维度 (样本数, 特征数):", X.shape)
四、阶段三:数据洞察与探索性分析(Matplotlib & Seaborn)
探索性数据分析(Exploratory Data Analysis, EDA)是连接原始数据与特征工程的桥梁。通过图形化分析,开发者能够发现数据中的异常值、多重共线性、偏度分布以及不同类别之间的离散趋势。
1. Matplotlib 的面向对象体系
初学者容易被 plt.plot() 这类状态机接口混淆。在系统工程中,推荐始终使用面向对象接口,显式管理画板(Figure)与子图坐标轴(Axes):
import matplotlib.pyplot as plt

# 规范写法:显式解构 Figure 与 Axes
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot([1, 2, 3], [4, 5, 6], label='Trend')
ax.set_title('Metric Progression')
ax.set_xlabel('Epoch')
ax.set_ylabel('Loss')
ax.legend()
# plt.show() 渲染展示
2. Seaborn 的统计图表应用
Seaborn对Matplotlib进行了高级封装,能够直接处理Pandas的DataFrame结构。核心图表类型与任务对应关系如下:
- 特征分布检查:使用
sns.histplot(kde=True)观察连续特征是否满足正态分布,判断是否需要对数变换。 - 异常值识别:使用
sns.boxplot()检测分位数之外的极值。 - 特征相关性分析:计算相关系数矩阵
df.corr()后,利用sns.heatmap()绘制热力图,识别特征之间的冗余共线性。
五、阶段四:经典机器学习工程体系(Scikit-learn)
Scikit-learn是传统机器学习事实上的行业标准。该库最卓越的贡献在于确立了高度统一、易于扩展的API设计哲学,将复杂的数学优化封装在标准化接口之后。
1. 两个核心接口的严格约定
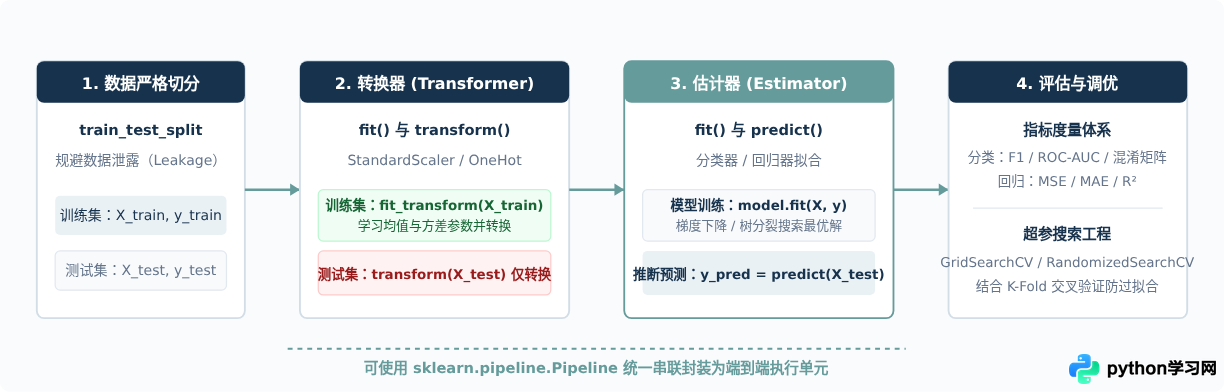
Scikit-learn的代码设计分为两类核心对象,严格遵循状态隔离:
- 转换器(Transformer):用于特征预处理(如归一化
StandardScaler或独热编码OneHotEncoder)。包含两个主要方法:fit()用于从数据中学习统计量(例如均值和标准差);transform()利用已学到的统计量对数据进行变换。在测试集上绝对不能调用fit(),只能调用transform(),否则会导致严重的数据泄露。 - 估计器(Estimator):即预测模型(如随机森林
RandomForestClassifier或支持向量机SVC)。包含fit()进行参数权重求解,以及predict()进行新样本标签预测。
2. 工业级 Pipeline 范式
在实际生产环境中,手工分步调用特征转换容易引发数据泄漏或测试集变换不一致。官方推荐使用 Pipeline,将缺失值填充、特征标准化和模型拟合打包为一个不可拆分的原子操作:
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 切分数据集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 组装 Pipeline 流水线:无缝连接预处理器与分类器
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('rf_model', RandomForestClassifier(n_estimators=100, random_state=42))
])

# 3. 拟合并进行评估:Pipeline 会自动对训练集 fit_transform,对测试集 transform
pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)

# 4. 输出全套分类评估指标(精确率、召回率、F1分数)
print(classification_report(y_test, y_pred))
六、阶段五:深度学习进阶与边界跨越
当特征维度极高、结构非表格化(如图像像素、音频信号、长文本Token序列)时,手工设计特征的传统机器学习方法边际收益递减。此时需要进阶至以神经网络为核心的深度学习体系。
在当前工程实践中,PyTorch 是绝对的首选框架。从Scikit-learn平滑过渡到PyTorch,需要理解底层核心逻辑的迁移:
- 从 ndarray 到 Tensor(张量):
torch.Tensor在语法操作上高度兼容NumPy的ndarray,但增加了对GPU/NPU等硬件加速单元的支持,以及反向传播自动求导(Autograd)能力。 - 从封闭封装到显式训练循环:传统机器学习库的
model.fit()将优化过程封装在黑盒中。而PyTorch需要开发者显式编写训练循环(前向传播计算损失loss.backward()反向传递梯度,optimizer.step()更新权重,optimizer.zero_grad()清零梯度),这赋予了开发者对底层网络架构定制的极大自由度。 - 模块继承模式:自定义模型必须继承
torch.nn.Module,并在__init__中声明网络层,在forward方法中定义计算数据流。
七、学习资源配置与检验标准
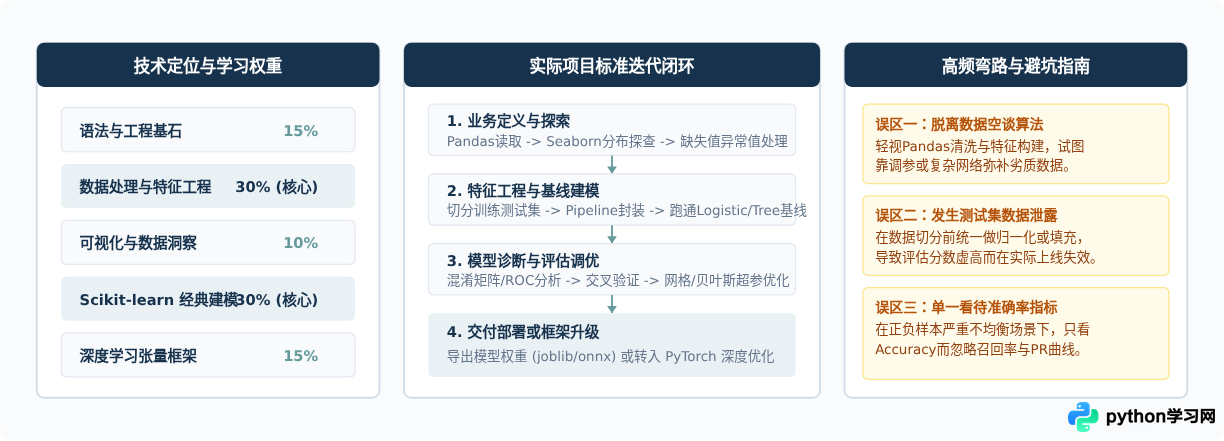
为了保证学习过程高效可落地,避免在非关键细节上空耗精力,建议将时间精力按照科学权重进行分配,并以具体的交付成果作为每个阶段的验收标准。
| 阶段模块 | 核心代表工具库 | 建议时间占比 | 阶段能力验收标准 |
|---|---|---|---|
| 一、基础语法 | Python 3.10+, venv | 15% | 能熟练使用推导式切片;能使用OOP封装类;能使用虚拟环境独立管理第三方包。 |
| 二、数据处理 | NumPy, Pandas | 30% | 掌握广播运算机制与轴操作;能高效清洗含有缺失、异常、重复项的脏数据表格。 |
| 三、分析可视 | Matplotlib, Seaborn | 10% | 能使用面向对象方式绘制双坐标图、特征分布直方图、箱线图及相关性热力图。 |
| 四、传统建模 | Scikit-learn | 30% | 能独立构建包含预处理与模型的Pipeline;熟练使用K折交叉验证并准确解读F1/ROC指标。 |
| 五、深度进阶 | PyTorch | 15% | 理解动态计算图与自动微分机制;能独立手写多层感知机(MLP)训练与验证闭环。 |
八、系统学习与实践行动建议
完成全套知识储备后,验证自己是否真正掌握该体系的最佳方式,是亲手独立实现一个端到端的预测项目:
- 从权威公开数据集平台(如Kaggle或UCI Machine Learning Repository)选取一个具有真实业务背景的表格数据集(例如客户流失预测、房价回归或信用评分)。
- 建立独立的Git仓库与
venv虚拟环境,完整记录项目依赖。 - 在Jupyter Notebook中进行数据清洗与EDA,绘制至少三类不同维度的统计图表,形成对业务特征的初步判断。
- 编写标准的Python模块脚本,使用Scikit-learn的
ColumnTransformer与Pipeline串联数据预处理与分类模型。 - 输出包含精确率、召回率、F1分数及ROC曲线的完整评估报告,并使用
joblib对模型进行序列化导出。
遵循这套从基础到工程化的递进路径,才能避开死记硬背API与浮躁跟风大模型的陷阱,真正建立起属于算法工程师与数据开发者的核心壁垒。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















