Python构建免费爬虫代理池实战:从抓取到验证
本文详解如何使用Python构建一个轻量级的爬虫代理池。通过抓取西祠胡同等免费代理网站,利用PyQuery解析数据并存入List,实现HTTP与HTTPS代理的分类管理。文章提供了代理有效性检测、随机调用及失效清理的核心代码逻辑,并探讨了基于分数的代理维护机制,帮助开发者应对403限制。



本文详解如何使用Python构建一个轻量级的爬虫代理池。通过抓取西祠胡同等免费代理网站,利用PyQuery解析数据并存入List,实现HTTP与HTTPS代理的分类管理。文章提供了代理有效性检测、随机调用及失效清理的核心代码逻辑,并探讨了基于分数的代理维护机制,帮助开发者应对403限制。
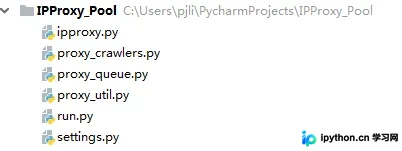
本文详细介绍Python爬虫代理池的搭建流程。针对IP访问频率限制问题,提出通过代理池轮询IP的解决方案。涵盖从代理网站抓取、可用性验证、Redis存储到队列管理的完整代码实现,包含IPProxy类、配置管理及多爬虫基类设计,并提供测试与GitHub源码地址。
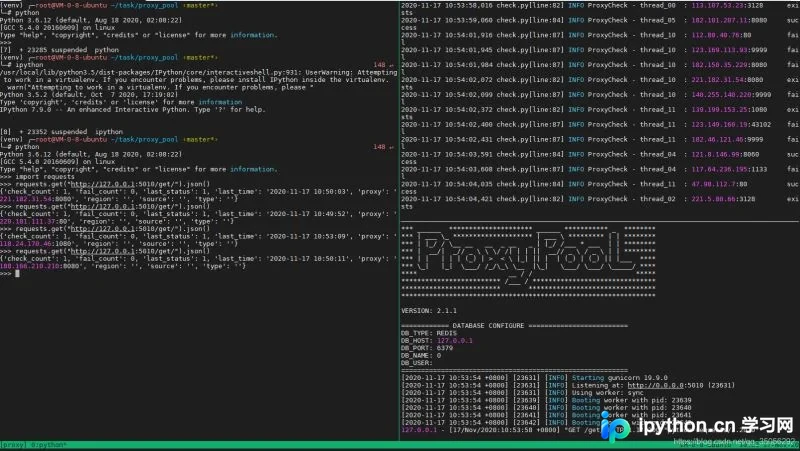
本文介绍在Python爬虫开发中,针对高并发请求导致IP被封禁的问题,使用开源项目proxy_pool搭建代理池的完整流程。涵盖从Python虚拟环境搭建、Redis依赖安装,到配置文件修改、服务启动及代码测试的具体步骤,帮助开发者实现IP自动轮换与异常处理。
本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
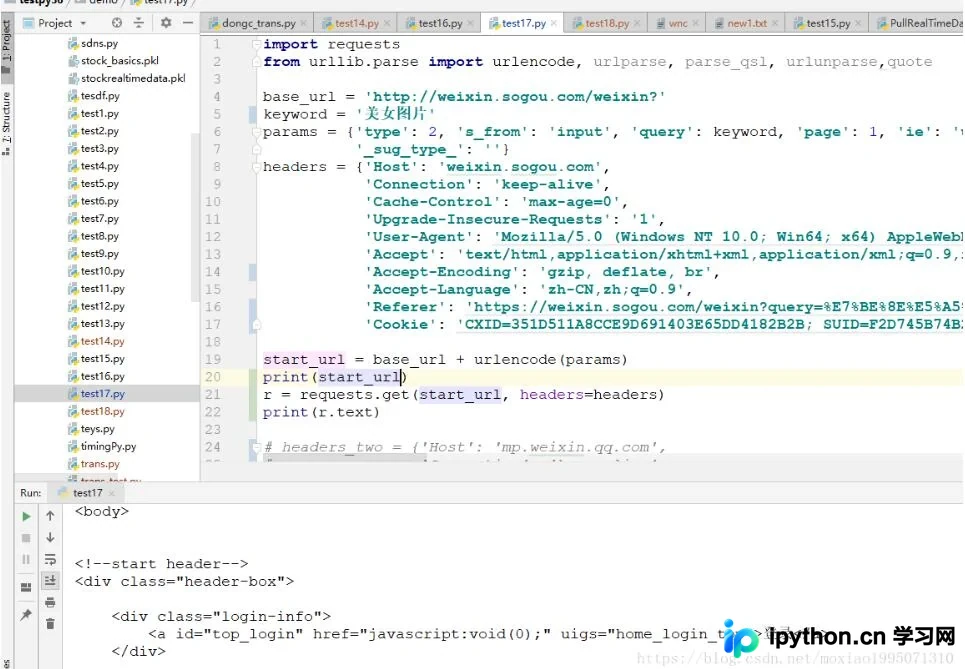
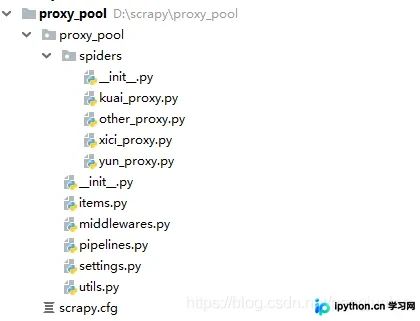
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
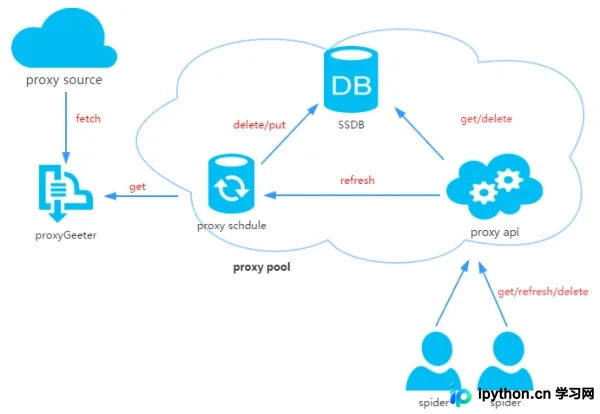
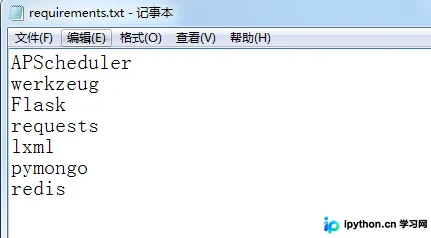
本文详细介绍如何使用Python搭建一个轻量级的分布式爬虫代理IP池。通过整合多个免费代理源,利用SSDB进行高性能存储,并结合Flask提供RESTful API接口。文章涵盖代理获取、质量检测、定时刷新及爬虫调用等核心模块,帮助开发者快速实现稳定高效的代理IP管理服务。
本文详细介绍Python中Proxypool库的安装与配置流程。从GitHub下载源码并解压开始,指导用户修改关键配置文件路径,通过命令行执行依赖安装命令,并对ProxyGetter模块中的部分代码进行注释处理。最后提供简单的测试方法,帮助用户快速搭建可用的代理池环境,适用于爬虫开发场景。
本文提供使用Python requests库构建代理IP池的完整示例代码。内容涵盖从网站抓取代理IP、验证可用性、保存至本地文件以及通过函数获取可用代理的全过程,旨在解决爬虫过程中IP被封禁的问题,为数据库抓取任务提供稳定的网络环境支持。
本文详解如何使用MySQL数据库存储Python代理IP池中的IP地址。通过定义MAX_SCORE、MIN_SCORE和INITIAL_SCORE等参数,实现IP可用性的动态评分机制。文章提供了完整的数据库连接配置、核心操作方法(添加、减分、获取)及抓取保存代码,帮助开发者构建高效、自动化的代理IP管理系统。
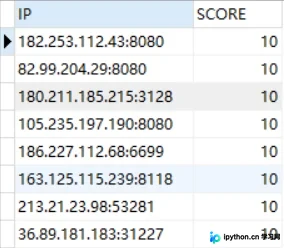
本文介绍如何使用Python构建一个简单的IP代理池。通过requests库从指定网站抓取IP数据,利用正则表达式提取IP和端口,并结合telnetlib库进行连通性测试,筛选出可用的代理IP并保存至文件。
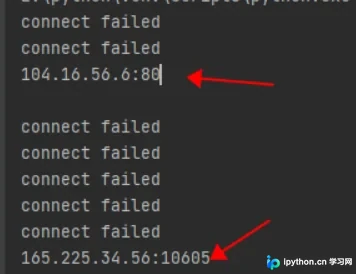
本文介绍如何使用Python结合Redis数据库构建IP代理池。通过apscheduler库实现定时爬取IP,并采用两层检测机制确保代理有效性:先将IP存入Redis db0进行初步验证,成功者转入db1进行二次检测。代码包含IP的增删改查及定时调度逻辑,为网络爬虫提供稳定的代理支持。
本文详细介绍如何在Python中利用Selenium库搭建代理IP池,以规避网站访问限制。内容涵盖Selenium及浏览器驱动的下载安装、环境变量配置,以及通过Chrome Options添加随机代理IP的核心代码实现。文中提供了完整的代码示例和注意事项,帮助开发者高效管理多个代理IP,降低被封禁风险。