Python爬虫代理池元类实现与测试解析
本文深入解析Python3 WebSpider爬虫代理池的源代码测试过程。重点介绍如何利用元类(Metaclass)自动注册抓取函数,通过约定前缀动态生成属性列表,实现抓取逻辑的解耦与扩展。文章包含详细的代码示例及控制台输出日志,展示代理获取器的执行流程与测试结果,为构建可扩展的爬虫系统提供参考。



本文深入解析Python3 WebSpider爬虫代理池的源代码测试过程。重点介绍如何利用元类(Metaclass)自动注册抓取函数,通过约定前缀动态生成属性列表,实现抓取逻辑的解耦与扩展。文章包含详细的代码示例及控制台输出日志,展示代理获取器的执行流程与测试结果,为构建可扩展的爬虫系统提供参考。
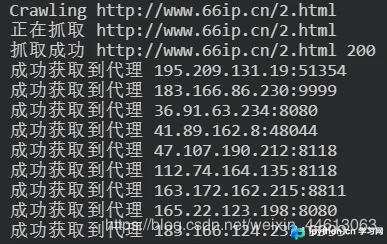
本文介绍如何使用Python构建代理IP池的第一步:获取IP。通过结合Requests和PyQuery库,利用自定义的ProxyMetaclass元类自动识别以crawl开头的方法,实现从多个免费代理网站批量抓取IP和端口。代码采用生成器模式返回数据,便于后续存储与检测,为反爬策略提供灵活的IP轮换方案。
本文详细介绍如何使用Python搭建代理IP池,重点讲解通过Flask提供Web API接口以安全获取代理IP的方法,以及利用多进程模块并行运行获取、检测和API服务模块的调度策略。包含setting.py配置说明及scheduler.py核心代码解析,帮助开发者实现高效稳定的代理池系统。
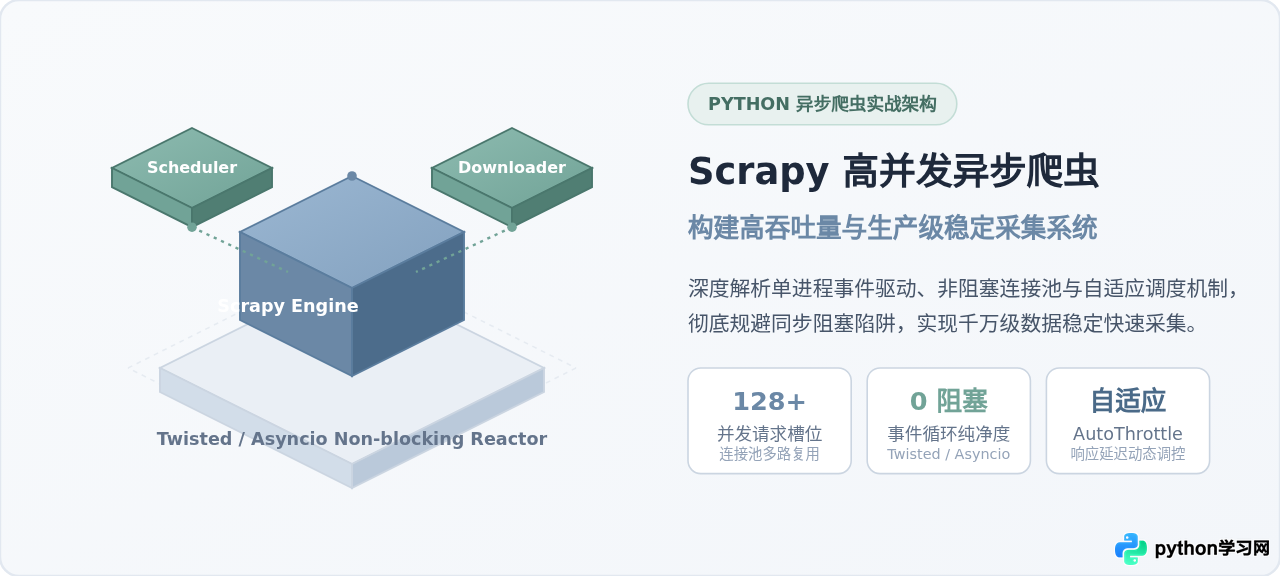
深入解析Scrapy单进程事件驱动机制,从Twisted/Asyncio底层架构、非阻塞中间件编写,到高并发参数调优与生产级避坑指南,全面构建高吞吐量异步爬虫系统。
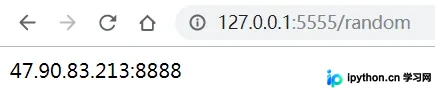
本文介绍如何在Python3中利用requests库结合IP代理池实现随机IP生成。通过从预设代理列表随机选择IP,配置请求头信息,并访问测试网站验证当前IP。该方法适用于需要隐藏真实IP或进行网络爬虫开发的场景,代码简洁实用,可直接参考使用。
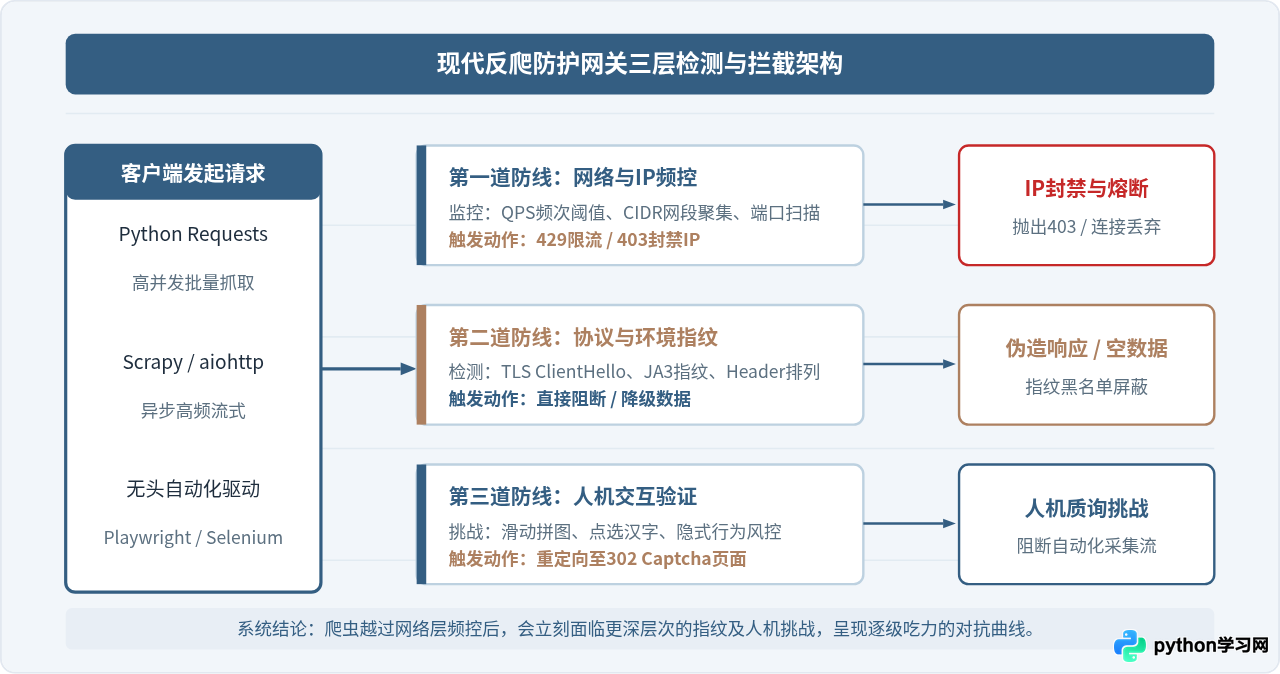
针对Python爬虫面临的User-Agent校验、Cookie会话追踪与IP频次封禁三大基础反爬策略,系统讲解识别原理、排查方法、代码实现与工程化应对方案。
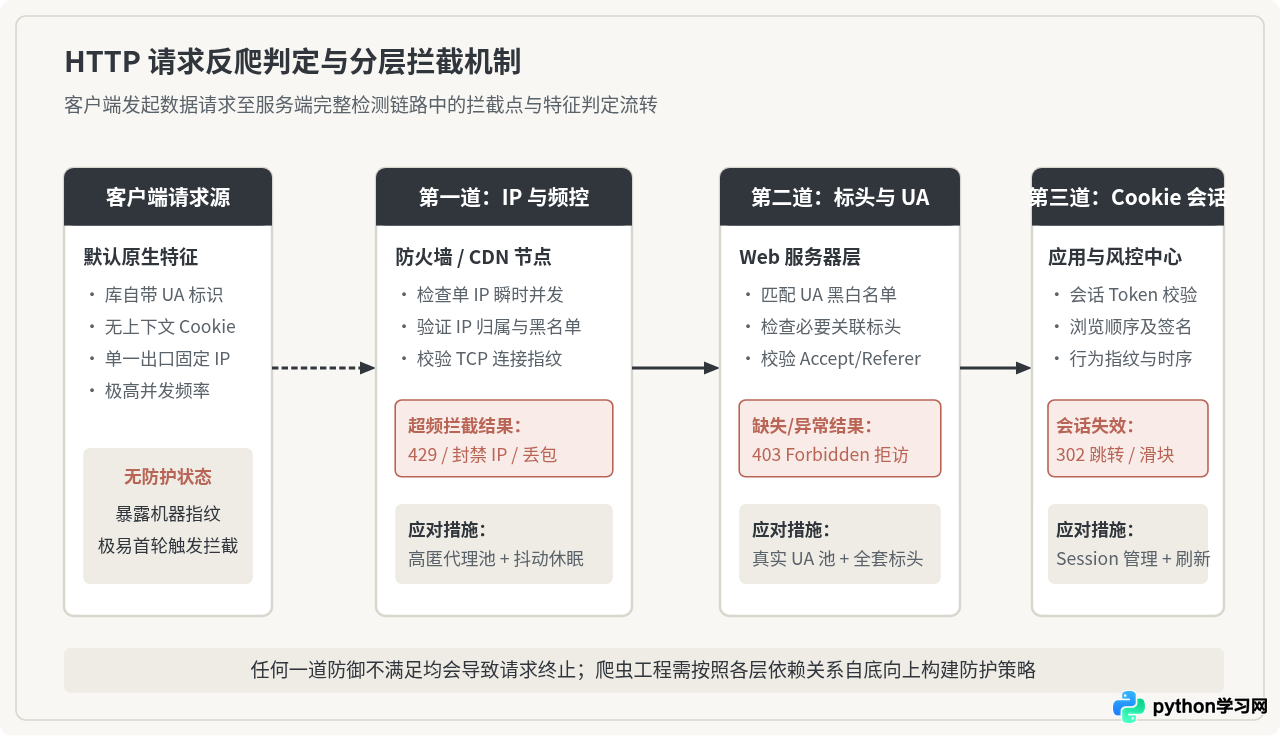
深入解析Python爬虫常见的User-Agent检测与IP封禁机制,提供规范的请求头伪装、随机UA轮换、访问节奏控制与高匿代理池架构实战应对策略。
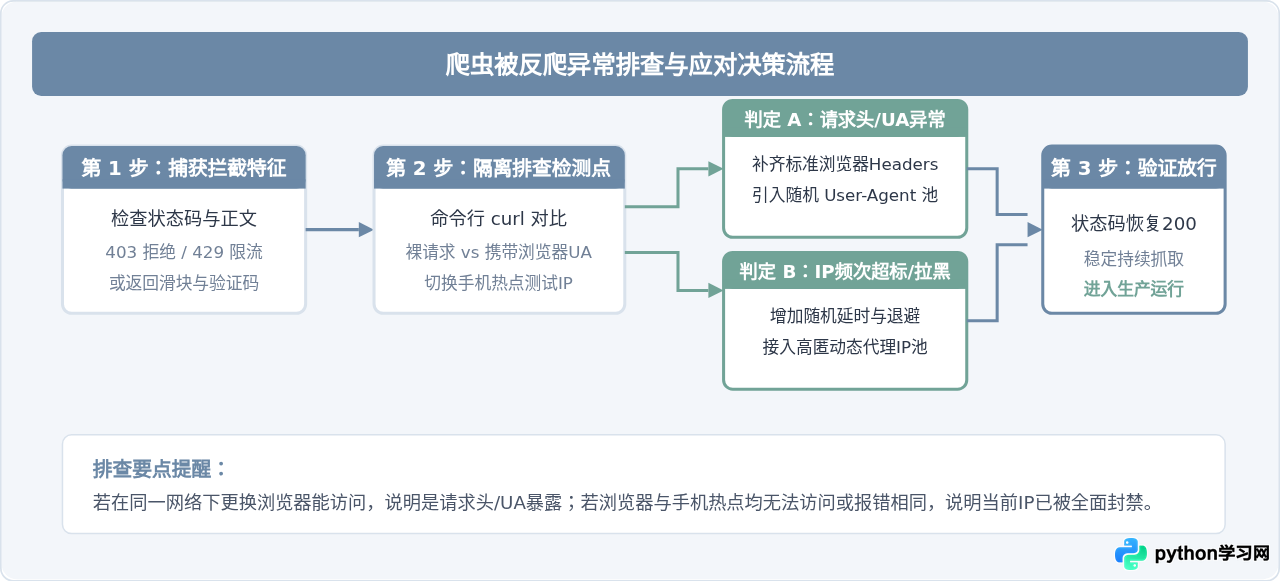
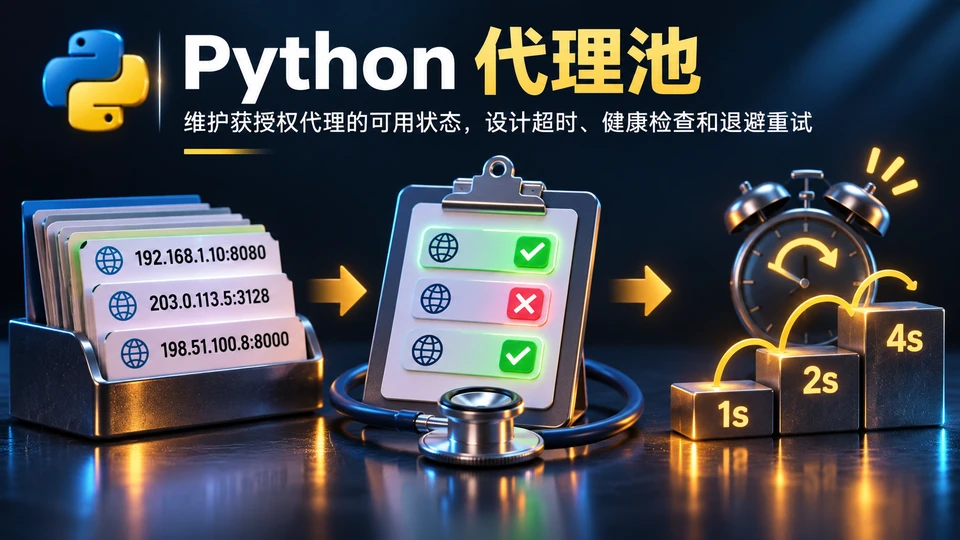
深入解析Python爬虫在遭遇IP封禁与验证码拦截时的真实阻力来源,提供代理池调度、指数退避重试、人机验证识别与浏览器指纹模拟的工程化解决方案。