


Python主要有哪些应用方向?Web、数据科学与AI领域解析
深入解析Python三大核心应用方向:Web后端、数据科学与分析、人工智能与机器学习。梳理各方向主流工具链、架构流程、代码示例与选型决策指南。
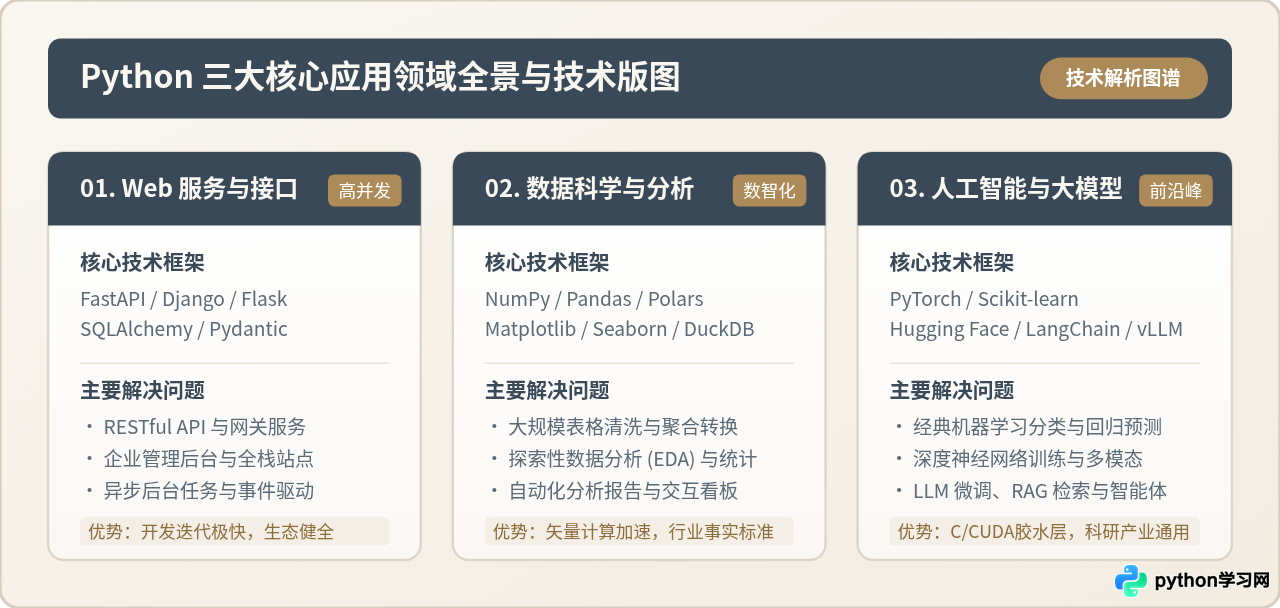
一、Python 为什么能跨界统治三大领域?
探讨具体方向前,需要理解 Python 的底层运行机制。很多初学者常有一个疑问:“Python 运行效率远低于 C++ 或 Go,为什么不仅没被淘汰,反而在对算力要求极高的数据科学和人工智能领域成为无可替代的行业标准?”
关键原因在于 Python 独特的“双层架构与胶水语言”特性。在 Python 体系中,解释器(CPython)负责解析上层高级语法、调度面向对象逻辑和提供极其友好的代码表达力;而底层所有涉及密集矩阵运算、高频网络 I/O、张量梯度求导的核心计算,均由预编译好的 C、C++、Fortran 或 NVIDIA CUDA 核函数直接执行。
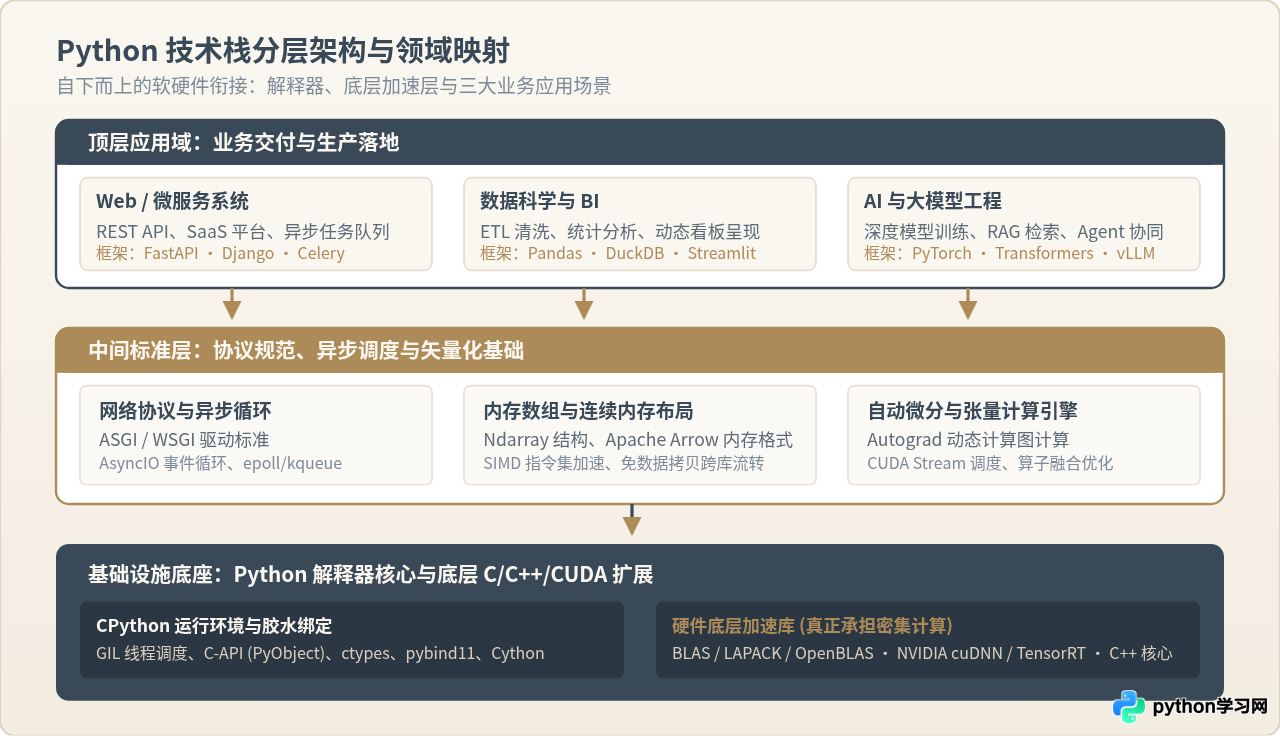
开发者在 Python 中调用一行 df.groupby('city').mean() 或 loss.backward() 时,Python 虚拟机只耗费了微秒级的指令调度时间,99% 以上的时钟周期直接运行在优化的底层向量化引擎中。这种“上层敏捷开发、底层极限吞吐”的设计,让 Python 在 Web 的高并发网络调用、数据分析的连续内存切片,以及 AI 的 GPU 张量计算中找到了最佳平衡点。
二、方向一:现代 Web 后端与微服务开发
Web 开发是 Python 成熟度最高、工程生态最完善的应用方向之一。与很多脚本语言不同,Python 在 Web 领域覆盖了从全功能单体单据系统到异步高并发微服务网关的完整场景。
1. 主流 Web 框架选型标准
根据业务规模、性能诉求与团队结构,Python Web 形成了三大梯队的清晰分工:
-
FastAPI(现代异步微服务首选):基于 ASGI 标准、Starlette 与 Pydantic 构建。通过原生 Python 类型注解(Type Hints)实现了自动入参校验、自动序列化与 OpenAPI 接口文档生成。在 I/O 密集型接口中,借助
async/await能够提供媲美 Node.js 与 Go 的吞吐表现。 - Django(大型企业站与内部管理系统首选):“电池齐全(Batteries-Included)”的典型代表。自带高工业强度的 ORM、用户权限鉴权系统、CSRF 安全防护以及强大的后台管理界面(Django Admin)。开发企业 ERP、内容管理系统或敏捷验证商业原型时,开发效率无可匹敌。
- Flask(轻量原型与胶水服务首选):WSGI 微框架,核心极度精简,不强加数据库或权限规范。常用于包装单一模型推理服务、小型工具接口或对架构有高度定制化需求的轻量服务。
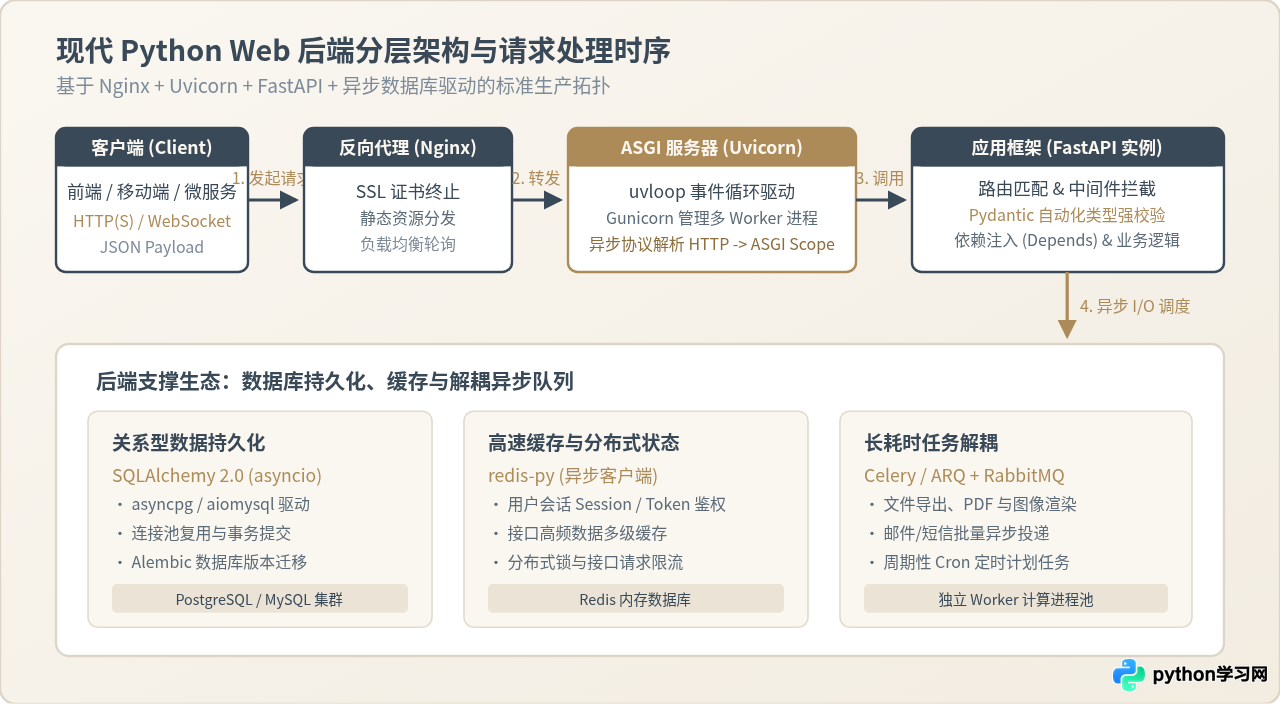
2. 典型生产代码示例:FastAPI 异步数据接口
下面是一个符合现代生产规范的异步用户订单查询接口。示例展示了类型声明、Pydantic 请求体校验以及依赖注入(Dependency Injection)的基本运作方式:
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, Field
from typing import List
import asyncio

app = FastAPI(title="订单微服务系统", version="1.0.0")

# 1. 声明数据传输模型 (DTO / Schema)
class OrderItem(BaseModel):
    item_id: int
    name: str = Field(..., min_length=1, max_length=50)
    price: float = Field(..., gt=0.0)

class CreateOrderRequest(BaseModel):
    user_id: int
    items: List[OrderItem]
    total_amount: float

class OrderResponse(BaseModel):
    order_id: str
    status: str
    total_amount: float

# 2. 模拟数据库异步连接依赖
async def get_db_session():
    # 模拟从异步连接池获取 session
    session = {"pool_id": "pg_conn_01", "active": True}
    yield session
    # 请求处理完成后自动执行清理释放

# 3. 异步业务接口实现
@app.post("/api/v1/orders", response_model=OrderResponse, status_code=status.HTTP_201_CREATED)
async def create_order(payload: CreateOrderRequest, db=Depends(get_db_session)):
    # 检查业务逻辑一致性
    calculated_sum = sum(item.price for item in payload.items)
    if abs(calculated_sum - payload.total_amount) > 0.01:
        raise HTTPException(status_code=400, detail="订单金额与商品总价不符")

    # 模拟异步写入数据库 (非阻塞 I/O)
    await asyncio.sleep(0.02)
    generated_id = f"ORD-{payload.user_id}-9871"

    return OrderResponse(
        order_id=generated_id,
        status="CONFIRMED",
        total_amount=payload.total_amount
)uvicorn app:app --reload 裸跑。标准架构必须使用 Gunicorn 作为进程管理器,搭配 Uvicorn 的工作线程,并在最前层由 Nginx 承载 SSL 证书、静态文件分发与反向代理。
三、方向二:数据科学与商业分析
如果说 Web 开发中 Python 有 Node.js、Go、Java 等强劲竞争者,那么在数据科学与商业分析领域,Python 拥有绝对的话语权。从金融量化建模、互联网用户增长分析,到生物信息学和工业传感器时序挖掘,Python 已经成为行业事实标准。
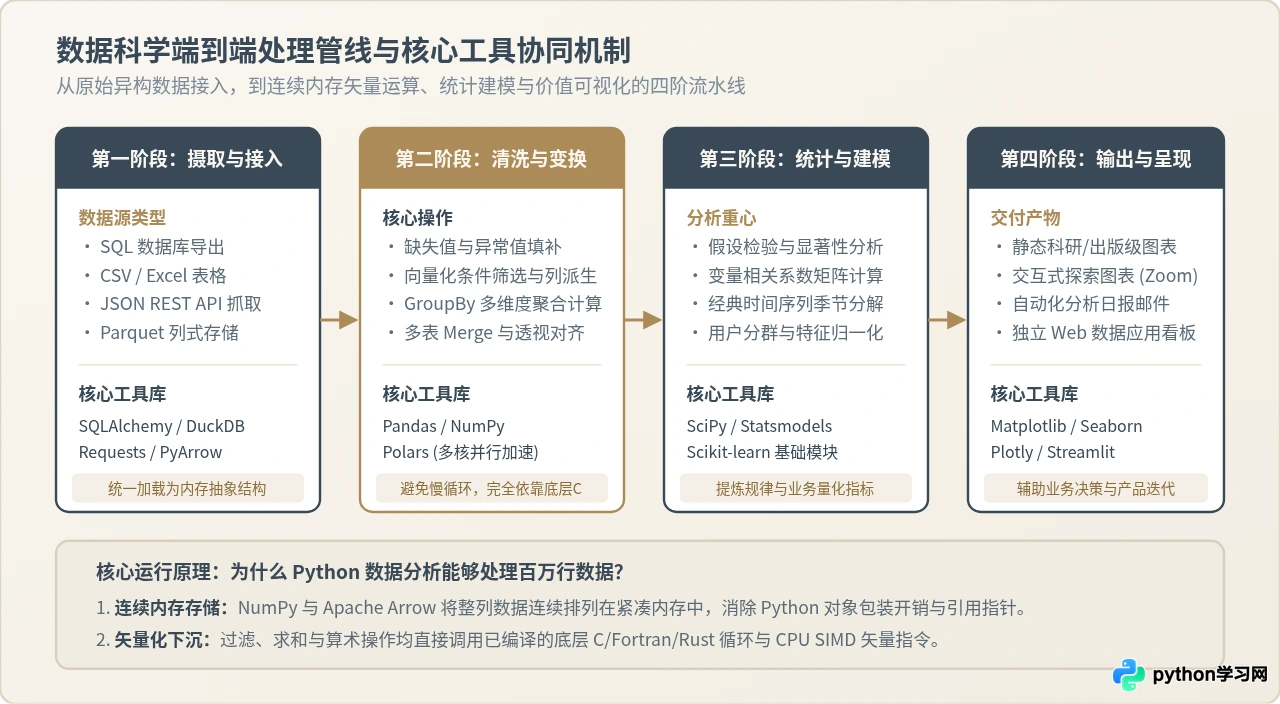
1. 数据科学的核心工具链矩阵
数据分析并非简单地写几行代码读取 Excel,而是涵盖了数据接入、清洗转换、统计建模和可视化洞察的完整流水线:
-
NumPy(底层阵列计算基石):提供高效的 N 维数组(
ndarray),在连续内存中组织同质数据,所有基础加减乘除、内积、点积均调用经过硬件优化的底层线性代数库(BLAS/LAPACK)。 -
Pandas 与 Polars(表格分析双雄):Pandas 是单机数据处理的标准库,以
DataFrame为核心,提供媲美 SQL 的筛选、分组(GroupBy)、透视与滑动窗口计算。在需要应对数十 GB 级内存受限的大规模表格时,基于 Rust 编写、支持全核心并行和延迟执行(Lazy Execution)的 Polars 正在成为新一代高性能替代方案。 - DuckDB(单机嵌入式分析引擎):在不需要搭建庞大 Hadoop/Spark 集群的情况下,单机通过 SQL 直接快速查询百万行 Parquet/CSV 文件,极大地解放了单机分析生产力。
- Matplotlib 与 Seaborn(统计图表呈现):提供出版级学术与业务图表绘制能力,从箱线图、热力图到散点矩阵,实现探索性数据分析(EDA)结果的精准表达。
2. 典型分析代码示例:用户复购与漏斗转化分析
以下代码演示了真实业务中常见的数据清洗与多维聚合操作。注意代码中全程避免使用 Python 原生 for 循环,充分利用 Pandas 的矢量化操作保证吞吐效率:
import pandas as pd
import numpy as np

# 1. 模拟生成原始交易流水数据
np.random.seed(42)
records = 10000
raw_data = {
    "order_id": np.arange(10001, 10001 + records),
    "user_id": np.random.randint(100, 800, size=records),
    "category": np.random.choice(["Electronics", "Clothing", "Home", "Books"], size=records),
    "amount": np.random.exponential(scale=120, size=records).round(2),
    "is_returned": np.random.choice([0, 1], p=[0.92, 0.08], size=records)
}
df = pd.DataFrame(raw_data)

# 2. 数据清洗与特征列派生 (矢量化计算,耗时毫秒级)
valid_orders = df[df["is_returned"] == 0].copy()
valid_orders["is_high_value"] = valid_orders["amount"] >= 200

# 3. 多维度分组聚合 (用户级别行为画像)
user_summary = valid_orders.groupby("user_id").agg(
    total_spend=("amount", "sum"),
    order_count=("order_id", "count"),
    high_value_orders=("is_high_value", "sum")
)

# 4. 筛选核心优质客户群 (客单价 >= 100 且 订单量 >= 5)
user_summary["avg_order_value"] = (user_summary["total_spend"] / user_summary["order_count"]).round(2)
vip_users = user_summary[
    (user_summary["order_count"] >= 5) &
    (user_summary["avg_order_value"] >= 100)
].sort_values(by="total_spend", ascending=False)

print(f"有效订单总数: {len(valid_orders)}")
print(f"核心 VIP 用户规模: {len(vip_users)} 人")
print("Top 3 客户指标示例:")
print(vip_users.head(3))四、方向三:人工智能与机器学习
人工智能(AI)是当前 Python 关注度最高、也是技术爆发最激烈的领域。从早期的统计学习分类器,到卷积神经网络(CNN)、Transformer 架构,再到当下的大语言模型(LLM)与多模态智能体(Agent),Python 构筑了整个 AI 产业的研究与交付基底。
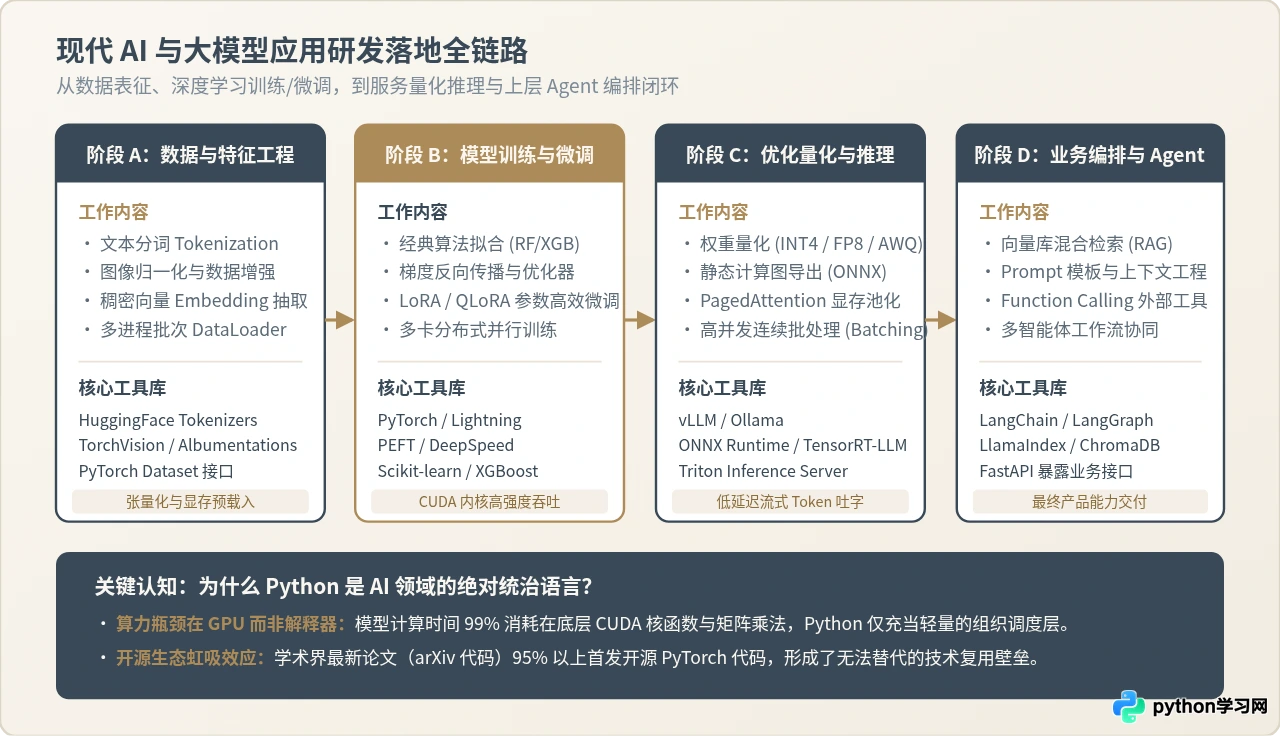
1. 领域层次演进:从经典机器学习到大模型工程
进入 AI 领域前,必须分清不同技术分支的实际工程定位:
- 经典机器学习(Scikit-learn / XGBoost / LightGBM):用于处理结构化表格数据。在风控评分卡、信用评级、流失预测、推荐系统初筛等企业传统场景中,树模型(如 XGBoost)在训练成本、可解释性和准确率上往往完胜盲目堆叠的深度网络。
- 深度学习(PyTorch / TensorFlow):以张量计算和反向自动微分(Autograd)为核心。PyTorch 凭借灵活的动态计算图、贴近原生 Python 的调试体验,已经成为全球学术界研究和工业界预训练的统治级框架。
- 大模型与智能体工程(Transformers / vLLM / LangChain / LlamaIndex):当下的全新赛道。工作重心从“从头训练模型”转移到了“模型微调(LoRA/PEFT)、张量高效量化(AWQ/FP8)、大并发流式推理(vLLM)以及基于向量库的检索增强生成(RAG)和 Agent 协同”。
2. 典型实战代码示例:利用 Hugging Face 构建企业语义检索(Embedding)流水线
下面是一个在现代 RAG(检索增强生成)与文本相似度分析中极为常见的向量化编码代码。代码演示了从模型加载、批量 Tokenizer 处理到 GPU 张量池化输出的完整流程:
import torch
from transformers import AutoTokenizer, AutoModel

# 1. 检测硬件计算加速设备
device = torch.device("cuda" if torch.cuda.is_available() else ("mps" if torch.backends.mps.is_available() else "cpu"))
print(f"当前计算后端: {device}")

# 2. 加载预训练语义特征模型与分词器 (示例使用开源轻量向量模型)
model_name = "BAAI/bge-small-zh-v1.5"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModel.from_pretrained(model_name).to(device)
model.eval()  # 设置为评估模式,关闭 Dropout

# 3. 准备待编码的企业知识库文本
documents = [
    "Python Web 推荐使用 FastAPI 结合 Pydantic 处理异步 JSON 接口",
    "NumPy 和 Pandas 主要用于处理连续内存结构化表格数据分析",
    "PyTorch 是全球深度学习和通用人工智能大模型研发的核心框架"
]

# 4. 执行批量分词与张量前向传递 (无梯度推断节省显存)
with torch.no_grad():
    inputs = tokenizer(documents, padding=True, truncation=True, max_length=128, return_tensors="pt").to(device)
    outputs = model(**inputs)
    # 提取 [CLS] token 作为整句的高维语义表征 (768 维稠密向量)
    sentence_embeddings = outputs.last_hidden_state[:, 0, :]
    # L2 归一化,便于后续直接使用点积计算余弦相似度
    normalized_embeddings = torch.nn.functional.normalize(sentence_embeddings, p=2, dim=1)

print(f"输出特征矩阵形状: {normalized_embeddings.shape}")
# 示例:计算文档 0 与文档 1、2 之间的语义关联度
similarity_matrix = torch.matmul(normalized_embeddings, normalized_embeddings.T)
print("文档间余弦相似度矩阵 (示例输出):")
print(similarity_matrix.cpu().numpy().round(3))五、三大方向综合对比与技术路径选择指南
理解了三大方向的技术特征后,读者最常面临的实际困惑是:“我的个人背景或业务目标应该优先选择哪一个方向深入?”
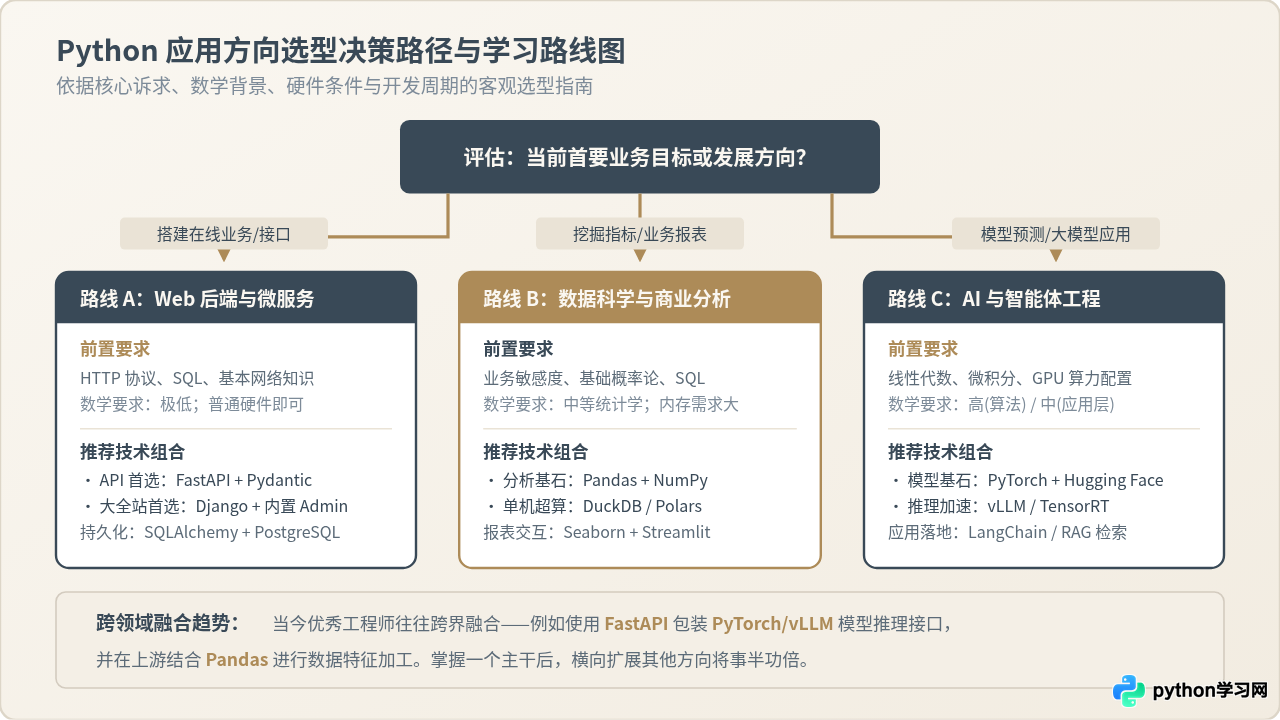
1. 三大方向核心维度横向比对
| 比对维度 | 方向一:Web 后端开发 | 方向二:数据科学与分析 | 方向三:AI 与机器学习 |
|---|---|---|---|
| 前置基础要求 | HTTP/REST、网络协议、SQL 关系型数据库、异步事件循环机制 | 概率论基础、描述性统计学、多维表格转换思维、SQL 查询能力 | 高等数学(线性代数、微积分)、梯度优化、GPU 硬件调度原理 |
| 硬件设备门槛 | 极低。普通笔记本电脑(8G/16G 内存)即可顺畅开发部署 | 中等。取决于单机数据规模,通常要求 16GB~32GB 以上大内存 | 较高。模型训练与本地推理高度依赖高性能 NVIDIA 独立显卡(CUDA) |
| 反馈与调试周期 | 极短(秒级)。代码修改后浏览器即刻刷新查看返回 JSON 结果 | 短(交互式)。Jupyter Notebook 中分块执行,交互式即时呈现图表 | 较长(分钟到天级)。Epoch 训练周期长,收敛指标需持续监控 |
| 典型企业业务产出 | 在线 SaaS 系统、开放平台网关、企业 ERP/CRM 后台、小程序接口 | 经营看板、核心运营日报、用户生命周期模型、归因分析报告 | 欺诈识别风控引擎、知识库智能问答 Agent、自动缺陷质检算法 |
| 适合切入的人群 | 计算机专业基础扎实、希望从事通用互联网服务开发的工程师 | 业务分析师、产品经理、金融/统计/管理学科转码或需要量化赋能者 | 理工科背景扎实、立志攻克前沿算法或从事 AI 原生应用开发的开发者 |
2. 初学者容易陷入的认知误区
在实际规划路线时,建议避开以下三个常见的理解陷阱:
-
误区一:“学 Python 必须先把 Web、数据分析、AI 全学一遍”
事实:这三个方向的深水区完全不同。盲目并行只会导致样样通、样样松。正确的做法是:以 Python 基础语法(面向对象、装饰器、异常、包管理)为唯一公约数,随后立即选择一条主线深耕,直到能独立完成一个完整的端到端项目。 -
误区二:“Python 执行速度慢,做 Web 和高并发完全不行”
事实:Web 系统的瓶颈通常在数据库查询和网络 I/O 等待,而非 CPU 指令执行时间。基于asyncio的 FastAPI 单机可以轻松维持上万个并发连接。对于 95% 以上的中小企业业务,Python 的开发效率优势远大于语言层面的纳秒级耗时。 -
误区三:“搞 AI 只需要写 Prompt,不需要懂 Python 代码”
事实:Prompt 只能完成基础对话;真正将大模型落地为高可用企业产品,需要用 Python 编写高并发 API、处理向量数据库检索召回、实现动态路由和复杂的多智能体状态机。工程能力始终是算法落地的护城河。
总结
Python 能够历经三十余年长盛不衰,核心在于其优雅的高层抽象与强大底层原生扩展能力的完美融合。
对于需要快速交付在线业务与接口的团队,FastAPI 与 Django 是兼顾效率与规范的高效利器;对于渴望从数据中挖掘商业价值的分析师,NumPy 与 Pandas 提供了无出其右的矢量计算与清洗表达力;而在重塑软件形态的人工智能浪潮中,PyTorch 与 Hugging Face 构成了全球科研与前沿算法的共同语言。明确你的具体业务诉求与资源约束,沿着对应的工程路径由浅入深,才能真正将 Python 的生态威力转化为可靠的生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















