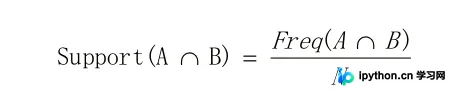
Python数据挖掘核心技能:从数据处理到模型实战
本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。



本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
本文分享一个基于Python的电商平台销售数据分析实战项目。内容涵盖数据预处理、探索性分析、深度挖掘及可视化报告生成。通过Pandas、NumPy、Matplotlib等工具,解析销售趋势、用户行为及产品表现,为业务决策提供数据支持,适合后端开发者巩固数据分析技能。
本文深入解析Apriori关联规则算法的核心概念,包括支持度、置信度和提升度的计算逻辑及其业务意义。通过啤酒与尿布、股票预测及风控策略等案例,展示算法在数据挖掘中的实际应用。最后提供基于Python efficient-apriori库的完整代码示例,演示如何挖掘频繁项集与关联规则,帮助读者掌握这一经典数据挖掘工具。
本文深入解析Python中的关联规则分析,涵盖支持度、置信度和提升度等核心概念,详细阐述Apriori算法的迭代逻辑。通过mlxtend库的完整代码示例,演示数据预处理、频繁项集挖掘及关联规则生成的全过程,帮助读者掌握从理论到实战的应用技能。