


Python主要应用领域有哪些?Web、数据分析与AI项目案例
全面解析Python三大核心应用领域:Web开发、数据分析与人工智能。结合FastAPI微服务、Pandas电商指标分析及机器学习客户预测三大可运行案例,系统阐明技术栈选型与工程实践。
Python凭借其极其精炼的语法规则、完备的标准库以及庞大的开源第三方生态,在当今软件工程与数字化产业中确立了三大核心支柱领域:Web后端与API开发、数据分析与商业智能(BI),以及人工智能与机器学习(AI/ML)。本文直接聚焦这三大领域的实际分工、主流技术选型与工程实现,分别配套给出具备可运行逻辑的代表性项目案例,帮助读者厘清Python在各方向的真实落地路径。
一、Web 后端开发:从单体系统到现代异步微服务
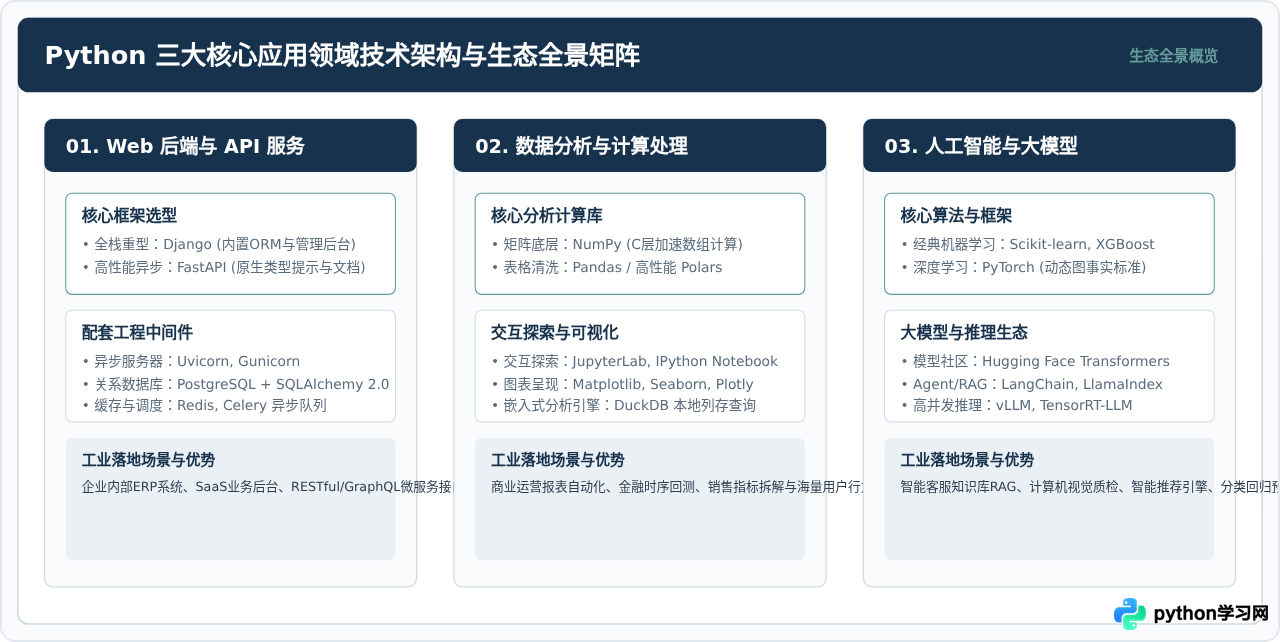
在Web开发领域,Python主要承担服务端核心业务逻辑、数据库交互、数据接口定义以及安全认证职责。与传统PHP或Java相比,Python因表达力强、代码周转速度快,被广泛应用于互联网原型研发及企业级SaaS系统的业务中台搭建。
1. 主流框架选型策略
- FastAPI:现代Python Web的首选。基于ASGI标准(Asynchronous Server Gateway Interface),基于标准类型注解(Type Hints)驱动,天然具备异步非阻塞高并发能力,且自动生成符合OpenAPI规范的交互式接口文档。
- Django:具备“自带电池”(Batteries-Included)理念的全栈重型框架,内建强大的对象关系映射(ORM)、用户权限体系和自动化管理后台(Django Admin),极适合需要快速上线后台管理系统的中大型系统。
- Flask:微框架代表,核心极其轻巧,给予开发者自由组合数据库驱动和认证组件的完全控制权。
2. 实战项目案例:基于 FastAPI 构建高吞吐商品查询与下单接口
下面是一个标准的现代化FastAPI项目示例,展示了路由声明、基于Pydantic的数据输入验证与状态码控制流程:
# main.py
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import List, Optional

app = FastAPI(
    title="电商微服务产品与订单中心",
    version="1.0.0"
)

# 1. 定义数据契约(Schema),自动完成请求校验与序列化
class Product(BaseModel):
    id: int
    name: str = Field(..., min_length=2, max_length=50, description="商品名称")
    price: float = Field(..., gt=0, description="商品价格,必须大于0")
    stock: int = Field(default=0, ge=0, description="库存数量")

class OrderCreate(BaseModel):
    product_id: int
    quantity: int = Field(..., gt=0, description="订购数量")

# 模拟内存数据存储
fake_products_db = {
    101: {"id": 101, "name": "机械键盘", "price": 499.0, "stock": 25},
    102: {"id": 102, "name": "4K显示器", "price": 1899.0, "stock": 8}
}

# 2. 查询商品详情端点
@app.get("/api/v1/products/{product_id}", response_model=Product)
async def get_product(product_id: int):
    product = fake_products_db.get(product_id)
    if not product:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail="请求的商品不存在"
        )
    return product

# 3. 提交订单扣减库存端点
@app.post("/api/v1/orders", status_code=status.HTTP_201_CREATED)
async def create_order(order: OrderCreate):
    product = fake_products_db.get(order.product_id)
    if not product:
        raise HTTPException(status_code=404, detail="关联商品不存在")
    if product["stock"] < order.quantity:
        raise HTTPException(status_code=400, detail="商品库存不足")

    # 执行库存扣减
    product["stock"] -= order.quantity
    total_amount = product["price"] * order.quantity
    return {
        "status": "success",
        "order_id": "ORD-20261017-001",
        "total_amount": total_amount,
        "remaining_stock": product["stock"]
}启动服务命令:uvicorn main:app --host 127.0.0.1 --port 8000 --reload。
服务就绪后,直接在浏览器访问 http://127.0.0.1:8000/docs 即可获得基于Swagger UI的可视化测试界面,完全无需手动编写API测试脚手架。
二、数据分析与处理:从杂乱流水到多维商业洞察
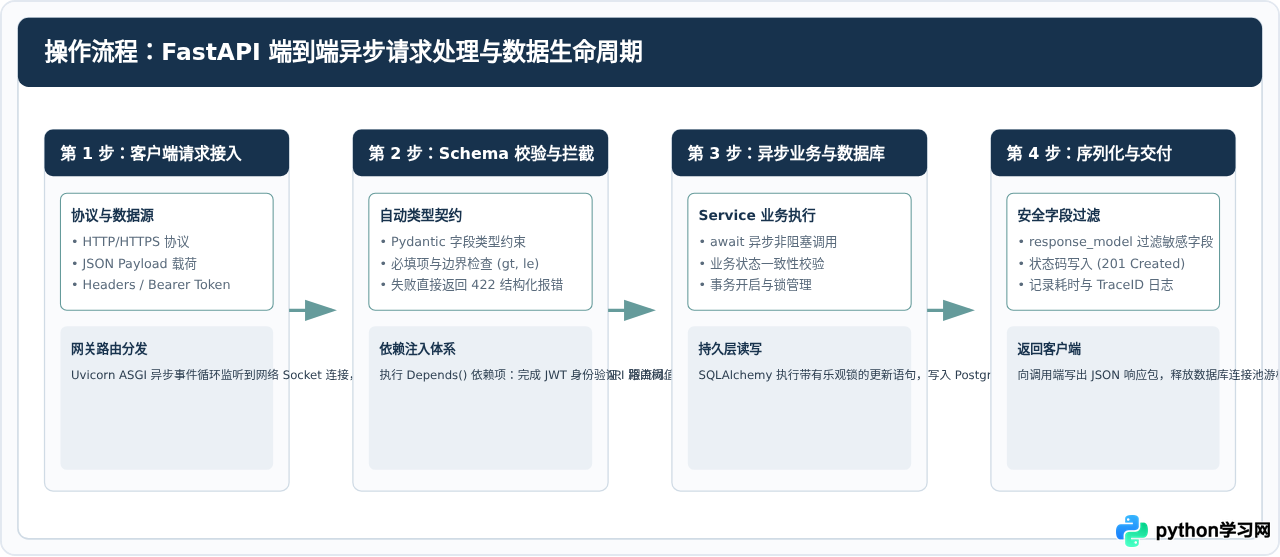
数据分析是Python最具统治力的领域。无论是在金融量化机构、跨国零售电商还是科研院所,Python凭借 NumPy(C层连续内存加速计算)和 Pandas(强大的DataFrame数据规整工具),形成了从数据提取(Extract)、清洗转换(Transform)到聚合分析(Aggregate)的完整工具链。
1. 数据分析核心工具链
- Pandas / Polars:处理结构化二维表格的核心。Pandas适合千万行以内的复杂索引与时间序列计算;Polars基于Rust开发,支持多线程并行与延迟计算(Lazy Execution),适合超千万行级大数据吞吐。
- DuckDB:现代嵌入式分析型数据库,支持通过SQL直接高效查询Parquet或Pandas内存对象,免除复杂的数据库服务器部署。
- Matplotlib & Seaborn:生成发表级静态图表与探索性数据可视化图。
2. 实战项目案例:电商全渠道销售流水清洗与多维指标聚合
以下代码模拟处理一份存在脏数据、缺失值和格式混乱的真实电商交易日志,通过清洗过滤、数据类型转换,最终计算各品类和渠道的核心商业指标(总GMV、有效订单数及客单价):
# data_analysis.py
import pandas as pd
import numpy as np

# 1. 模拟原始异构销售数据(包含缺失值、非法字符和异常金额)
raw_data = {
    "order_id": ["O-101", "O-102", "O-103", "O-104", "O-105", "O-106", "O-107"],
    "channel": ["线上官网", "APP端", "线上官网", "线下自提", "APP端", np.nan, "线上官网"],
    "category": ["办公外设", "影音娱乐", "办公外设", "手机配件", "办公外设", "手机配件", "影音娱乐"],
    "raw_amount": ["¥499.00", "¥1,899.00", "无效金额", "¥79.50", "¥320.00", "¥120.00", "¥-50.00"],
    "is_refunded": [False, False, False, False, False, True, False]
}

df = pd.DataFrame(raw_data)

# 2. 管道化数据清洗与规整
# 2.1 填补缺失渠道
df["channel"] = df["channel"].fillna("未知渠道")

# 2.2 清洗金额字符串:剔除人民币符号与千分符,转为纯浮点数,非法值转为NaN
clean_amount = (
    df["raw_amount"]
    .str.replace("¥", "", regex=False)
    .str.replace(",", "", regex=False)
)
df["amount"] = pd.to_numeric(clean_amount, errors="coerce")

# 2.3 业务规则过滤:剔除无效金额、负数金额,以及已退款订单
valid_orders = df[
    (df["amount"] > 0) &
    (~df["amount"].isna()) &
    (df["is_refunded"] == False)
].copy()

# 3. 多维度商业指标聚合(分组计算订单数、总营收GMV、均单价)
summary_report = valid_orders.groupby(["channel", "category"]).agg(
    order_count=("order_id", "count"),
    total_gmv=("amount", "sum"),
    average_order_value=("amount", "mean")
).reset_index()

# 4. 格式化输出最终统计表
summary_report["total_gmv"] = summary_report["total_gmv"].round(2)
summary_report["average_order_value"] = summary_report["average_order_value"].round(2)

print("--- 电商有效订单各维度统计结果 ---")
print(summary_report.to_string(index=False))通过 pd.to_numeric(..., errors="coerce") 优雅处理异常脏文本,将“无效金额”自动标记为 NaN;利用布尔索引切片保留有效交易,再通过 groupby().agg() 在一次扫描中并行计算出汇总GMV与客单价,具备高运行效率与代码可维护性。
三、人工智能与机器学习:工业算法工程化落地
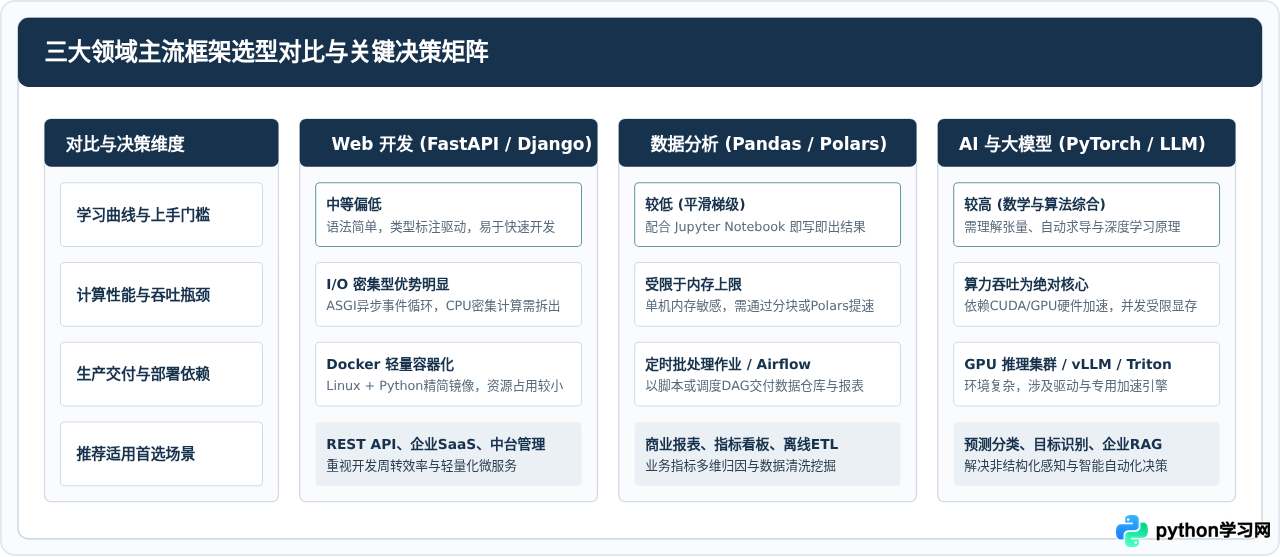
Python在AI领域的垄断地位建立在底层的计算生态之上。从Scikit-learn代表的经典统计学习算法,到PyTorch统治的深度神经网络,再到当下大语言模型(LLM)的微调与Agent应用开发,Python几乎是连接算法底层算力(CUDA/C++)与上层业务的唯一“通用技术胶水”。
1. 典型应用分支与技术矩阵
| 技术分支 | 代表类库与框架 | 核心任务场景 | 工程化落地关键关注点 |
|---|---|---|---|
| 经典机器学习 | Scikit-learn, LightGBM, XGBoost | 信贷风控评分、客户流失预警、房产价格回归 | 特征工程质量、特征泄露防范、模型可解释性 (SHAP) |
| 深度学习与视觉 | PyTorch, torchvision, OpenCV | 工业缺陷检测、人脸核身、医学影像分割 | GPU显存优化、张量批处理、ONNX格式导出 |
| 大模型与Agent | Transformers, LangChain, vLLM | 企业知识库RAG、智能对话助理、代码辅助生成 | 向量检索召回率、提示词工程、Token并发吞吐 |
2. 实战项目案例:客户流失风险分类预测系统
以下示例使用 scikit-learn 构建一个端到端的可运行分类模型:通过标准化特征工程、训练逻辑回归(Logistic Regression)模型,并输出精确率(Precision)、召回率(Recall)及综合评估指标:
# churn_predictor.py
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, roc_auc_score

# 1. 模拟生成结构化客户行为样本数据集 (1000个客户样本,5个核心指标)
# 指标特征:[注册月数, 近30天登录次数, 累计消费金额, 客服投诉次数, 活跃度得分]
np.random.seed(42)
n_samples = 1000

features = np.random.randn(n_samples, 5)
# 设定内部规律模拟真实流失标签:投诉多、消费少、活跃低的客户更容易流失(y=1)
logits = (
    -0.8 * features[:, 0]  # 注册越久越稳定
    - 1.2 * features[:, 1]  # 登录越频繁越不易流失
    - 0.5 * features[:, 2]  # 消费越多越不易流失
    + 1.5 * features[:, 3]  # 投诉越多极易流失
    - 0.9 * features[:, 4]  # 活跃度高不易流失
)
probabilities = 1 / (1 + np.exp(-logits))
labels = (probabilities > 0.5).astype(int)

# 2. 划分训练集与测试集(80% 训练,20% 验证)
X_train, X_test, y_train, y_test = train_test_split(
    features, labels, test_size=0.2, random_state=42, stratify=labels
)

# 3. 数据特征标准化(缩放至均值0,方差1,防止数值量纲偏差)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 模型初始化与拟合训练
model = LogisticRegression()
model.fit(X_train_scaled, y_train)

# 5. 模型推断与性能评估
y_pred = model.predict(X_test_scaled)
y_prob = model.predict_proba(X_test_scaled)[:, 1]

print("=== 客户流失预测模型测试集评估报告 ===")
print(classification_report(y_test, y_pred, target_names=["留存客户", "流失预警"]))
print(f"ROC-AUC 综合得分: {roc_auc_score(y_test, y_prob):.4f}")

# 6. 新进单个客户实时推断模拟
new_customer = np.array([[1.2, 0.2, 0.5, 2.8, -0.4]])  # 投诉较多且活跃度低的客户
new_customer_scaled = scaler.transform(new_customer)
risk_prob = model.predict_proba(new_customer_scaled)[0, 1]
print(f"\n[实时预警] 该目标客户的流失风险概率为: {risk_prob * 100:.2f}%")
四、工程化闭环:三大领域的协同落地架构
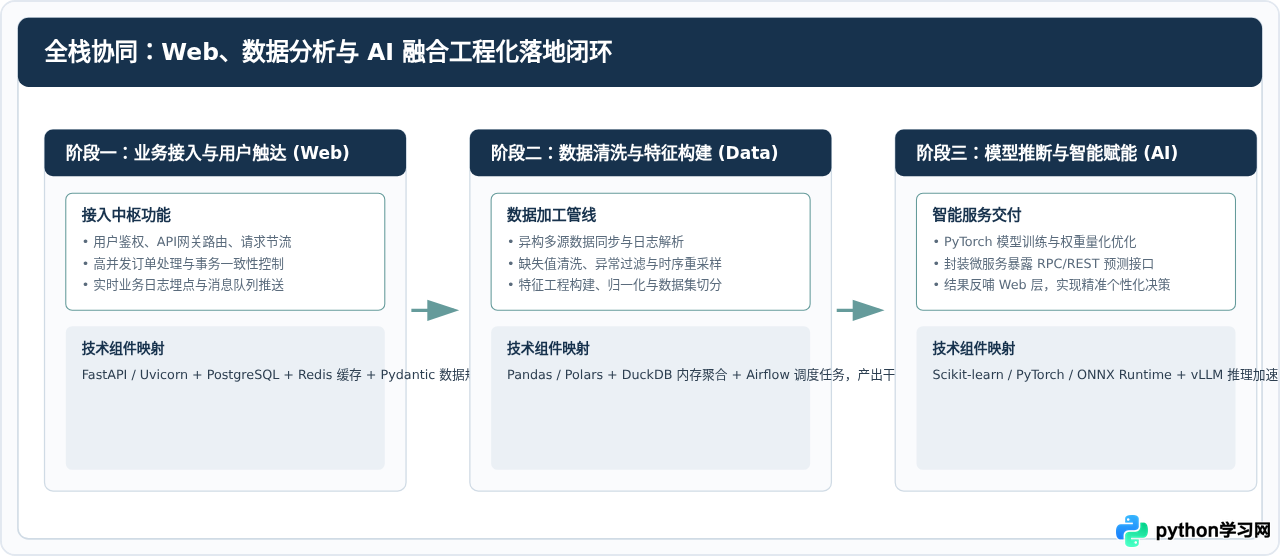
在现代化工业级项目中,Web、数据分析与AI通常不是割裂存在的,而是形成互相协作的全栈工程闭环:
- 前端与接入层(Web领域):FastAPI/Django充当对外门户,承接用户交互指令与业务数据流,确保鉴权与低延迟响应。
- 数据流转与离线分析(数据领域):将业务日志归档至数据湖,由Pandas/DuckDB/Spark进行离线清洗与特征衍生,为模型提供高质量样本。
- 算法智能决策(AI领域):PyTorch/Scikit-learn训练产出的模型通过标准化格式(如ONNX或TorchScript)封装为预测微服务,供Web服务实时调用,并将推断结果回流至业务闭环。
五、开发者常见误区与避坑建议
- 误区一:脱离业务场景盲目追求重型技术。例如在仅需要几张静态报表的场景强行引入复杂的分布式系统;或者在一个仅需简单规则拦截的场景强行训练深度神经网络。应当优先使用
Pandas或FastAPI的内建能力,按需向上升级。 - 误区二:在异步 Web 服务中混用阻塞代码。在
FastAPI的async def路由中直接执行耗时的纯同步计算或未经异步包装的文件I/O,会导致全局事件循环被卡死。耗时计算应当放入后台工作进程(如 Celery)或通过run_in_threadpool执行。 - 误区三:忽略数据泄露与标准化顺序。在机器学习流程中,必须在
train_test_split拆分后再对训练集调用fit_transform,并对测试集使用transform,严禁在整体数据集上先做全局归一化,否则会造成虚高的验证表现并在上线后失效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















