


Python在数据分析与AI中的应用:Pandas、NumPy与深度学习生态

深入解析Python在现代数据分析与人工智能开发中的协同应用,系统讲解NumPy连续内存与向量化、Pandas结构化清洗与特征转换、零拷贝张量构建以及PyTorch深度学习生态全链路实践。
Python 能够成为当今数据分析与人工智能领域的通用语言,核心在于其分工严密且高效衔接的技术生态:底层由 NumPy 借助 C 语言连续内存块与 SIMD 向量化运算提供极致的数值吞吐,中层由 Pandas 封装高维标签索引以支撑复杂异构表格的清洗与特征加工,顶层则由 PyTorch、TensorFlow 等深度学习框架承接张量流转、自动求导与硬件加速。理解这三者之间的协同路径与内存桥梁,是构建工业级 AI 数据流与训练管线的基础。
一、NumPy:底层数值计算基石与内存布局机制
在探索高层机器学习之前,首先需要厘清原生 Python 列表在密集运算中的性能瓶颈。Python 原生列表本质上是一个指针数组,列表中的每个元素是指向堆内存中独立 PyObject 的指针。这种离散寻址结构不仅带来了庞大的对象头元数据开销,更导致 CPU 缓存预取失效(Cache Miss 频发)。
NumPy 通过引入 ndarray(N 维数组)彻底重构了数据存储形态。NumPy 数组在内存中占据一块连续分配的物理缓冲区(C-contiguous 或 Fortran-contiguous),并在数组头部保存数据类型(dtype)、形状(shape)与跨步步长(strides)。这种布局使得 CPU 能够通过单一连续指令载入数据,并充分利用现代处理器的 AVX/SSE 指令集执行单指令多数据(SIMD)向量化并行操作。
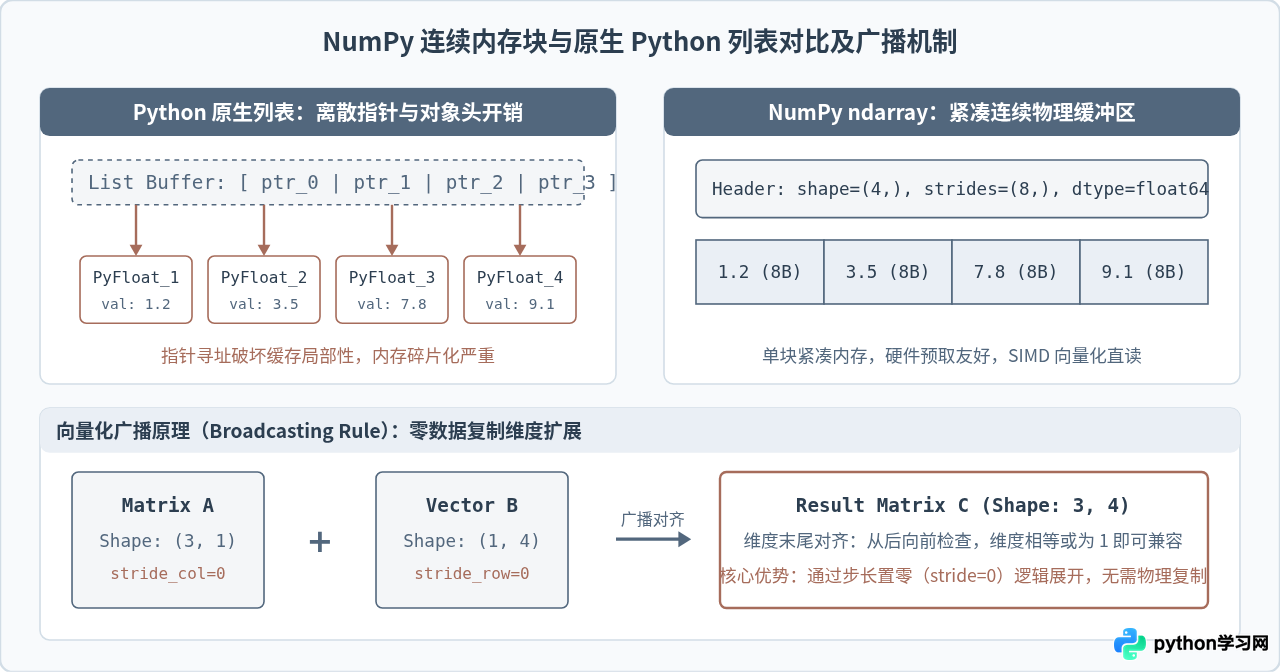
除了连续内存布局,NumPy 的另一个核心机制是广播(Broadcasting)。当两个数组进行算术运算时,若其形状不同,NumPy 会在符合规则的前提下,将较小维度的数组在逻辑上扩展以匹配较大形状。这种扩展完全通过将对应维度的步长(stride)设置为 0 实现,运算过程中无需复制数据,从而在避免内存剧烈扩张的同时完成批量矩阵运算。
import numpy as np

# 1. 连续数组的创建与步长探查
arr_2d = np.array([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]], dtype=np.float32)
print("数组形状:", arr_2d.shape)          # (2, 3)
print("步长字节 (bytes):", arr_2d.strides) # (12, 4) -> 跨行需跳过12字节,跨列需跳过4字节

# 2. 向量化运算与广播机制
col_vector = np.array([[10.0], [20.0]], dtype=np.float32) # shape: (2, 1)
result = arr_2d + col_vector                               # shape: (2, 3)
print("广播结果:\n", result)
np.float64),但在深度学习模型训练中,GPU 显存带宽与张量核心(Tensor Core)对 32 位浮点(np.float32)及半精度浮点(np.float16/bfloat16)有强烈的硬件倾斜。在特征输入阶段显式将类型限定为 float32,可直接降低 50% 的显存占用。
二、Pandas:结构化数据清洗、重塑与特征工程
虽然 NumPy 为同质数值计算提供了高性能底座,但现实工程中的真实数据往往极度不规则:包含字符串标签、时间序列、分类枚举以及大量的缺失值(NaN)。Pandas 正是为了解决这种异构表格数据而设计。
Pandas 的核心数据结构是 DataFrame 与 Series。在其内部实现中,DataFrame 并非一个简单的二维对象,而是依赖 BlockManager(在现代版本中逐步演化为更为高效的 ArrayManager)进行列式管理:相同数据类型的列会被组织在同一个底层的 NumPy 数组块中。这种设计使得按列执行统计、转换和筛选具备接近原生 C 的处理速度。
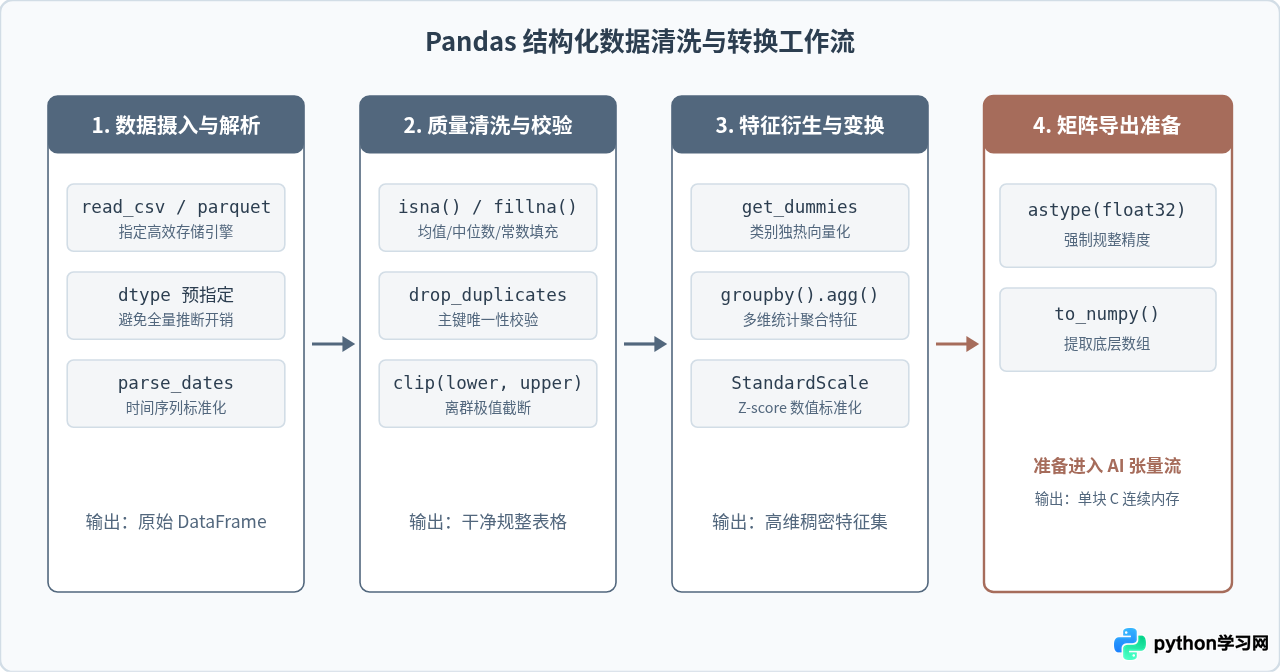
在实际操作中,高效的 Pandas 代码应尽量避免逐行遍历(如 iterrows() 或循环 loc 赋值),而采用链式调用或向量化聚合函数:
import pandas as pd
import numpy as np

# 构建示例业务数据
raw_data = {
    'user_id': [1001, 1002, 1003, 1004],
    'age': [24, np.nan, 35, 29],
    'city': ['Beijing', 'Shanghai', 'Beijing', 'Shenzhen'],
    'spending': [120.5, 450.0, np.nan, 310.2]
}
df = pd.DataFrame(raw_data)

# 1. 缺失值填充与类型收敛
clean_df = (
    df.assign(
        age=lambda d: d['age'].fillna(d['age'].median()).astype(np.float32),
        spending=lambda d: d['spending'].fillna(0.0).astype(np.float32)
    )
)

# 2. 类别特征独热编码 (One-Hot Encoding)
feature_df = pd.get_dummies(clean_df, columns=['city'], dtype=np.float32)

# 3. 提取特征矩阵与标签
feature_cols = [c for c in feature_df.columns if c != 'user_id']
X_clean = feature_df[feature_cols].to_numpy(dtype=np.float32)
print("提取出的特征矩阵形状:", X_clean.shape) # (4, 5)
.copy() 或统一通过 .loc[row_indexer, col_indexer] = value 表达,切忌链式索引 df[cond]['col'] = val。链式赋值会导致 Pandas 无法确认返回的是视图(View)还是副本(Copy),进而引发隐蔽的静默修改失败。
三、衔接与流转:从表格特征到深度学习张量
深度学习框架(如 PyTorch 或 TensorFlow)不直接处理包含列名和索引的 Pandas 表格,它们的操作单元是张量(Tensor)。张量与 NumPy 数组在数学与内存概念上高度同构,二者之间的流转效率直接决定了数据加载管线(DataLoader)的吞吐表现。
在 PyTorch 生态中,通过 torch.from_numpy() 函数可以将 NumPy 数组无缝转换为 PyTorch 张量。关键在于:当 NumPy 数组在内存中是 C 连续且数据类型兼容时,此操作是完全零拷贝(Zero-Copy)的。PyTorch 张量与原 NumPy 数组共享同一段物理内存空间,修改其中一方的值将即时同步影响另一方。
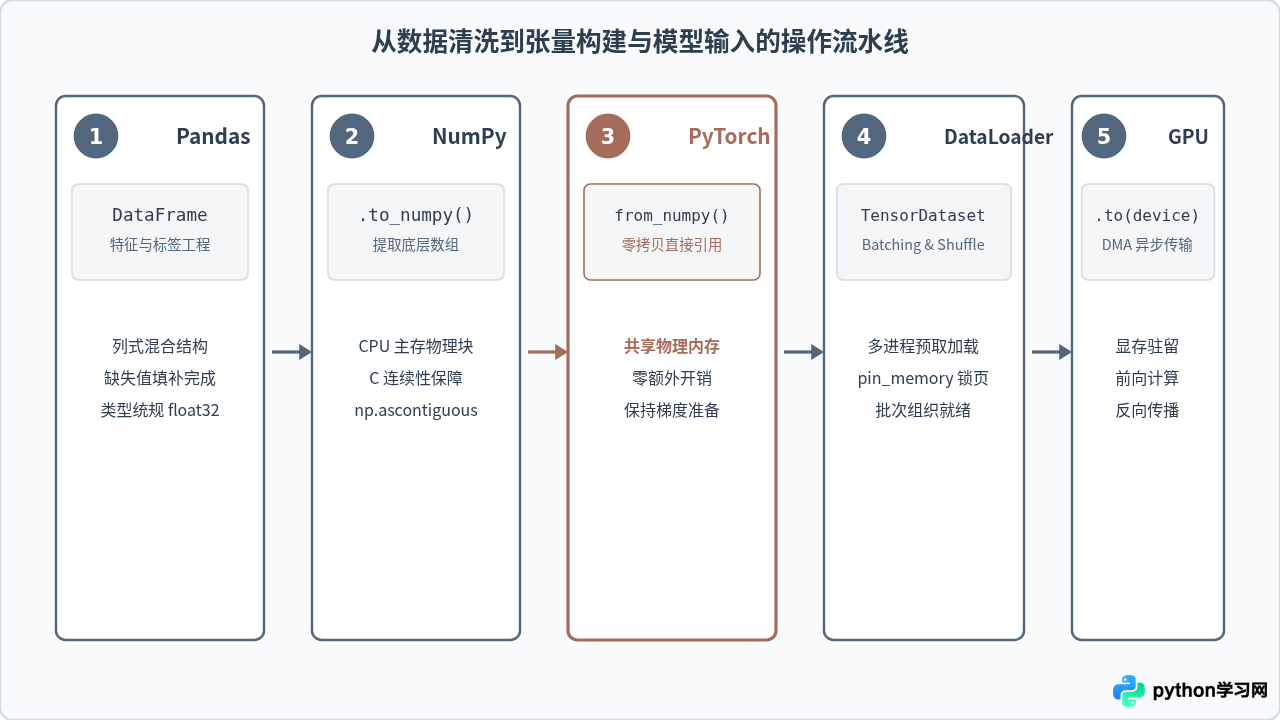
以下代码演示了从 Pandas 特征表格平滑导出为 PyTorch 张量并挂载到数据管道的标准范式:
import torch
from torch.utils.data import TensorDataset, DataLoader
import numpy as np

# 假定 X_np 为已清洗好的 NumPy 数组,y_np 为标签
X_np = np.random.randn(1000, 16).astype(np.float32)
y_np = np.random.randint(0, 2, size=(1000, 1)).astype(np.float32)

# 1. 验证 C 连续性(若经过特定步长切片,需显式连续化)
if not X_np.flags['C_CONTIGUOUS']:
    X_np = np.ascontiguousarray(X_np)

# 2. 零拷贝构造 PyTorch 张量
X_tensor = torch.from_numpy(X_np)
y_tensor = torch.from_numpy(y_np)

# 验证内存共享:修改 X_np[0, 0],观察张量是否同变
X_np[0, 0] = 999.0
print("内存共享验证:", X_tensor[0, 0].item() == 999.0) # True

# 3. 封装为标准 PyTorch 数据集与批次加载器
dataset = TensorDataset(X_tensor, y_tensor)
data_loader = DataLoader(
    dataset,
    batch_size=64,
    shuffle=True,
    num_workers=0,      # 多进程环境按核心数调整
    pin_memory=torch.cuda.is_available() # 开启锁页内存加速 CUDA 传输
)
四、深度学习生态协作:计算图、自动微分与模型演进
当张量成功构建并分批导入后,整个系统便进入了由深度学习框架驱动的计算图执行周期。现代深度学习生态以 PyTorch 与 TensorFlow 为主轴,其核心能力包括:动态计算图(Dynamic Computation Graph)、自动微分引擎(Autograd)以及跨异构硬件(CPU/GPU/TPU)的张量调度。
以 PyTorch 的自动微分机制为例:任何设置了 requires_grad=True 的叶子张量在参与矩阵乘法、激活函数或损失计算时,系统都会在后台自动构建有向无环图(DAG)。每个运算符对应一个反向求导节点。当调用 loss.backward() 时,梯度信息顺着计算图链式传递,并累加至叶子张量的 .grad 属性中,最终供优化器(如 AdamW、SGD)更新网络权重。
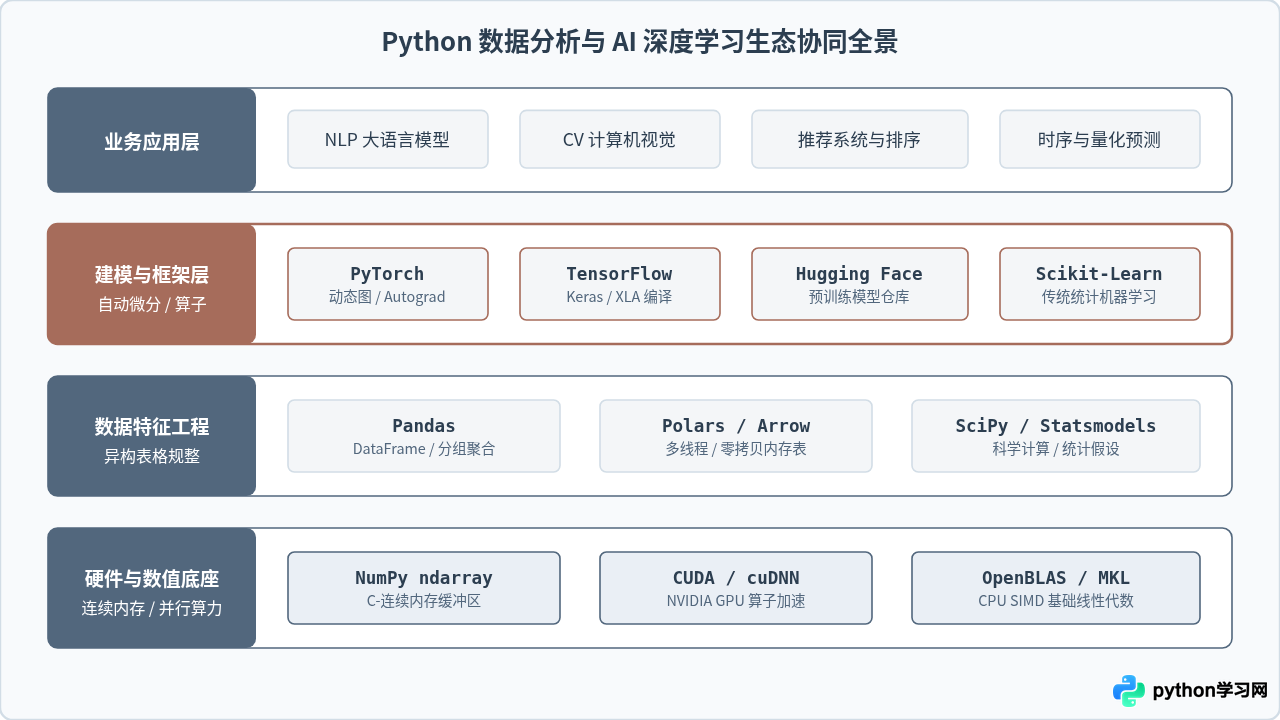
以下为一个精简但完备的模型前向传播与反向传播训练闭环代码,展示各环节的具体协作方式:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 定义小型神经网络
class SimpleMLP(nn.Module):
    def __init__(self, in_features, out_features):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_features, 32),
            nn.ReLU(),
            nn.Linear(32, out_features)
        )
    def forward(self, x):
        return self.net(x)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = SimpleMLP(in_features=16, out_features=1).to(device)
criterion = nn.BCEWithLogitsLoss()
optimizer = optim.AdamW(model.parameters(), lr=1e-3)

# 2. 单轮训练循环 (Training Epoch Loop)
model.train()
for batch_idx, (batch_x, batch_y) in enumerate(data_loader):
    # 将批次张量推入目标计算设备
    batch_x = batch_x.to(device, non_blocking=True)
    batch_y = batch_y.to(device, non_blocking=True)

    # 梯度清零 -> 前向传播 -> 计算损失 -> 反向传播 -> 权重步进
    optimizer.zero_grad(set_to_none=True) # set_to_none 相比 zero_grad() 性能更高
    predictions = model(batch_x)
    loss = criterion(predictions, batch_y)
    loss.backward()
    optimizer.step()

    if batch_idx % 5 == 0:
        print(f"Batch {batch_idx:02d} | Loss: {loss.item():.4f}")
五、工程实践中的典型陷阱与优化建议
在打通从 Pandas 到深度学习框架的全流程时,若仅关注逻辑通畅而忽视底层细节,容易引发性能瓶颈或静默计算错误。以下是需要重点关注的工程细节:
- 类型隐式提升与显存溢出:Pandas 在混合数值与缺失值时,常自动将整数列升级为
float64。在转换为张量前,应显式执行.astype(np.float32)。未降精度的float64会使张量显存翻倍,且无法激活 Tensor Core 的混合精度算力。 - 非连续内存导致的意外数据拷贝:经过复杂列重排或跨步切片后,NumPy 数组可能不再满足
C_CONTIGUOUS。此时调用某些转换函数会静默触发全量深拷贝。在导出数组后通过np.ascontiguousarray()确认连续性,可以消除隐藏的内存峰值。 - DataLoader 多进程下的重复随机种子:当
num_workers > 0时,每个子进程可能会继承相同的随机种子,导致各 worker 生成完全相同的数据增强样本。建议在DataLoader中配置worker_init_fn,确保每个工作进程独立生成随机序列。 - 梯度累积中的内存泄漏:记录日志时,务必使用
loss.item()提取标量数值,切忌直接将loss对象追加到全局 Python 列表。由于张量对象保留着完整的计算图引用,直接追加会导致计算图历史无法被垃圾回收机制释放,最终导致显存爆满(OOM)。
从 NumPy 的紧凑内存结构,到 Pandas 的灵活数据流转,再到 PyTorch 的张量计算图,Python 数据科学体系通过清晰的分层抽象实现了效率与开发体验的平衡。掌握这一协同链条,不仅能写出更稳健的数据清洗代码,也能在处理更大规模的深度学习模型时从容应对性能瓶颈。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















