


Python中消除readlines读取文件时行尾\n的方法

本文介绍在Python中使用readlines读取文件时,如何有效去除每行末尾的换行符\n。通过对比join+strip、splitlines以及逐行strip三种方法,分析其适用场景与注意事项,帮助开发者选择最合适的字符串处理方案。
测试代码
#!/ust/bin/env python3

f = open("name.txt")
date = f.readlines()
print(date)
f.close()
运行结果如下:
输出内容为:['eray\n', 'eray\n', 'bike\n']
可以看到打印结果中每行末尾都带有 \n 字符,如何将其去除?
解决方法如下: 方案一:
f = open("name.txt")
date = f.read().splitlines()
print(date)
f.close()
运行结果: ['eray', 'eray', 'bike']
方案二:
f = open("name.txt")
date = f.readlines()
#date = date.strip('\n')
date = ''.join(date).strip('\n')
print(date)
f.close()
运行结果:
eray eray bike
在方案二中,如果注释掉以下代码行: #date = date.strip('\n') 将会导致如下错误:
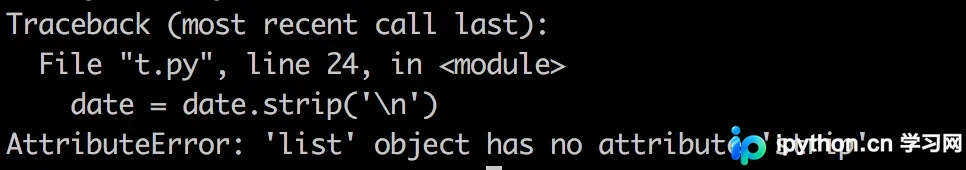
错误原因:
报错信息指出列表(list)对象没有 strip 属性。由于 strip 是字符串(string)的方法,而 f.readlines() 返回的是列表,因此直接对列表调用 strip 会引发异常。
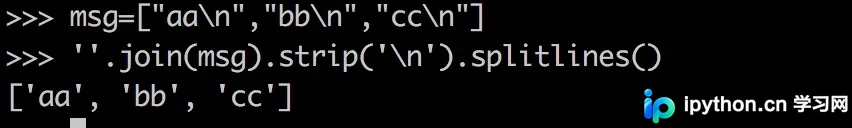
既然 f.readlines() 返回的是列表,而 strip 属于字符串属性,我们可以先将列表转换为字符串,再使用 strip 方法。将列表转换为字符串的一种方式是使用字符串的 join 方法。
line = ''.join(line) 通过上述方式,列表成功转换为字符串。
方案一:直接使用字符串的 splitlines 方法
示例代码如下:
strip 函数的具体用法:
函数原型
声明:s 为字符串,rm 为要删除的字符序列
s.strip(rm) 删除字符串 s 开头和结尾处,位于 rm 删除序列中的字符
s.lstrip(rm) 删除字符串 s 开头处,位于 rm 删除序列中的字符
s.rstrip(rm) 删除字符串 s 结尾处,位于 rm 删除序列中的字符
注意事项:
1. 当 rm 参数为空时,默认删除空白字符(包括 '\n', '\r', '\t', ' ')
每天问问搬砖的自己,跟咸鱼有什么两样。
本站小编补充:
# -*- coding: utf-8 -*-
# 打开文件
fo = open("jb51.txt", "r")
print("文件名为: ",fo.name)

for line in fo.readlines():       #依次读取每行
 line = line.strip()        #去掉每行头尾空白
 print ("读取的数据为: %s" % (line))

# 关闭文件
fo.close()
line = line.strip() 用于去掉每行头尾的空白字符
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















