


Python常用代码片段大全:文件操作、字符串处理与时间转换模板

在日常 Python 脚本开发、自动化运维以及数据处理任务中,文件读写、字符串清洗与格式化、以及时间日期的解析转换是调用频次最高的三大基础操作。熟练掌握经过生产检验的规范代码模板,不仅可以免去反复翻查技术手册的繁琐,更能从源头上杜绝文件句柄泄漏、跨平台编码乱码、字符串拼接性能劣化以及跨时区计算错误等常见隐患。本文系统梳理这三大领域的核心场景,提供开箱即用的实用代码片段与架构逻辑解析。
一、文件与路径操作实用模板
文件处理的核心原则是“安全、可预测与资源自闭合”。在现代 Python(Python 3.6+)中,推荐优先采用面向对象的 pathlib.Path 处理路径,结合上下文管理器 with open(...) 确保系统文件句柄在任何异常情况下均能妥善释放。
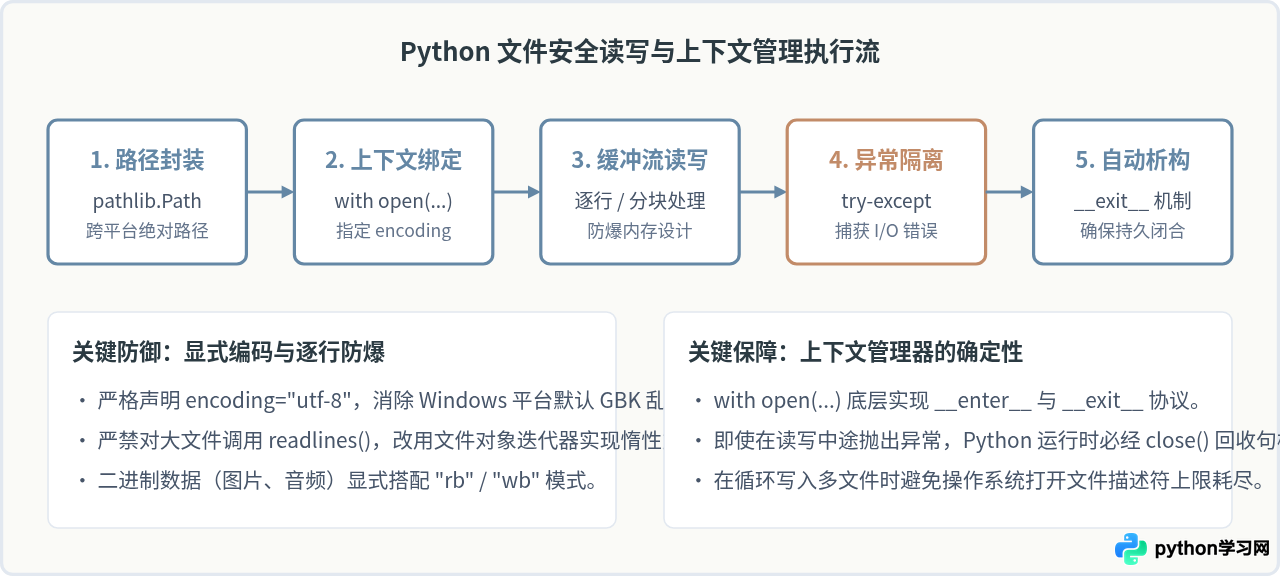
1. 现代化路径操作与目录管理(pathlib)
相比于传统的 os.path 字符串拼接,pathlib 提供了跨平台路径对象,使用 / 运算符直接拼接路径,更加直观且安全。
from pathlib import Path

# 1. 获取当前脚本所在绝对路径与项目根路径
current_dir = Path(__file__).resolve().parent
project_root = current_dir.parent

# 2. 跨平台路径拼接与目录创建
data_dir = project_root / "data" / "processed"
data_dir.mkdir(parents=True, exist_ok=True)  # parents=True 级联创建,exist_ok=True 避免已存在报错

# 3. 递归检索特定格式文件
csv_files = list(data_dir.rglob("*.csv"))

# 4. 文件属性判断与元信息获取
target_file = data_dir / "sample.txt"
if target_file.exists() and target_file.is_file():
    size_in_bytes = target_file.stat().st_size
    filename = target_file.name          # 带后缀的文件名
    stem = target_file.stem              # 不带后缀的主文件名
    extension = target_file.suffix        # 文件后缀扩展名
2. 文本文件安全读写与大文件逐行处理
针对常规文本文件与 GB 级超大日志文件,读写方式应区分对待。超大文件切勿使用 f.read() 或 f.readlines(),否则容易导致系统内存耗尽(OOM)。
from pathlib import Path

file_path = Path("large_server_log.txt")

# 模式 A:普通中小型文件安全写入与覆盖
def write_text_safely(path: Path, content: str) -> None:
    # 显式指定 utf-8 编码,避免平台差异导致的乱码
    with open(path, mode="w", encoding="utf-8") as f:
        f.write(content)

# 模式 B:超大文件流式逐行读取(内存占用恒定极小)
def process_large_file_line_by_line(path: Path) -> int:
    matched_lines_count = 0
    try:
        with open(path, mode="r", encoding="utf-8") as f:
            for line_number, line in enumerate(f, start=1):
                # 逐行剥离末尾换行符
                clean_line = line.rstrip("\r\n")
                if "ERROR" in clean_line:
                    matched_lines_count += 1
    except FileNotFoundError:
        print(f"目标文件不存在: {path}")
    except UnicodeDecodeError as e:
        print(f"解码失败,请确认文件编码格式: {e}")
    return matched_lines_count
3. JSON 与 CSV 结构化数据读写模板
数据交换中最常见的 JSON 与 CSV 格式,均应遵循标准库最佳配置规范,特别注意 CSV 写入时的 newline="" 参数,以防在 Windows 系统下产生冗余空行。
import json
import csv
from pathlib import Path
from typing import Any, Dict, List

# JSON 安全写入与读取
def save_json(path: Path, data: Dict[str, Any]) -> None:
    with open(path, mode="w", encoding="utf-8") as f:
        # ensure_ascii=False 确保中文字符以可读形式保存,indent=2 便于阅读
        json.dump(data, f, ensure_ascii=False, indent=2)

def load_json(path: Path) -> Dict[str, Any]:
    with open(path, mode="r", encoding="utf-8") as f:
        return json.load(f)

# CSV 字典格式读写
def save_csv_records(path: Path, records: List[Dict[str, Any]], fieldnames: List[str]) -> None:
    # newline="" 必须声明,防止跨平台换行解析出现双重换行
    with open(path, mode="w", encoding="utf-8", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(records)

def load_csv_records(path: Path) -> List[Dict[str, str]]:
    with open(path, mode="r", encoding="utf-8", newline="") as f:
        reader = csv.DictReader(f)
        return [row for row in reader]
二、高频字符串处理与文本清洗模板
Python 中的 str 是不可变对象(immutable)。每一次对字符串的替换、裁剪都会生成新对象。因此在文本清洗与大规模流水线处理中,合理选用原生的字符串方法与正则表达式能够带来显著的性能提升。
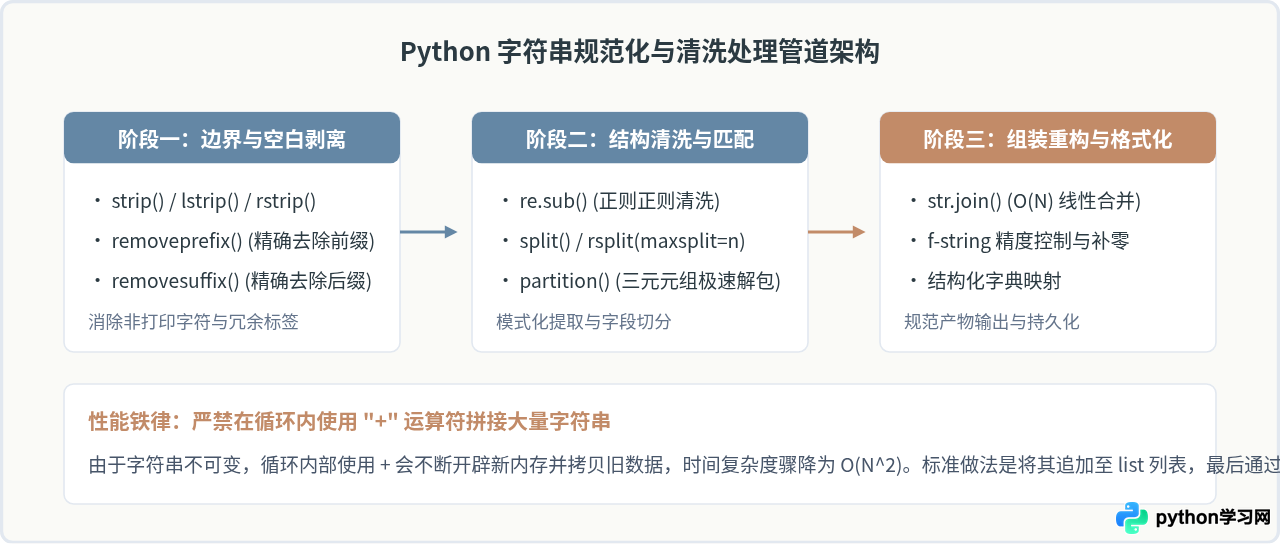
1. 边界剥离、安全前缀与后缀处理
在 Python 3.9 之前,许多开发者误用 lstrip() 或 rstrip() 剥离前后缀,而这两个函数实际上是按字符集合进行贪婪剔除,极易导致意外截断。Python 3.9+ 引入了语义明确的 removeprefix() 与 removesuffix()。
raw_text = "  ===Python_API_Response_v2.json===  \n"

# 1. 常规空白与指定字符清除
clean_text = raw_text.strip().strip("=")  # "Python_API_Response_v2.json"

# 2. 区分 lstrip 误区与 removeprefix
sample = "www.example.com"
# 错误示范:sample.lstrip("w.") 会剔除所有属于 'w' 和 '.' 的字符集合
safe_domain = sample.removeprefix("www.")   # "example.com"
safe_stem = "data_backup.tar.gz".removesuffix(".tar.gz")  # "data_backup"

# 3. 三元分段:比 split 更轻量的分隔方案
url = "https://api.domain.com/v1/users?id=100"
scheme, separator, path = url.partition("://")
# scheme -> "https", separator -> "://", path -> "api.domain.com/v1/users?id=100"
2. 正则表达式清洗与高频提取模板
对于涉及多重空白、特殊符号过滤或特定格式识别的场景,标准库 re 是最强大的工具。多次复用的正则模式应使用 re.compile() 预编译以节省解析开销。
import re

# 预编译常用正则规则
RE_MULTI_SPACES = re.compile(r"\s+")
RE_CHINESE_ONLY = re.compile(r"[^\u4e00-\u9fa5A-Za-z0-9_]")
RE_EMAIL = re.compile(r"^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$")

def clean_noisy_text(content: str) -> str:
    # 步骤 1:将连续的空格、制表符、换行符折叠为单个空格
    collapsed = RE_MULTI_SPACES.sub(" ", content).strip()
    # 步骤 2:去除所有非中文、英文字母、数字和下划线的杂质字符
    purified = RE_CHINESE_ONLY.sub("", collapsed)
    return purified

# 提取文本中所有手机号
raw_document = "联系方式:张三 13800138000,李四 13912345678,非手机 010-12345678"
phone_pattern = re.compile(r"(?<!\d)1[3-9]\d{9}(?!\d)")
extracted_phones = phone_pattern.findall(raw_document)
# extracted_phones -> ['13800138000', '13912345678']
3. f-string 高级格式化与排版模板
f-string(Formatted string literals)是目前兼具可读性与执行效率的最优格式化手段,支持直接在花括号内执行对齐、补零、浮点数精度截断以及千分位分隔。
value = 1234567.89123
ratio = 0.8542
item_id = 42

# 1. 浮点精度与千分位分隔符
formatted_currency = f"¥{value:,.2f}"      # "¥1,234,567.89"
formatted_percent = f"{ratio:.1%}"         # "85.4%"

# 2. 数字左侧补零(如工号、ID编号)
formatted_id = f"ID_{item_id:06d}"         # "ID_000042"

# 3. 文本对齐与填充宽幅(构建对齐日志或终端表格)
title = "Report"
left_aligned = f"{title:<15}"              # "Report         "
center_aligned = f"{title:^15}"            # "    Report     "
banner = f"{title:=^20}"                   # "=======Report======="

# 4. 日期对象的直接内联格式化(无需显式 strftime)
import datetime
today = datetime.date(2026, 10, 20)
date_str = f"Date: {today:%Y/%m/%d}"       # "Date: 2026/10/20"
三、日期时间解析、转换与时区处理模板
时间处理的核心在于理清四种形态:**时间戳(Timestamp)**、**时间文本(String)**、**本地朴素时间(Naive datetime)** 与 **感知时区时间(Aware datetime)**。混淆 naive 与 aware 对象是跨地区系统最普遍的缺陷来源。
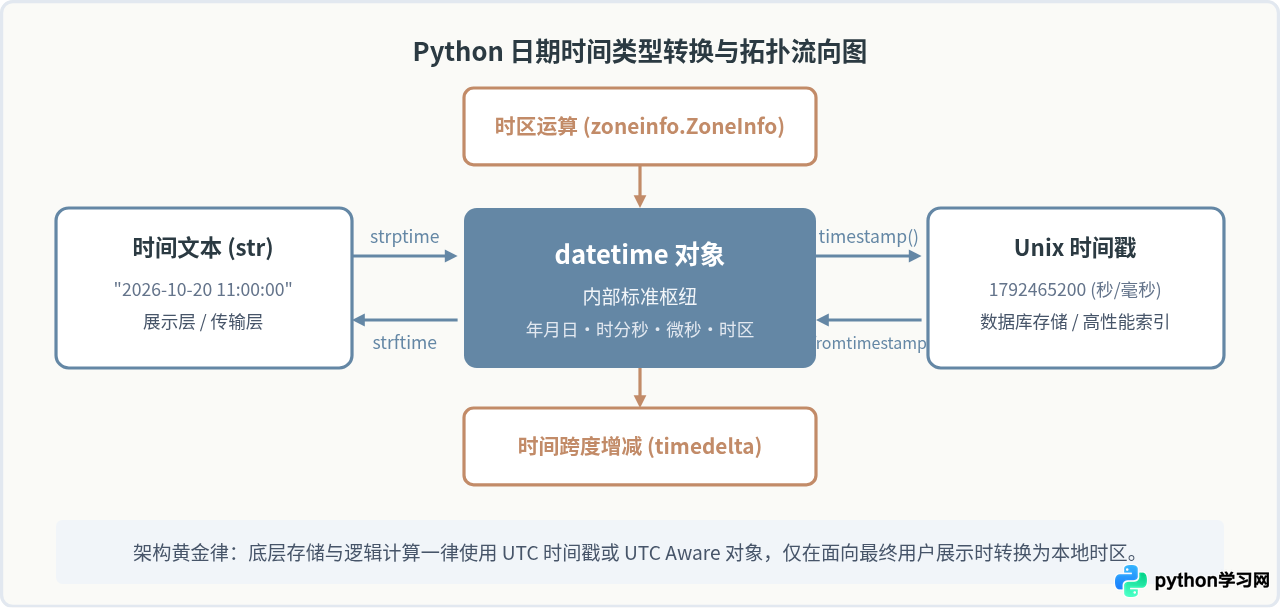
1. 字符串、时间戳与 datetime 互转模板
时间互转的关键是区分解析(strptime,Parse String)与格式化(strftime,Format String)。常见通配符中,%Y 代表四位年份,%m 代表两位月份,%d 代表日,%H 代表 24 小时制小时,%M 代表分钟,%S 代表秒。
from datetime import datetime
import time

# 1. 字符串解析为 datetime 对象
time_str = "2026-10-20 11:30:45"
dt_obj = datetime.strptime(time_str, "%Y-%m-%d %H:%M:%S")

# 2. datetime 格式化为自定义字符串或 ISO 8601
formatted_str = dt_obj.strftime("%Y年%m月%d日 %H点%M分")  # "2026年10月20日 11点30分"
iso_str = dt_obj.isoformat()                             # "2026-10-20T11:30:45"

# 3. datetime 转换为 Unix 时间戳(秒级 float)
timestamp_seconds = dt_obj.timestamp()                   # 1792467045.0
timestamp_ms = int(timestamp_seconds * 1000)             # 毫秒级整数时间戳

# 4. 时间戳还原为 datetime 对象
restored_dt = datetime.fromtimestamp(timestamp_seconds)
2. 时间间隔与跨度计算(timedelta)
严禁使用乘以 86400 秒的手动计算方式处理天数变化,因为夏令时转换与润秒可能会导致计算失准。datetime.timedelta 是标准、安全的时间偏移工具。
from datetime import datetime, timedelta

now = datetime.now()

# 1. 计算过去与未来的时间点
seven_days_ago = now - timedelta(days=7)
three_hours_later = now + timedelta(hours=3, minutes=15)

# 2. 计算两个时间点之间的差距
event_time = datetime(2026, 12, 31, 23, 59, 59)
duration = event_time - now

print(f"相距天数: {duration.days} 天")
print(f"剩余总秒数: {duration.total_seconds():.1f} 秒")

# 3. 产生连续的日期序列(常用于数据报表拉取)
start_date = datetime(2026, 10, 1)
end_date = datetime(2026, 10, 5)
date_range = []
curr = start_date
while curr <= end_date:
    date_range.append(curr.strftime("%Y-%m-%d"))
    curr += timedelta(days=1)
# date_range -> ['2026-10-01', '2026-10-02', '2026-10-03', '2026-10-04', '2026-10-05']
3. 时区感知时间转换模板(Python 3.9+ zoneinfo)
在 Python 3.9 之后,内置的 zoneinfo 模块正式取代了第三方库 pytz,成为标准官方时区解决方案。处理带时区时间的关键是:永远不要在朴素时间上直接 replace 错误的时区,而应先绑定基准时区,再通过 astimezone 进行物理时区转换。
from datetime import datetime, timezone
from zoneinfo import ZoneInfo

# 1. 获取当前 UTC 时间(Aware 时区感知对象)
utc_now = datetime.now(timezone.utc)

# 2. 安全转换为指定时区(如北京时间 Asia/Shanghai 与 纽约时间 America/New_York)
beijing_tz = ZoneInfo("Asia/Shanghai")
ny_tz = ZoneInfo("America/New_York")

beijing_time = utc_now.astimezone(beijing_tz)
ny_time = utc_now.astimezone(ny_tz)

print(f"UTC 时间:   {utc_now}")
print(f"北京时间:   {beijing_time}")
print(f"纽约时间:   {ny_time}")

# 3. 将没有时区的文本安全解析并附带时区属性
naive_str = "2026-10-20 14:00:00"
naive_dt = datetime.strptime(naive_str, "%Y-%m-%d %H:%M:%S")

# 正确做法:确知该时间为北京时间,显式赋予其时区属性
aware_beijing_dt = naive_dt.replace(tzinfo=beijing_tz)
# 随后可平滑转为 UTC 存储入库
target_utc_dt = aware_beijing_dt.astimezone(timezone.utc)
四、综合实战案例:日志文件流式解析与规范化导出
下面是一个将文件流式读取、字符串正则清洗提取与时间转换串联起来的生产级脚本模板。该脚本从源日志文件中逐行检索异常日志,提取其中的 IP 地址、非标时间字符串,将其统一格式化为 ISO 8601 标准并附带北京时区,最后流式写入新的 CSV 结构化文件。
import re
import csv
from pathlib import Path
from datetime import datetime
from zoneinfo import ZoneInfo

# 正则表达式匹配形如:[20/Oct/2026:11:22:33] IP: 192.168.1.50 - Msg: User login failure
LOG_PATTERN = re.compile(
    r"\[(?P<raw_time>[^\]]+)\]\s+IP:\s+(?P<ip>\d{1,3}(?:\.\d{1,3}){3})\s+-\s+Msg:\s+(?P<msg>.*)"
)

def process_log_pipeline(input_log_path: Path, output_csv_path: Path) -> int:
    beijing_tz = ZoneInfo("Asia/Shanghai")
    processed_count = 0
    fieldnames = ["standard_iso_time", "client_ip", "cleaned_message"]

    # 保证源文件与目标文件在上下文管理器中同步安全流转
    with open(input_log_path, mode="r", encoding="utf-8") as fin, \
         open(output_csv_path, mode="w", encoding="utf-8", newline="") as fout:

        writer = csv.DictWriter(fout, fieldnames=fieldnames)
        writer.writeheader()

        for line in fin:
            match = LOG_PATTERN.search(line)
            if not match:
                continue

            # 1. 提取字段
            raw_time_str = match.group("raw_time")  # e.g., "20/Oct/2026:11:22:33"
            client_ip = match.group("ip")
            raw_msg = match.group("msg")

            # 2. 时间解析与时区补全
            try:
                parsed_time = datetime.strptime(raw_time_str, "%d/%b/%Y:%H:%M:%S")
                aware_time = parsed_time.replace(tzinfo=beijing_tz)
                standard_time = aware_time.isoformat()
            except ValueError:
                # 时间格式异常兜底机制
                standard_time = ""

            # 3. 字符串清洗
            clean_msg = raw_msg.strip().replace("\t", " ")

            # 4. 写入 CSV 记录
            writer.writerow({
                "standard_iso_time": standard_time,
                "client_ip": client_ip,
                "cleaned_message": clean_msg
            })
            processed_count += 1

    return processed_count
五、核心要点速查与防御规范
为便于日常开发查验与复用,下表将本文三大领域的最优调用习惯与高危操作进行系统对照:
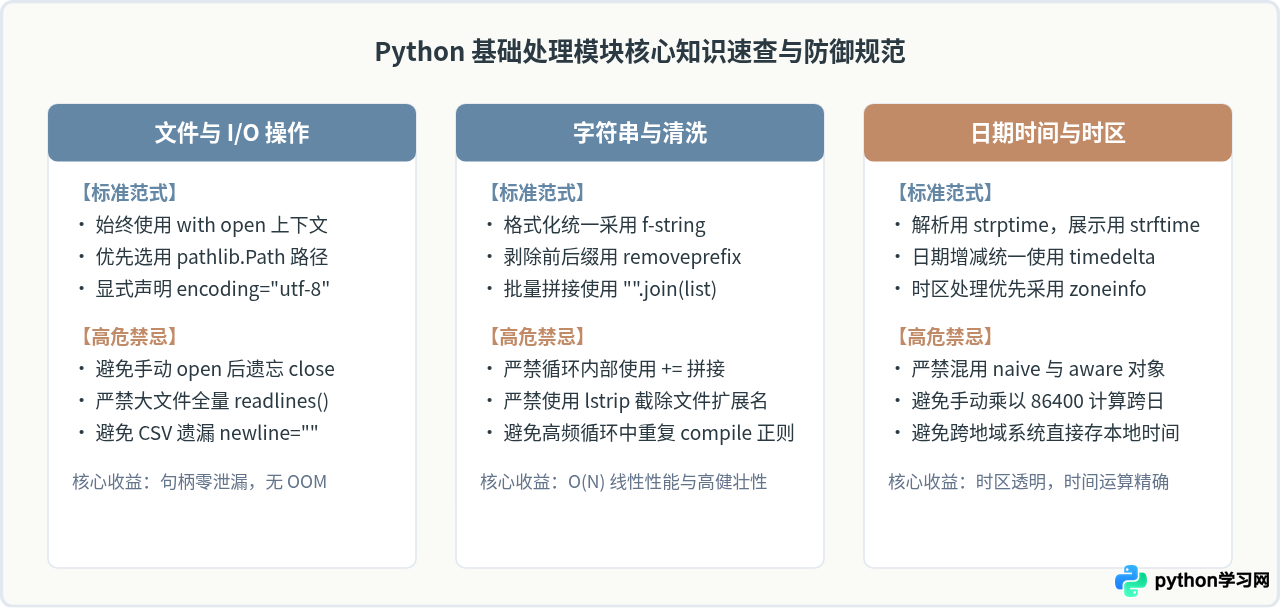
| 操作类别 | 推荐标准库 / 方法 | 关键核心参数 / 语法 | 主要规避风险 |
|---|---|---|---|
| 路径处理 | pathlib.Path |
Path.resolve() / .mkdir(parents=True) |
操作系统平台分隔符 / 与 \ 混淆问题 |
| 文件读写 | with open(...) |
mode="r", encoding="utf-8" |
Windows 默认编码 GBK 导致 UnicodeDecodeError |
| 大文件读取 | 文件迭代器 | for line in f: 惰性遍历 |
内存耗尽崩溃(Out Of Memory) |
| 前后缀剥离 | str.removeprefix / suffix |
精确匹配去除 | str.lstrip / rstrip 字符集误剪裁 |
| 字符串合并 | str.join() |
"".join(list_of_strings) |
循环内 += 导致的 $O(N^2)$ 性能瓶颈 |
| 时间间隔运算 | datetime.timedelta |
timedelta(days=n, hours=h) |
夏令时切换与月份天数不均计算错误 |
| 跨国时区转换 | zoneinfo.ZoneInfo |
dt.astimezone(ZoneInfo("...")) |
Naive 朴素时间在不同服务器环境下的歧义 |
总结:编写高效稳定的 Python 代码,本质在于善用标准库经过高度优化的底层协议。文件操作依托 with 与 pathlib 建立坚固屏障;字符串处理利用 f-string、join 与语义化剥离保障吞吐性能;时间转换依托 datetime、timedelta 与 zoneinfo 统一时区度量。将上述模板融入日常工程实践,能够显著提升代码质量与系统的可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















