


Python实现网页图片批量下载与分辨率筛选

发布时间:2026-10-13 |
1人浏览过
本文介绍利用Python从指定网页批量下载图片,并通过PIL库筛选出符合1920x1080分辨率图片的方法。针对网页原图数量不足的情况,文中提及使用格式工厂进行转换补充。代码包含获取HTML、正则匹配图片链接、下载保存及遍历筛选删除不符合尺寸文件的完整流程。
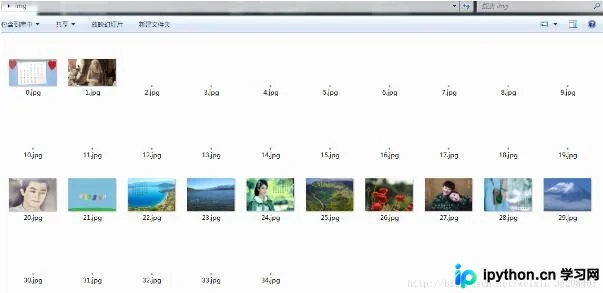
在进行压力测试时,发现可用图片资源不足,因此尝试下载网页中的所有图片并筛选出指定分辨率的图片。然而,网页中直接符合指定分辨率的图片数量较少(见下图)。随后,通过格式工厂对图片进行了转换处理。
import urllib.request   # 导入urllib模块
import re     # 导入re模块
import os
from PIL import Image
htmlurl = 'http://www.win4000.com/wallpaper_detail_134824_3.html'
downloadpath = 'C:\\Users\\yaowanjun\\Desktop\\img\\'
def getHTML(htmlurl):
  req = urllib.request.urlopen(htmlurl)
  buf = req.read()
  return buf.decode('utf-8')
def downloadImg(buf):
  req = r'src="(.+?\.jpg)"' #正则表达式,匹配图片格式
  imgreq = re.compile(req) #编译正则表达式
  imglist = re.findall(imgreq, buf)
  # print(imglist)
  x = 0
  if not os.path.isdir(downloadpath):#若没有则创建
    os.makedirs(downloadpath)
  paths = downloadpath
  for imgurl in imglist:
    f = open(paths + str(x) +'.jpg',"wb")  #打开文件
    req = urllib.request.urlopen(imgurl)
    buf = req.read()       #读出文件
    f.write(buf)
    f.close()
    x = x + 1
  return imglist
def saveImg():
  for filenumber in os.walk(downloadpath):
    # print(filenumber[2])
    for files in filenumber[2]:
      # print(files)
      singleimg = Image.open(downloadpath + files)
      singleimg.close()
      #print(singleimg.size, singleimg.width, singleimg.height)
      if singleimg.size == (1920, 1080):
        print(singleimg)
      else:
        os.remove(downloadpath + files)
buf = getHTML(htmlurl)
downloadImg(buf)
saveImg()
执行结果如下:
获取指定网页中的所有图片。
删除不符合指定分辨率的图片后,剩余文件。
以上关于使用Python获取网页中所有图片并筛选指定分辨率的方法分享到此结束,希望能为读者提供有益参考,并欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















