


Python使用requests与json解析Ajax数据实战

本文介绍如何使用Python的requests模块模拟HTTP请求获取Ajax接口数据,并结合内置json模块进行结构化解析。通过高德地图POI查询示例,演示从获取原始文本到提取嵌套字典中具体字段(如名称、地址、经纬度)的完整流程,为处理大量结构化数据提供基础模板。
JSON数据基础与Python处理概述
JSON作为一种轻量级的数据交换格式,常被用作配置文件的标准形式。
在数据处理领域,这类格式的文件是日常工作中频繁接触的对象。
Python语言内置了json模块,使用前只需在代码中导入即可调用。
开发者可以通过内置的帮助函数查看json模块的详细文档说明。
json模块包含load、loads、dump和dumps等常用方法,这些属于Python基础操作,此处不再赘述。
将JSON数据与数据库结合使用,在处理海量数据场景时具有显著优势。
利用Requests获取Ajax接口数据
接下来,我们将正式利用数据挖掘技术对JSON文件进行具体处理。
当前许多网站采用Ajax技术,因此大量数据以XHR(XMLHttpRequest)文件形式存在。
为了直观演示,这里选取一个地图网站作为案例对象。
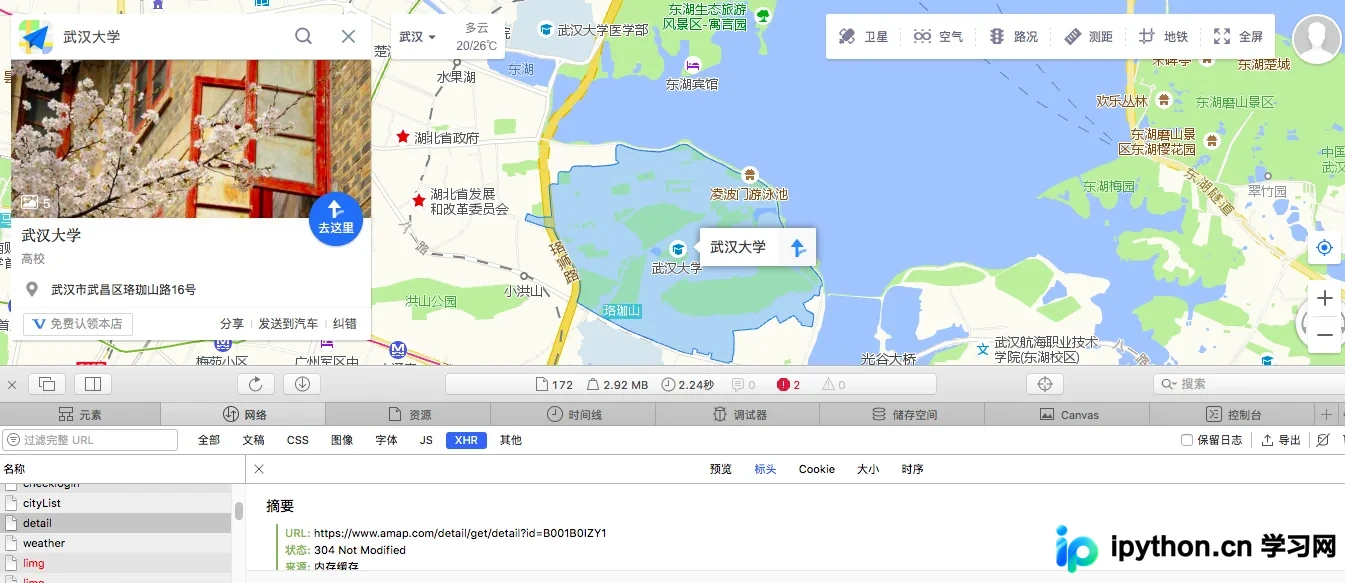
通过浏览器开发者工具调试,我们可以捕获到相关的请求URL地址。
示例URL为:https://ditu.amap.com/service/poiInfo?id=B001B0IZY1&query_type=IDQ
随后,利用requests模块的get方法模拟浏览器发送HTTP请求,并获取返回的结果对象。
具体实现代码如下:
# coding=utf-8
__Author__ = "susmote"

import requests
url = "https://ditu.amap.com/service/poiInfo?id=B001B0IZY1&query_type=IDQ"

resp = requests.get(url)
print(resp.text[0:200])
在终端执行上述代码,输出结果如下所示。
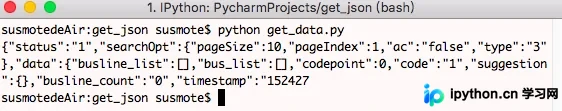
使用Json模块解析数据结构
虽然数据已成功获取,但为了后续使用,必须利用json模块对原始数据进行结构化分析。
解析数据的代码如下:
import requests
import json

url = "https://ditu.amap.com/service/poiInfo?id=B001B0IZY1&query_type=IDQ"

resp = requests.get(url)

json_dict = json.loads(resp.text)

print(type(json_dict))

print(json_dict.keys())
对上述代码进行简要说明:
首先导入json模块,接着调用loads方法,将之前获取的响应文本作为参数传入该方法。
在终端运行该段代码,结果如下:
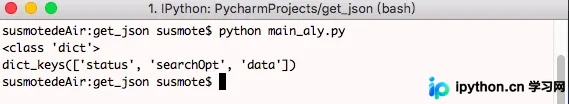
结果显示转换后的对象类型为<class 'dict'>,即与JSON字符串对应的字典结构。
由于对象已是字典类型,我们可以直接调用字典相关方法,例如使用keys方法查看键名。
执行keys方法后,返回三个主要键名:status、searcOpt和data。
接下来,我们将重点查看data键内部包含的具体数据内容。
import requests
import json

url = "https://ditu.amap.com/service/poiInfo?id=B001B0IZY1&query_type=IDQ"

resp = requests.get(url)

json_dict = json.loads(resp.text)

print(json_dict['data'])
在终端中运行以下代码以提取data字段:
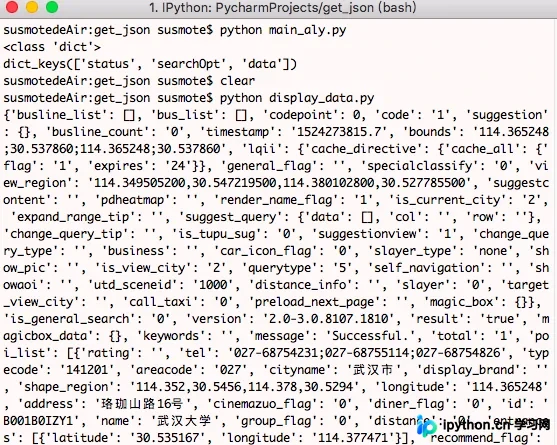
运行结果展示了大量所需数据,例如:
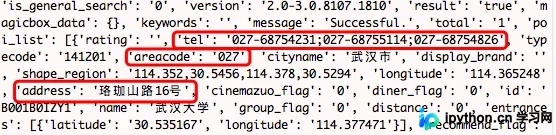
此处未逐一列出所有字段,通过与网页前端显示内容对比,即可明确哪些数据具有实际价值。
提取嵌套数据与模板应用
随后通过代码进一步提取有用信息,并将其清晰格式化输出。
# coding=utf-8
__Author__ = "susmote"

import requests
import json

url = "https://ditu.amap.com/service/poiInfo?id=B001B0IZY1&query_type=IDQ"

resp = requests.get(url)

json_dict = json.loads(resp.text)

data_dict = json_dict['data']

data_list = data_dict['poi_list']

dis_data = data_list[0]

print('城市: ', dis_data['cityname'])
print('名称: ', dis_data['name'])
print('电话: ', dis_data['tel'])
print('区号: ', dis_data['areacode'])
print('地址: ', dis_data['address'])
print('经度: ', dis_data['longitude'])
print('纬度: ', dis_data['latitude'])
由于返回值为字典,经分析发现其结构为“字典嵌套列表,列表再嵌套字典”,通过层层解包即可成功获取目标数据。
为便于理解,此处将处理步骤分步列出,使逻辑更加清晰。
在终端运行该程序,即可获取我们期望的具体信息。
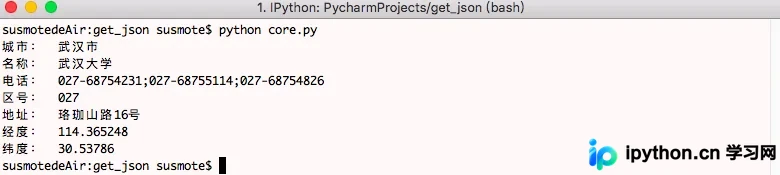
整个过程十分简便,该程序可作为通用模板,在获取其他来源信息时,仅需更换对应的URL即可。
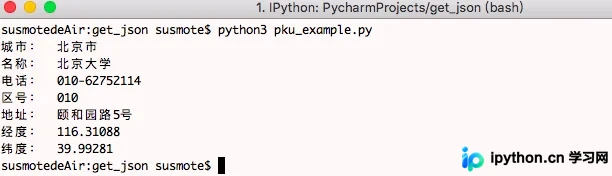
例如,可以参考以下具体案例:
查询地点如“北京大学”。
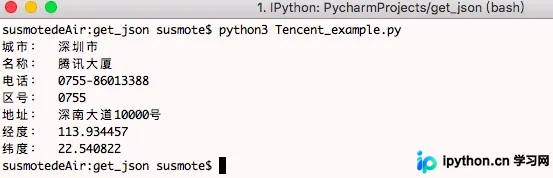
或者查询“腾讯大厦”等地点。
数据挖掘的过程永无止境,希望大家多进行数据分析,从中挖掘出有价值的信息。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















