


Python requests爬虫完整代码实例:网页获取、解析与数据存储
编写一个网络爬虫的核心任务,本质上是把互联网中松散的超文本页面转化为本地可查询、可复用的结构化数据。这一过程由三个清晰串联的步骤组成:通过 HTTP 协议向目标服务器请求网页源码(获取)、从复杂的 HTML 结构中定位并抽取目标字段(解析),以及将清洗后的字段按固定格式写入本地文件或数据库(存储)。本文将基于 Python 官方推荐的 requests 库与 BeautifulSoup 解析工具,提供完整的工程化代码实例,并深入剖析网络请求头伪装、字符编码排错、DOM 容错抽取以及安全落盘等关键细节。
一、爬虫整体工作链路与架构划分
很多初学者在编写爬虫脚本时,往往把网络请求、页面解析和文件写入杂糅在同一个函数甚至同一个循环体中。一旦遇到网络波动或某个页面标签缺失,整个程序就会崩溃中断,导致已抓取的数据丢失或损坏。因此,在动笔写代码前,必须建立模块化解耦的工程意识。
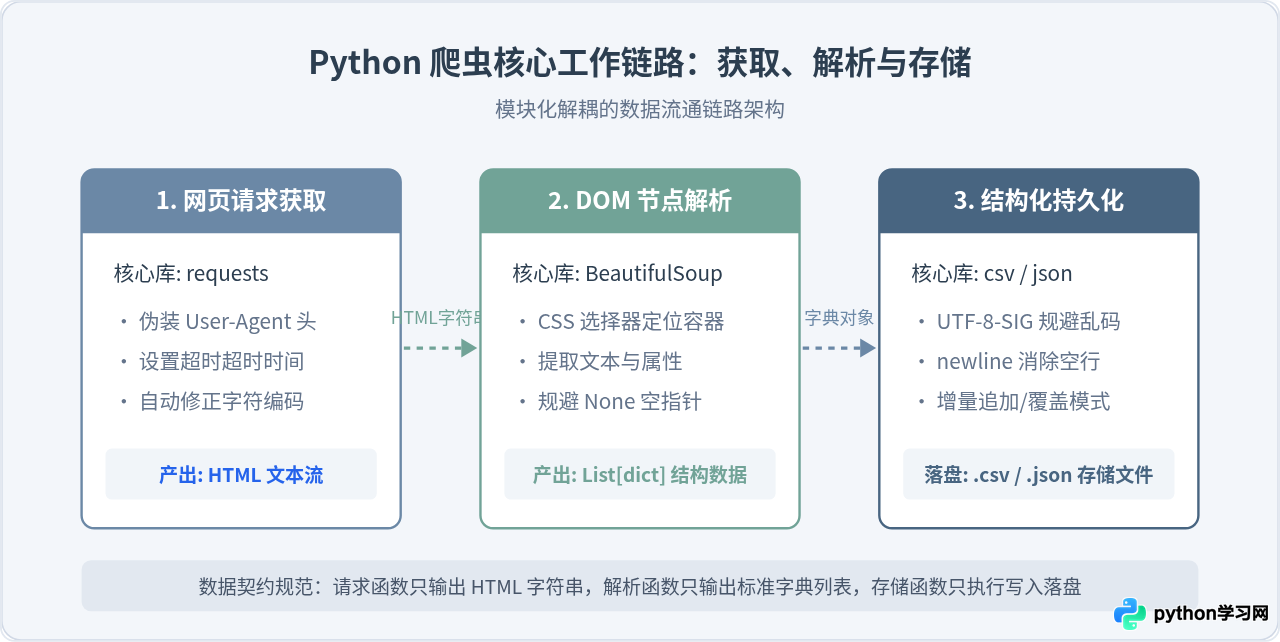
标准爬虫流程的各阶段分工严格清晰:
- 网页请求模块(Fetch):负责与网络底层交互。重点处理 HTTP 请求头伪装、设置合理的连接与读取超时、捕获网络异常、自动判定并修复字符集编码。它唯一交付给下游的产物就是纯 HTML 文本字符串。
- DOM 解析模块(Parse):负责文本解析与特征提取。接收 HTML 字符串后,构建 DOM 树,通过 CSS 选择器定位每一行数据的外层容器,并对子节点中的标题、链接、发布时间等进行防空值提取,产出结构整齐的字典列表(
List[dict])。 - 存储落盘模块(Save):负责数据持久化。接收解析出的字典列表,根据需要选择写入 CSV 格式供数据分析使用,或写入 JSON 格式供程序交换调用,必须保障编码格式与写入锁安全。
二、第一阶段:使用 requests 发起 HTTP 请求与获取网页
在 Python 环境中发起网络请求,官方标准库 urllib 语法相对冗长,而第三方库 requests 以其高度人性化的 API 成为事实上的行业标准。要发起一次稳定可靠的 HTTP 请求,不能只简单调用 requests.get(url),必须配置基础防护参数。
1. 请求头伪装与 User-Agent
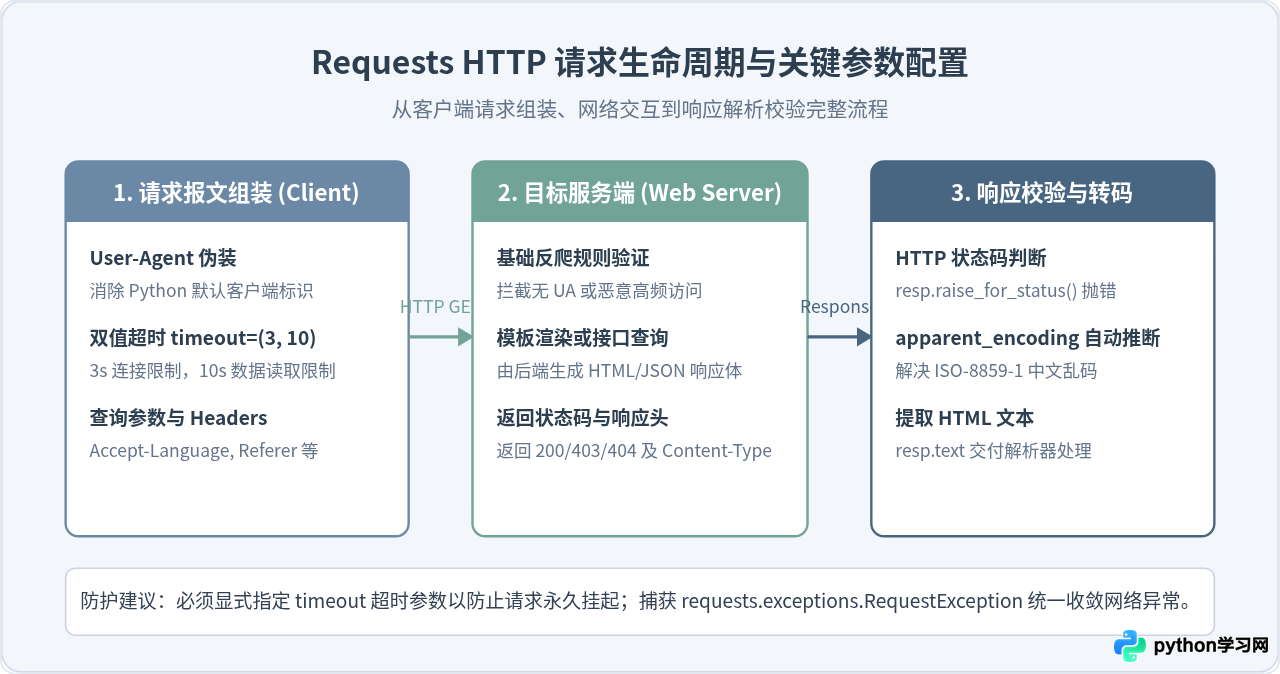
当通过代码直接调用 requests.get() 时,其默认在 HTTP 报文请求头中附带的 User-Agent 类似于 python-requests/2.31.0。大多数商业网站为了防止爬虫爬取,会对这种明显的爬虫特征直接返回 403 Forbidden 或重定向到验证码页面。因此,显式指定常见桌面浏览器的 User-Agent 是爬虫的第一道基本伪装。
2. 超时控制(Timeout)
默认情况下,requests 的网络请求是没有超时时间限制的。如果遇到目标服务器无响应、DNS 故障或中间路由丢包,程序会一直挂起等待,导致爬虫任务死锁。建议传入一个元组 timeout=(3, 10),分别表示建立连接的最大允许秒数和从连接建立后等待服务端吐出数据的最大允许秒数。
3. 中文网页乱码解决方案
很多国内旧系统或特定网页在 HTTP Header 中未明确指定编码格式,此时 requests 会默认退回到 ISO-8859-1 编码解析,导致取出的中文字符全部变成“\xe4\xbd\xa0\xe5\xa5\xbd”或问号乱码。正确的应对方式是在获取 response.text 前,调用 response.apparent_encoding,它基于 chardet 库智能推断网页真实字符集(如 UTF-8 或 GBK),再赋值给 response.encoding。
以下是封装好的网页获取函数:
import requests
from requests.exceptions import RequestException

def fetch_html(url: str) -> str:
    """
    发起 HTTP 请求获取网页源码
    :param url: 目标网页 URL
    :return: 网页的 HTML 字符串
    """
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/122.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        response = requests.get(url, headers=headers, timeout=(3, 10))
        # 显式校验状态码,若为 4xx 或 5xx 会抛出 HTTPError
        response.raise_for_status()

        # 修复字符编码乱码
        if response.encoding.lower() == "iso-8859-1":
            response.encoding = response.apparent_encoding

        return response.text
    except RequestException as err:
        print(f"[错误] 请求网页失败: {url},原因: {err}")
        return ""
三、第二阶段:解析 HTML 内容与精确定位目标数据
成功获取到 HTML 字符串后,下一步就是从中抽取我们关注的字段。在 Python 生态中,通常使用 BeautifulSoup4 配合内置的 html.parser 或性能更高的 lxml 解析器将字符串解析为内存中的 DOM 节点树。
1. 选择器策略:首推 CSS 选择器
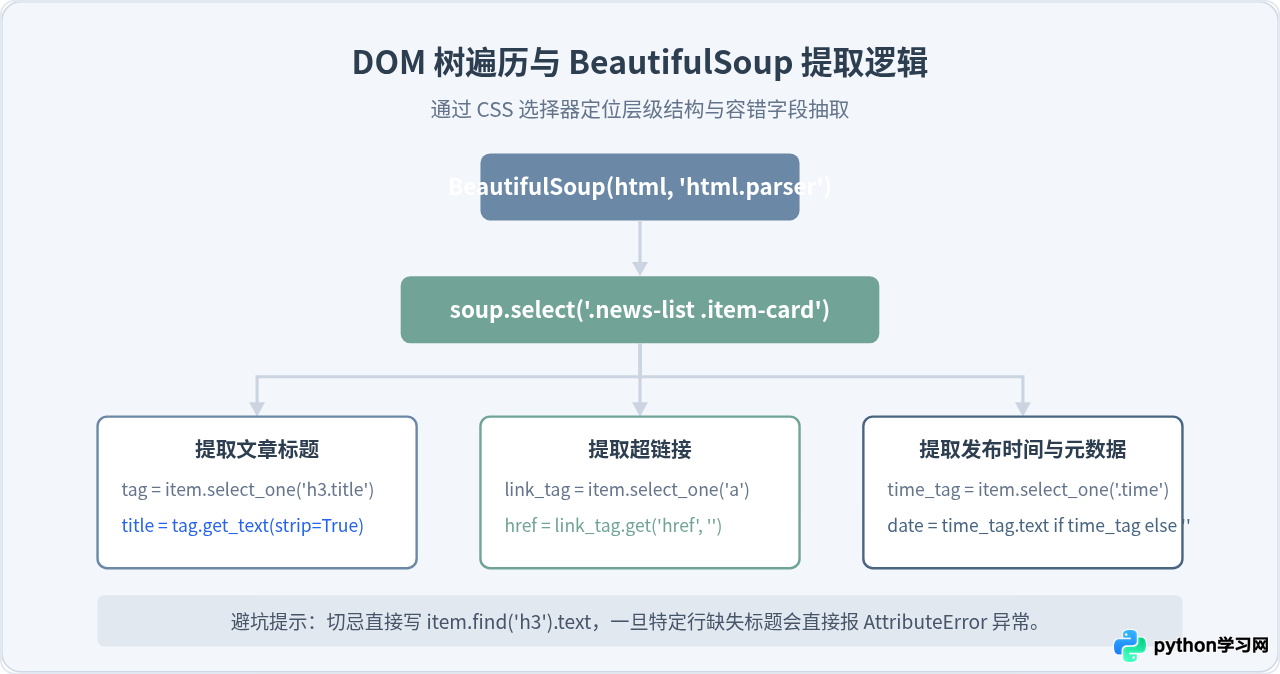
BeautifulSoup 支持两套查询方式:基于标签名的 find() / find_all() 和基于 CSS 语法的 select() / select_one()。在实际业务中,推荐优先使用 select(),因为现代前端框架生成的类名与嵌套层级非常复杂,CSS 选择器语法简洁且与浏览器开发者工具(F12 -> Copy selector)完全一致,可维护性更强。
2. 防御性字段抽取(规避 AttributeError)
网页结构经常会出现某一行没有发布日期、某一个列表项是广告卡片没有链接的情况。如果直接链式调用 item.select_one('.date').text,当节点不存在返回 None 时,就会触发 Python 最常见的 AttributeError: 'NoneType' object has no attribute 'text' 异常,直接终结程序运行。
因此,对于每一个待抽取的字段,必须先将查找到的元素赋值给临时变量,进行真值判断后再取值:
from bs4 import BeautifulSoup
from typing import List, Dict

def parse_page_data(html_content: str) -> List[Dict[str, str]]:
    """
    解析 HTML 并抽取目标数据
    :param html_content: 网页 HTML 源码
    :return: 包含多条结构化记录的字典列表
    """
    if not html_content:
        return []

    soup = BeautifulSoup(html_content, "html.parser")
    # 定位所有数据卡片外层容器
    items = soup.select(".article-item, .post-card, tr.data-row")

    extracted_data = []
    for item in items:
        # 防御性提取标题
        title_el = item.select_one("h2, .title, td.title-col")
        title = title_el.get_text(strip=True) if title_el else "无标题"

        # 防御性提取链接
        link_el = item.select_one("a")
        link = link_el.get("href", "").strip() if link_el else ""

        # 防御性提取日期或分类
        meta_el = item.select_one(".publish-time, .date, td.time-col")
        publish_time = meta_el.get_text(strip=True) if meta_el else "未知时间"

        # 组装为字典
        record = {
            "title": title,
            "url": link,
            "publish_time": publish_time
        }
        extracted_data.append(record)

    return extracted_data
四、第三阶段:结构化清洗与数据存储落地
提取出的内存数据若不及时落盘,遇到程序崩溃就会全部付诸东流。最常用、最通用的存储格式是 CSV 文件(方便用 Excel、Pandas 打开)和 JSON 文件(方便后端系统交互)。在 Python 中使用内置的 csv 和 json 模块即可轻松完成,但有几个关键细节极易踩坑。
1. CSV 写入的关键防坑项
- Windows 换行空行问题:使用
open(..., "w")打开 CSV 文件时,如果不加参数,在 Windows 系统下每次写入一行都会莫名其妙多出一个空白行。必须显式指定newline=""参数,将换行控制权交给 CSV 模块。 - Excel 中文乱码问题:Python 默认采用
utf-8写入,如果用户直接双击用微软 Excel 打开该 CSV 文件,里面的汉字很可能会变成乱码。解决方案是采用utf-8-sig编码,它会在文件最前列加入 BOM 标记,告知 Excel 使用 UTF-8 解码。 - 表头只写一次:在追加写入模式(
mode="a")下,必须先判断文件是否存在或文件大小是否为 0,仅在首次创建文件时写入表头,否则每次追加都会插入重复的列名。
实现安全存储的代码如下:
import csv
import json
import os
from typing import List, Dict

def save_to_csv(data: List[Dict[str, str]], file_path: str) -> None:
    """
    将数据追加保存至 CSV 文件
    :param data: 结构化数据列表
    :param file_path: 目标文件路径
    """
    if not data:
        print("[提示] 无数据需要写入 CSV")
        return

    file_exists = os.path.exists(file_path) and os.path.getsize(file_path) > 0
    fieldnames = list(data[0].keys())

    # 使用 utf-8-sig 编码防止 Excel 打开乱码,newline="" 消除额外空行
    with open(file_path, mode="a", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if not file_exists:
            writer.writeheader()  # 文件新建时写入表头
        writer.writerows(data)

    print(f"[成功] 已成功向 {file_path} 写入 {len(data)} 条数据")

def save_to_json(data: List[Dict[str, str]], file_path: str) -> None:
    """
    将数据写入 JSON 文件
    :param data: 结构化数据列表
    :param file_path: 目标文件路径
    """
    if not data:
        return

    # ensure_ascii=False 确保输出真实中文字符而不是 \uXXXX
    with open(file_path, mode="w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=2)

    print(f"[成功] 数据已保存为 JSON: {file_path}")
五、端到端完整代码实例:从抓取到存储
接下来,我们将以上三个阶段有机结合,给出一个结构完整、可直接运行的工程化示例。该脚本包含了模拟真实网页环境、完整抓取、解析并落盘的全套逻辑。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Python requests 爬虫完整实例:网页获取、解析与数据存储
适用环境: Python 3.8+
第三方依赖: pip install requests beautifulsoup4
"""

import os
import csv
import time
import requests
from bs4 import BeautifulSoup
from requests.exceptions import RequestException
from typing import List, Dict

# ================= 1. 网页请求模块 =================
def fetch_html(url: str) -> str:
    """发送 HTTP GET 请求获取网页内容"""
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/122.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        response = requests.get(url, headers=headers, timeout=(3, 10))
        response.raise_for_status()

        # 修正中文编码
        if response.encoding.lower() == "iso-8859-1":
            response.encoding = response.apparent_encoding

        return response.text
    except RequestException as err:
        print(f"[请求异常] URL: {url}, 错误: {err}")
        return ""

# ================= 2. 页面解析模块 =================
def parse_html(html_text: str) -> List[Dict[str, str]]:
    """解析 HTML 文档并提取结构化字段"""
    if not html_text:
        return []

    soup = BeautifulSoup(html_text, "html.parser")
    # 查找所有的目标卡片元素
    cards = soup.select(".quote, .article-item, .post-entry")

    results = []
    for card in cards:
        # 防御性抽取文本与作者
        text_el = card.select_one(".text, .title, h2")
        title = text_el.get_text(strip=True) if text_el else "未命名内容"

        author_el = card.select_one(".author, .meta-author, .byline")
        author = author_el.get_text(strip=True) if author_el else "未知作者"

        link_el = card.select_one("a")
        link = link_el.get("href", "").strip() if link_el else ""

        results.append({
            "title": title,
            "author": author,
            "url": link,
            "crawl_time": time.strftime("%Y-%m-%d %H:%M:%S")
        })

    return results

# ================= 3. 数据存储模块 =================
def save_data_to_csv(data_list: List[Dict[str, str]], file_path: str) -> None:
    """以 UTF-8-SIG 格式将数据写入 CSV 文件"""
    if not data_list:
        print("[存储] 无有效数据需要写入")
        return

    file_exists = os.path.exists(file_path) and os.path.getsize(file_path) > 0
    fields = list(data_list[0].keys())

    with open(file_path, mode="a", encoding="utf-8-sig", newline="") as csvfile:
        writer = csv.DictWriter(csvfile, fieldnames=fields)
        if not file_exists:
            writer.writeheader()
        writer.writerows(data_list)

    print(f"[存储成功] 已将 {len(data_list)} 条记录写入文件: {file_path}")

# ================= 4. 主控流程 =================
def run_spider():
    """爬虫主调度函数"""
    # 以常用公开测试抓取站点为例
    target_url = "http://quotes.toscrape.com/"
    output_csv = "scraped_data.csv"

    print(f"[*] 开始抓取页面: {target_url}")
    html = fetch_html(target_url)

    if not html:
        print("[!] 网页抓取失败,爬虫流程终止")
        return

    print(f"[*] 网页获取成功,长度: {len(html)} 字节,开始解析节点...")
    items = parse_html(html)
    print(f"[*] 成功解析出 {len(items)} 条结构化数据")

    print(f"[*] 正在持久化至本地磁盘: {output_csv}")
    save_data_to_csv(items, output_csv)
    print("[*] 爬虫全流程执行完毕!")

if __name__ == "__main__":
run_spider()[*] 开始抓取页面: http://quotes.toscrape.com/[*] 网页获取成功,长度: 11054 字节,开始解析节点...[*] 成功解析出 10 条结构化数据[*] 正在持久化至本地磁盘: scraped_data.csv[存储成功] 已将 10 条记录写入文件: scraped_data.csv[*] 爬虫全流程执行完毕!
六、爬虫工程化实践与健壮性保障
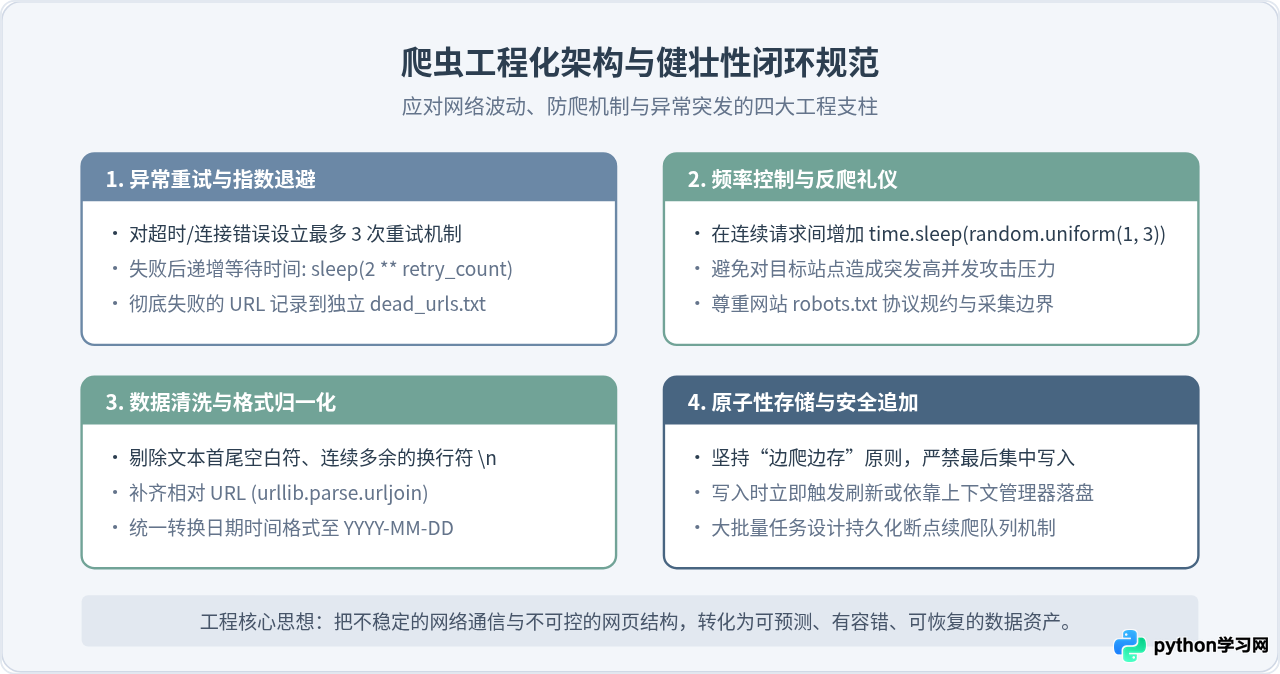
在实际业务中抓取数十万甚至数百万页面时,爬虫会遭遇断网、封禁、页面改版等各种复杂挑战。为了让爬虫具备在生产环境中稳定运行的能力,必须建立闭环的防护体系。
1. 为什么必须“边抓边存”?
很多新手喜欢在主循环里定义一个巨大的 all_results = [],将所有页面爬完后再统一写入文件。一旦在抓取第 999 页时由于网络断开或内存溢出抛错,程序意外退出,之前耗费数小时抓取的 998 页数据就会彻底消失。因此,必须将持久化函数放在每个循环或每完成一定批次后立即执行(追加模式),保障已产出数据的安全性。
2. 请求重试与指数退避机制
瞬时网络丢包在爬虫运行中非常普遍。对于单次请求失败,不应该立即放弃整个页面,也不应该无脑死循环重试。推荐使用指数退避(Exponential Backoff)策略:第一次失败等待 1 秒,第二次失败等待 2 秒,第三次等待 4 秒。如果重试 3 次仍然失败,再记录下对应的 URL 并在日志中输出警告,继续处理下一个页面。
3. 合规与采集礼仪
编写爬虫应当始终遵循网络文明与法律法规。严禁对无公开授权的系统发起暴力扫射,严禁抓取涉及个人隐私与商业机密的信息。在采集公开信息时,务必加上合理的随机延迟(如 time.sleep(1)),避免对目标站点服务器造成性能冲击或甚至引发拒绝服务,做到安全、合规与高效采集。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















