


Python3利用正则表达式抓取内涵段子实战

发布时间:2026-10-13 |
4人浏览过
本文介绍如何使用Python3结合正则表达式从内涵段子网站抓取内容。通过构造请求获取HTML源码,利用re模块匹配特定标签内的文本,清洗后保存至本地文件。代码包含分页处理、请求头设置及文件写入逻辑,适合初学者理解爬虫基础流程。
本文分享一个基于Python3的正则表达式爬虫实例,用于抓取内涵段子内容。该示例旨在为读者提供可参考的实现方案。
虽然正则表达式在复杂爬虫场景中并非总是首选,但它仍是开发者必须掌握的基础技能之一。
基本流程是:首先获取目标网页的HTML源码,接着使用正则表达式进行内容匹配,最后将匹配到的段子数据写入文本文件。具体实现代码如下:
# -*- coding:utf-8 -*-
from urllib import request as urllib2
import re
# 利用正则表达式爬取内涵段子
url = r'http://www.neihanpa.com/article/list_5_{}.html'
headers = {
'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:57.0) Gecko/20100101 Firefox/57.0',
}
file_name = '内涵段子.txt'
for page in range(2):
# 2表示页数,可以自行调整
fullurl = url.format(str(page+1))
request = urllib2.Request(url=fullurl, headers=headers)
response = urllib2.urlopen(request)
html = response.read().decode('gbk')
# re.S 如果没有re.S 则是只匹配一行有没有符合规则的字符串,如果没有则下一行重新匹配
# 如果加上re.S 则是将所有的字符串作为一个整体进行匹配
pattern = re.compile(r'<div\sclass="f18 mb20">(.*?)</div>',re.S)
duanzis = pattern.findall(html)
for duanzi in duanzis:
duanzi = duanzi.replace('<p>','').replace('</p>','').replace('<br />','\n').replace('“','').replace('&rdquo','').replace('…','')
try:
# 将爬取的段子写入文件
file = open(file_name,'a',encoding='utf-8')
file.write('\n'.join(duanzi.split()))
file.close()
except OSError as e:
print(e)
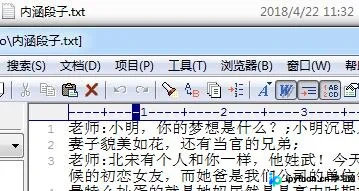
执行上述代码后,将生成如下所示的文件结果:
此外,推荐以下两款实用的正则表达式辅助工具供参考:
JavaScript正则表达式在线测试工具: http://tools.jb51.net/regex/javascript
正则表达式在线生成工具: http://tools.jb51.net/regex/create_reg
如需了解更多Python相关知识,可查阅本站系列文章,包括《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望本文的内容能对您的Python编程学习有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















