Python爬虫筛选指定内容的实现方案
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
10-15
7




本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
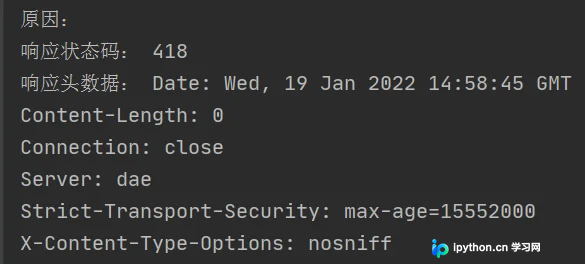
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
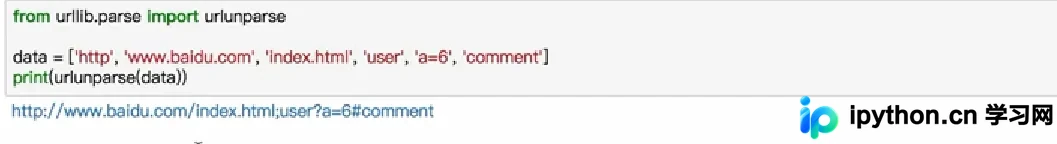
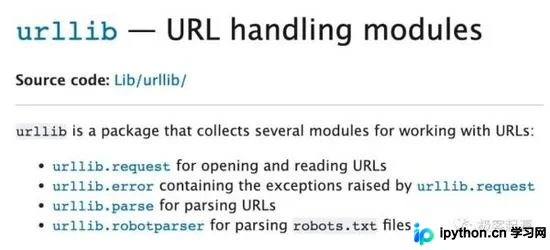
本文详细介绍Python内置urllib库的四大核心模块:urllib.request用于发起HTTP请求,urllib.error处理网络异常,urllib.parse解析与拼接URL,以及urllib.robotparser解析robots.txt。通过对比Python 2与3的差异,演示urlopen、Request对象、代理设置、Cookie处理及参数编码等关键用法,帮助开发者掌握底层网络请求原理。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
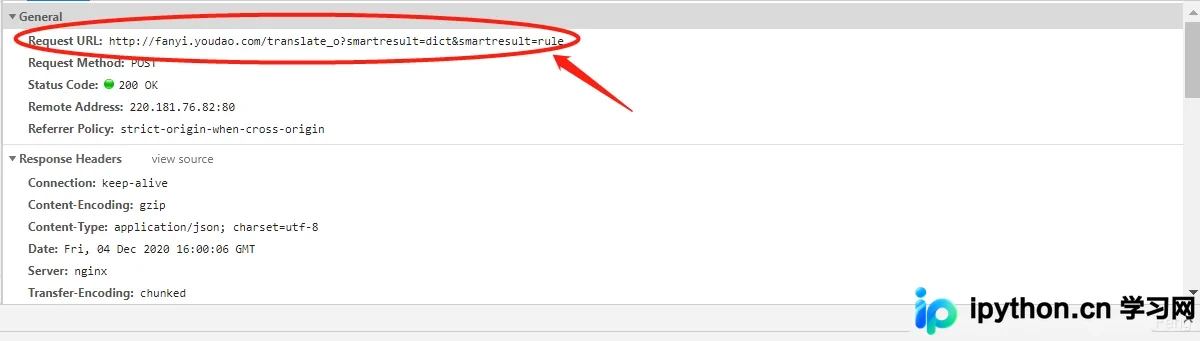
本文详细介绍如何使用Python爬取有道词典的翻译结果。通过Chrome开发者工具分析网络请求,获取翻译接口的URL、参数及Header信息,并利用urllib库构建POST请求。文中提供了完整的Python代码示例,演示如何伪装用户代理、提交翻译内容并解析返回的JSON数据,帮助开发者掌握基础爬虫技巧。
本文介绍使用Python编写脚本从指定网站批量爬取高清原图壁纸的方法。通过构建代理IP池以规避反爬机制,利用urllib库进行HTTP请求,并结合正则表达式解析页面结构,实现图片的自动识别与保存。代码包含完整的代理获取、验证及下载逻辑,适合Python初学者参考学习网络爬虫基础技术。
本文详解Python获取网络数据的多种方法。从底层Socket通信原理出发,介绍利用urllib库简化HTTP请求的操作,并深入讲解如何使用ElementTree解析XML数据,以及利用json库高效处理JSON格式数据,为网络爬虫和数据抓取提供实用指南。
本文详细介绍如何使用Python结合广度优先搜索(BFS)算法,编写代码以获取指定网站的所有内链与外链。文章涵盖队列类的定义、urllib库解析URL的方法、请求头设置以及完整的爬虫实现逻辑,并提供百度图片站点的爬取结果示例,适合Python初学者参考学习。
本文详细介绍Python内置库urllib的四个核心模块,重点演示如何使用urlopen函数发送HTTP GET和POST请求。通过具体代码示例,讲解如何构造请求数据、处理响应对象(HTTPResponse)及其属性方法,帮助开发者快速掌握服务端数据交互的基础技能。
本文深入解析Python标准库urllib与第三方库urllib3的核心用法与区别。详细阐述urllib.request、error、parse及robotparser模块功能,并通过urlopen实例演示远程文件读取。对比两者在身份验证、Cookie处理及协议扩展上的优劣,帮助开发者根据场景选择最佳网络请求方案。
本文介绍在Python爬虫开发中,如何获取HTTP重定向后的最终URL。通过urllib库的urlopen方法和requests库的get方法,分别展示了两种获取重定向地址的代码实现。重点解析了如何从响应对象中提取最终跳转后的网址,并提供了包含User-Agent请求头设置的示例,帮助开发者解决爬虫追踪真实链接的问题。



