


Python结合Beanstalkd实现异步任务处理的装饰器方案

本文介绍如何利用Python装饰器语法结合Beanstalkd消息队列服务,构建一套简单的异步任务处理工具。通过定义Subscriber、JobQueue和Worker三个核心组件,实现函数的注册、参数序列化推送及后台异步执行。重点解决了跨进程环境下函数注册信息的同步问题,利用装饰器机制确保Worker进程能动态加载并执行对应任务。
本文介绍如何使用Beanstalkd作为消息队列服务,并结合Python的装饰器语法,构建一个简易的异步任务处理工具。
最终效果
定义任务:
from xxxxx.job_queue import JobQueue

queue = JobQueue()

@queue.task('task_tube_one')
def task_one(arg1, arg2, arg3):
 # do task
提交任务:
task_one.put(arg1="a", arg2="b", arg3="c")
随后,后台的work线程即可负责执行这些已提交的任务。
实现过程
1、了解Beanstalk Server
Beanstalk是一个简单且高效的工作队列服务,项目地址为:https://github.com/kr/beanstalkd
Beanstalk是由C语言开发的消息队列服务,提供通用接口,最初旨在通过异步执行耗时任务来降低Web应用的页面延迟。针对不同编程语言,存在多种Beanstalkd客户端实现,例如Python中的beanstalkc库。本文正是利用beanstalkc作为与Beanstalkd服务器通信的工具。
2、任务异步执行实现原理
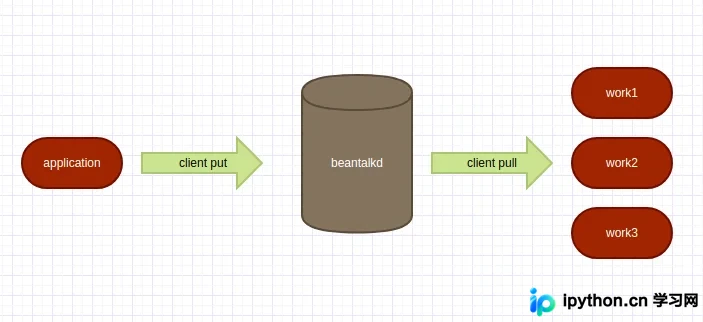
由于beanstalkd仅支持字符串形式的任务调度,若要支持提交函数及其参数并由worker执行,需要引入一个中间层来注册函数与传递参数的映射关系。
该实现主要包含以下三个部分:
Subscriber:负责将函数注册到Beanstalk的一个特定tube(管道)中。实现较为简单,主要维护函数名与函数对象的对应关系。需要注意的是,同一tube下不允许存在同名函数,相关数据存储在类变量中。
class Subscriber(object):
 FUN_MAP = defaultdict(dict)

 def __init__(self, func, tube):
  logger.info('register func:{} to tube:{}.'.format(func.__name__, tube))
  Subscriber.FUN_MAP[tube][func.__name__] = func
JobQueue:用于将普通函数转换为具备Putter能力的装饰器。
class JobQueue(object):
 @classmethod
 def task(cls, tube):
  def wrapper(func):
   Subscriber(func, tube)
   return Putter(func, tube)

  return wrapper
Putter:将函数名、函数参数以及指定的tube组合成一个对象,通过JSON序列化为字符串,最后利用beanstalkc推送到Beanstalkd队列中。
class Putter(object):
 def __init__(self, func, tube):
  self.func = func
  self.tube = tube

 # 直接调用返回
 def __call__(self, *args, **kwargs):
  return self.func(*args, **kwargs)

 # 推给离线队列
 def put(self, **kwargs):
  args = {
   'func_name': self.func.__name__,
   'tube': self.tube,
   'kwargs': kwargs
  }
  logger.info('put job:{} to queue'.format(args))
  beanstalk = beanstalkc.Connection(host=BEANSTALK_CONFIG['host'], port=BEANSTALK_CONFIG['port'])
  try:
   beanstalk.use(self.tube)
   job_id = beanstalk.put(json.dumps(args))
   return job_id
  finally:
   beanstalk.close()
Worker:从Beanstalkd队列中取出字符串,通过json.loads反序列化为对象,获取函数名、参数和tube信息。随后从Subscriber中查找函数名对应的函数代码,并传入参数执行该函数。
class Worker(object):
 worker_id = 0

 def __init__(self, tubes):
  self.beanstalk = beanstalkc.Connection(host=BEANSTALK_CONFIG['host'], port=BEANSTALK_CONFIG['port'])
  self.tubes = tubes
  self.reserve_timeout = 20
  self.timeout_limit = 1000
  self.kick_period = 600
  self.signal_shutdown = False
  self.release_delay = 0
  self.age = 0
  self.signal_shutdown = False
  signal.signal(signal.SIGTERM, lambda signum, frame: self.graceful_shutdown())
  Worker.worker_id += 1
  import_module_by_str('pear.web.controllers.controller_crawler')

 def subscribe(self):
  if isinstance(self.tubes, list):
   for tube in self.tubes:
    if tube not in Subscriber.FUN_MAP.keys():
     logger.error('tube:{} not register!'.format(tube))
     continue
    self.beanstalk.watch(tube)
  else:
   if self.tubes not in Subscriber.FUN_MAP.keys():
    logger.error('tube:{} not register!'.format(self.tubes))
    return
   self.beanstalk.watch(self.tubes)

 def run(self):
  self.subscribe()
  while True:
   if self.signal_shutdown:
    break
   if self.signal_shutdown:
    logger.info("graceful shutdown")
    break
   job = self.beanstalk.reserve(timeout=self.reserve_timeout) # 阻塞获取任务,最长等待 timeout
   if not job:
    continue
   try:
    self.on_job(job)
    self.delete_job(job)
   except beanstalkc.CommandFailed as e:
    logger.warning(e, exc_info=1)
   except Exception as e:
    logger.error(e)
    kicks = job.stats()['kicks']
    if kicks < 3:
     self.bury_job(job)
    else:
     message = json.loads(job.body)
     logger.error("Kicks reach max. Delete the job", extra={'body': message})
     self.delete_job(job)

 @classmethod
 def on_job(cls, job):
  start = time.time()
  msg = json.loads(job.body)
  logger.info(msg)
  tube = msg.get('tube')
  func_name = msg.get('func_name')
  try:
   func = Subscriber.FUN_MAP[tube][func_name]
   kwargs = msg.get('kwargs')
   func(**kwargs)
   logger.info(u'{}-{}'.format(func, kwargs))
  except Exception as e:
   logger.error(e.message, exc_info=True)
  cost = time.time() - start
  logger.info('{} cost {}s'.format(func_name, cost))

 @classmethod
 def delete_job(cls, job):
  try:
   job.delete()
  except beanstalkc.CommandFailed as e:
   logger.warning(e, exc_info=1)

 @classmethod
 def bury_job(cls, job):
  try:
   job.bury()
  except beanstalkc.CommandFailed as e:
   logger.warning(e, exc_info=1)

 def graceful_shutdown(self):
  self.signal_shutdown = True
在编写上述代码时,发现了一个问题:
通过Subscriber注册函数名与函数本身的对应关系,是在单个Python解释器(即单个进程)中运行的;而Worker则在另一个进程中异步运行。如何让Worker也能获取到与Putter相同的Subscriber信息?最终发现,利用Python的装饰器机制可以解决这一跨进程同步问题。
关键在于这一行代码解决了Subscriber的同步问题:
import_module_by_str('pear.web.controllers.controller_crawler')
# import_module_by_str 的实现
def import_module_by_str(module_name):
 if isinstance(module_name, unicode):
  module_name = str(module_name)
 __import__(module_name)
当执行import_module_by_str时,会调用__import__动态加载类和函数。在将使用JobQueue的函数所在模块加载到内存后,当Worker运行时,Python解释器会先执行被@修饰的装饰器代码,从而将Subscriber中的对应关系加载到内存中。
实际使用代码可参考:https://github.com/jiyangg/Pear/blob/master/pear/jobs/job_queue.py
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















