


Python多进程multiprocessing.Pool类详解

本文详解Python multiprocessing模块,重点解析Process类与Pool进程池。通过对比apply、map等方法,展示多进程在提升执行效率方面的优势,并附带文件统计等实战案例,帮助开发者掌握高效并发处理技巧。
multiprocessing模块
multiprocessing包是Python中用于管理多进程的核心库。其设计思路与threading.Thread类似,通过创建multiprocessing.Process对象来启动进程,并允许执行用户自定义的函数。Process对象提供了与Thread相似的方法,包括is_alive()、join([timeout])、run()、start()和terminate()。相关属性涵盖authkey、daemon(需通过start()设置)、exitcode(运行时为None,若为–N则表示被信号N终止)、name以及pid。此外,该模块还提供了Lock、Event、Semaphore和Condition等同步类,用法与threading中的同名类一致。总体而言,multiprocessing沿用了threading的大部分API,但将其应用场景切换至多进程环境。
该模块旨在实现类似线程管理的进程控制,这是multiprocessing的核心机制。它与threading高度相似,但在利用多核CPU资源方面,多进程的表现通常优于多线程。
查看Process类的构造方法:
__init__(self, group=None, target=None, name=None, args=(), kwargs={})
参数说明:
group:指定进程所属组,通常不使用。 target:指定调用的目标函数。 args:以元组形式传递调用函数的位置参数。 name:进程的别名。 kwargs:以字典形式传递调用函数的关键字参数。
创建进程的简单实例:
#coding=utf-8
import multiprocessing

def do(n) :
 #获取当前线程的名字
 name = multiprocessing.current_process().name
 print name,'starting'
 print "worker ", n
 return

if __name__ == '__main__' :
 numList = []
 for i in xrange(5) :
  p = multiprocessing.Process(target=do, args=(i,))
  numList.append(p)
  p.start()
  p.join()
  print "Process end."
执行结果:
Process-1 starting
worker 0
Process end.
Process-2 starting
worker 1
Process end.
Process-3 starting
worker 2
Process end.
Process-4 starting
worker 3
Process end.
Process-5 starting
worker 4
Process end.
在创建子进程时,只需传入执行函数及其参数,实例化Process对象后调用start()方法即可启动。这种方式比直接使用fork()更为简便。
join()方法用于阻塞主进程,直到子进程结束,通常用于实现进程间的同步。
注意:
在Windows系统下使用进程模块时,必须将相关进程代码置于if __name__ == '__main__':语句下方,否则模块无法正常运行;而在Unix/Linux环境下则无此限制。
Pool类
在进行Python系统管理时,尤其是涉及多个文件目录操作或远程控制多台主机,并行处理能显著节省时间。若操作对象数量较少,可直接使用Process类动态生成多个进程;但当涉及上百个甚至更多任务时,手动限制进程数量将变得繁琐,此时进程池(Pool)便发挥了重要作用。
Pool类允许用户指定进程数量。当有新请求提交至Pool时,若池未满,则创建新进程执行请求;若池已满,请求将被挂起,直到有进程结束并释放资源后,再创建新进程处理。以下介绍multiprocessing模块中Pool类的几个常用方法。
apply()
函数原型:
apply(func[, args=()[, kwds={}]])
该函数用于传递不定参数,但会导致主进程阻塞,直到函数执行完毕(不建议使用,且在Python 3.x版本后已不再推荐)。
apply_async()
函数原型:
apply_async(func[, args=()[, kwds={}[, callback=None]]])
用法与apply类似,但采用非阻塞模式,并支持通过回调函数返回结果。
map()
函数原型:
map(func, iterable[, chunksize=None])
Pool类中的map方法行为与内置map函数基本一致,会使进程阻塞直至返回结果。需注意,尽管第二个参数是迭代器,但实际使用时,必须等待整个队列就绪后,程序才会启动子进程。
close()
关闭进程池(pool),使其不再接受新的任务。
terminate()
立即结束工作进程,不再处理未完成的任务。
join()
主进程阻塞等待子进程退出,join方法必须在close或terminate之后调用。
multiprocessing.Pool类的实例:
import time
from multiprocessing import Pool
def run(fn):
 #fn: 函数参数是数据列表的一个元素
 time.sleep(1)
 return fn*fn

if __name__ == "__main__":
 testFL = [1,2,3,4,5,6]
 print 'shunxu:' #顺序执行(也就是串行执行,单进程)
 s = time.time()
 for fn in testFL:
  run(fn)

 e1 = time.time()
 print "顺序执行时间:", int(e1 - s)

 print 'concurrent:' #创建多个进程,并行执行
 pool = Pool(5) #创建拥有5个进程数量的进程池
 #testFL:要处理的数据列表,run:处理testFL列表中数据的函数
 rl =pool.map(run, testFL)
 pool.close()#关闭进程池,不再接受新的进程
 pool.join()#主进程阻塞等待子进程的退出
 e2 = time.time()
 print "并行执行时间:", int(e2-e1)
 print rl
执行结果:
shunxu: 顺序执行时间: 6 concurrent: 并行执行时间: 2 [1, 4, 9, 16, 25, 36]
上述示例展示了创建多个进程并发处理与顺序执行同一数据的时间差异。结果显示,并发执行时间明显短于顺序执行,但进程创建本身消耗资源,因此实际工作中进程数量不宜过大。
程序中的r1表示所有进程执行完毕后的全局返回结果集。由于run函数有返回值,每个进程对应一个结果,这些结果被存入列表(即结果堆),实际利用了队列原理,等待所有进程执行完毕后返回该列表(列表顺序不确定)。对Pool对象调用join()方法会等待所有子进程执行完毕,且在调用join()前必须先调用close()以停止接收新的Process。
再看一个实例:
import time
from multiprocessing import Pool
def run(fn) :
 time.sleep(2)
 print fn
if __name__ == "__main__" :
 startTime = time.time()
 testFL = [1,2,3,4,5]
 pool = Pool(10)#可以同时跑10个进程
 pool.map(run,testFL)
 pool.close()
 pool.join()
 endTime = time.time()
 print "time :", endTime - startTime
执行结果:
21

3
4
5
time : 2.51999998093
再次执行结果如下:
1
34

2
5
time : 2.48600006104
结果中出现空行和无折行数据的原因与进程调度有关。当多个进程并行执行时,每个进程获得的时间片不同,接收请求及完成时间均不确定,导致输出乱序。至于空行和无折行,是因为在执行第一个进程时,若刚打印换行符便切换至其他进程,可能导致两个数字打印在同一行;再次切换回第一个进程时打印换行符,从而产生空行。
进程实战实例
并行处理某个目录下文件中的字符个数和行数,存入res.txt文件中, 每个文件一行,格式为:filename:lineNumber,charNumber
import os
import time
from multiprocessing import Pool

def getFile(path) :
 #获取目录下的文件list
 fileList = []
 for root, dirs, files in list(os.walk(path)) :
  for i in files :
   if i.endswith('.txt') or i.endswith('.10w') :
    fileList.append(root + "\\" + i)
 return fileList

def operFile(filePath) :
 #统计每个文件中行数和字符数,并返回
 filePath = filePath
 fp = open(filePath)
 content = fp.readlines()
 fp.close()
 lines = len(content)
 alphaNum = 0
 for i in content :
  alphaNum += len(i.strip('\n'))
 return lines,alphaNum,filePath

def out(list1, writeFilePath) :
 #将统计结果写入结果文件中
 fileLines = 0
 charNum = 0
 fp = open(writeFilePath,'a')
 for i in list1 :
  fp.write(i[2] + " 行数:"+ str(i[0]) + " 字符数:"+str(i[1]) + "\n")
  fileLines += i[0]
  charNum += i[1]
 fp.close()
 print fileLines, charNum

if __name__ == "__main__":
 #创建多个进程去统计目录中所有文件的行数和字符数
 startTime = time.time()
 filePath = "C:\\wcx\\a"
 fileList = getFile(filePath)
 pool = Pool(5)
 resultList =pool.map(operFile, fileList)
 pool.close()
 pool.join()

 writeFilePath = "c:\\wcx\\res.txt"
 print resultList
 out(resultList, writeFilePath)
 endTime = time.time()
 print "used time is ", endTime - startTime
执行结果:
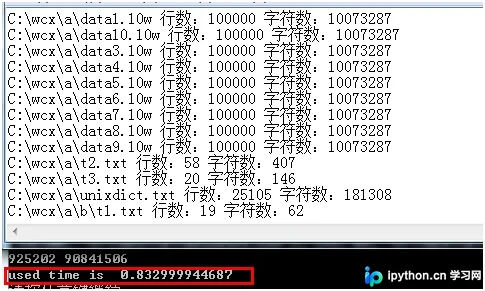
耗时不到1秒,可见多进程并发执行速度非常快。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















