


Python操作MS Word实战:python-docx读写示例与注意事项

发布时间:2026-10-13 |
6人浏览过
本文详解如何使用python-docx库读写MS Word文件。通过pip安装后,演示添加标题、文本样式及表格的完整代码,并展示读取docx内容的实现。特别指出读取doc文件时的编码问题,建议使用utf-8或批量转换为docx格式,助力开发者快速掌握Word自动化处理。
利用Python工具读写MS Word文件(包括docx与doc格式),核心依赖于python-docx库。本文整理了几项常用操作,并提供一个完整样例,旨在协助读者快速上手相关开发工作。
环境安装
Python处理docx文件需依赖python-docx包,可通过pip工具便捷安装。pip通常位于Python安装目录下的Scripts文件夹中。
pip install python-docx
此外,用户也可选择使用easy_install工具或采取手动方式进行安装配置。
写入文件内容
此处直接提供一个示例代码,读者可根据实际需求提取关键部分。
#coding=utf-8
from docx import Document
from docx.shared import Pt
from docx.shared import Inches
from docx.oxml.ns import qn
#打开文档
document = Document()
#加入不同等级的标题
document.add_heading(u'MS WORD写入测试',0)
document.add_heading(u'一级标题',1)
document.add_heading(u'二级标题',2)
#添加文本
paragraph = document.add_paragraph(u'我们在做文本测试!')
#设置字号
run = paragraph.add_run(u'设置字号、')
run.font.size = Pt(24)
#设置字体
run = paragraph.add_run('Set Font,')
run.font.name = 'Consolas'
#设置中文字体
run = paragraph.add_run(u'设置中文字体、')
run.font.name=u'宋体'
r = run._element
r.rPr.rFonts.set(qn('w:eastAsia'), u'宋体')
#设置斜体
run = paragraph.add_run(u'斜体、')
run.italic = True
#设置粗体
run = paragraph.add_run(u'粗体').bold = True
#增加引用
document.add_paragraph('Intense quote', style='Intense Quote')
#增加无序列表
document.add_paragraph(
 u'无序列表元素1', style='List Bullet'
)
document.add_paragraph(
 u'无序列表元素2', style='List Bullet'
)
#增加有序列表
document.add_paragraph(
 u'有序列表元素1', style='List Number'
)
document.add_paragraph(
 u'有序列表元素2', style='List Number'
)
#增加图像(此处用到图像image.bmp,请自行添加脚本所在目录中)
document.add_picture('image.bmp', width=Inches(1.25))
#增加表格
table = document.add_table(rows=1, cols=3)
hdr_cells = table.rows[0].cells
hdr_cells[0].text = 'Name'
hdr_cells[1].text = 'Id'
hdr_cells[2].text = 'Desc'
#再增加3行表格元素
for i in xrange(3):
 row_cells = table.add_row().cells
 row_cells[0].text = 'test'+str(i)
 row_cells[1].text = str(i)
 row_cells[2].text = 'desc'+str(i)
#增加分页
document.add_page_break()
#保存文件
document.save(u'测试.docx')
执行上述代码后生成的文档样式如下所示。
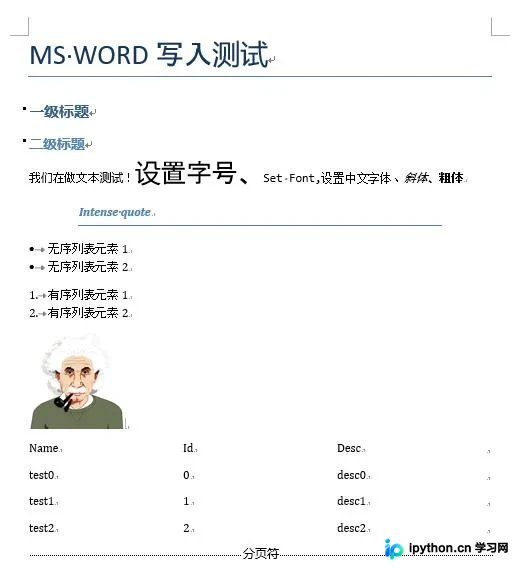
注:目前尚未找到解决表格边框线设置的方法,若各位读者知晓解决方案,欢迎指教。
读取文件内容
#coding=utf-8
from docx import Document
#打开文档
document = Document(u'测试.docx')
#读取每段资料
l = [ paragraph.text.encode('gb2312') for paragraph in document.paragraphs];
#输出并观察结果,也可以通过其他手段处理文本即可
for i in l:
 print i
#读取表格材料,并输出结果
tables = [table for table in document.tables];
for table in tables:
 for row in table.rows:
  for cell in row.cells:
   print cell.text.encode('gb2312'),'\t',
  print
 print '\n'
我们沿用刚才生成的文件进行读取测试,观察到的输出结果为。
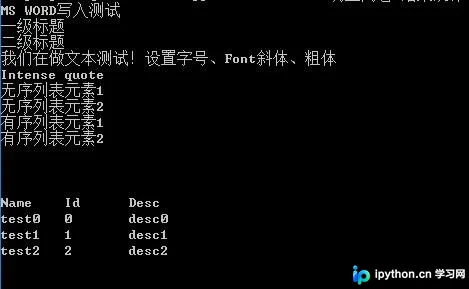
注意:此处采用gb2312编码方式读取,主要为了确保中文字符读写正确。通常情况下,推荐使用utf-8编码。另外,python-docx主要针对docx文件进行处理,加载doc文件时可能会遇到兼容性问题。若涉及大量doc文件,建议先利用doc2doc等工具将其批量转换为docx格式。
以上关于使用Python处理MS Word的实例讲解内容分享完毕,希望能为读者提供参考,同时也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















