


Python利用pytesseract识别图片文字教程

发布时间:2026-10-13 |
5人浏览过
本文介绍在Python环境中使用pytesseract库识别图片文字的方法。详细列出安装Python 2.7或3.4、Pillow、tesseract-ocr及pytesseract的步骤,涵盖Ubuntu环境下的具体命令。通过示例代码展示识别过程,并提示可能出现乱码的情况,供开发者参考。
近期有朋友寻求一种能够识别图片中文字内容的程序方案,此前曾接触过基于Java的验证码识别项目。
鉴于当前正在开展一项Python相关项目,借此机会使用Python进行实践练习。
1. 所需运行环境:
Python 2.7或3.4版本
2. 需安装pytesseract库
该库依赖于PIL(Pillow)和tesseract-ocr库。
本地测试环境为Ubuntu系统,以下介绍具体操作步骤:
2.7版本环境
1. 安装PIL库:
可直接使用pip命令进行安装:pip install Pillow
2. 安装tesseract-ocr:
执行命令:apt-get install tesseract-ocr
3. 安装pytesseract库
执行安装命令:pip install pytesseract
若使用Python 3.4版本进行安装,需将pip命令替换为pip3(此为通用操作)。
测试环节:
import pytesseract
from PIL import Image
img = Image.open('hb1.png')
data = pytesseract.image_to_string(img)
print (data)
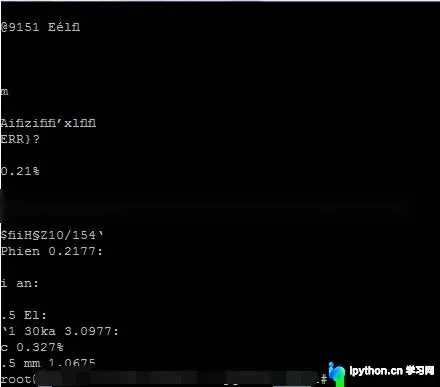
注意:识别结果中可能会出现乱码现象。
以上关于Python识别图片文字信息的方法即为本文分享的全部内容,旨在为读者提供参考,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















