


Python使用urllib下载网页并保存为本地HTML文件

发布时间:2026-10-13 |
5人浏览过
本文介绍如何使用Python的urllib库下载网页源码并保存为本地HTML文件。通过示例代码展示如何获取指定URL的网页内容,并将其以二进制模式写入本地文件。该方法适用于提取纯文本内容,但需注意本地保存的文件不包含外部引用的图片等资源。
利用Python将网页保存为本地HTML文件,核心依赖于urllib库。
以山东大学新闻网的一个具体页面为例,目标网页地址如下:
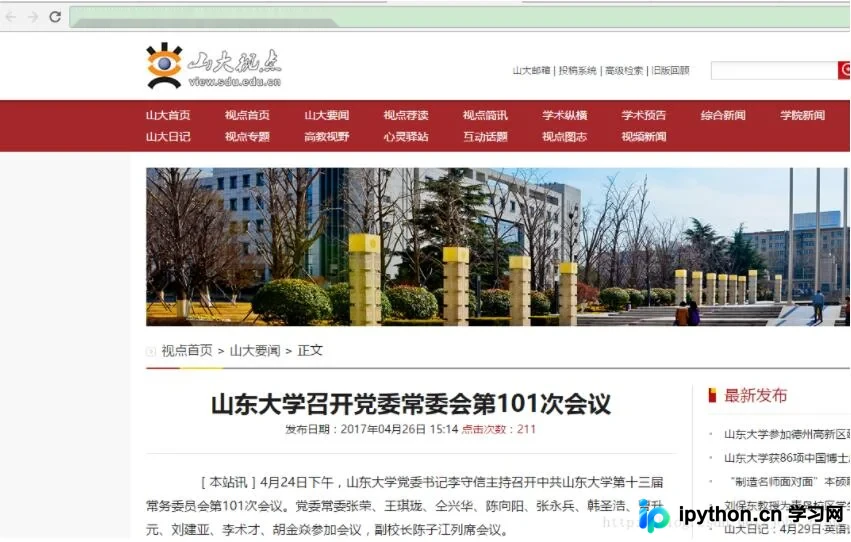
具体实现代码见下方:
import urllib.request

def getHtml(url):
 html = urllib.request.urlopen(url).read()
 return html

def saveHtml(file_name, file_content):
 # 注意windows文件命名的禁用符,比如 /
 with open(file_name.replace('/', '_') + ".html", "wb") as f:
  # 写文件用bytes而不是str,所以要转码
  f.write(file_content)

aurl = "http://www.view.sdu.edu.cn/info/1003/75240.htm"
html = getHtml(aurl)
saveHtml("sduview", html)

print("下载成功")
执行代码后,检查对应目录即可确认网页已成功下载并保存。
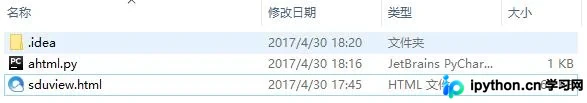
使用浏览器打开该本地HTML文件,显示效果如下:
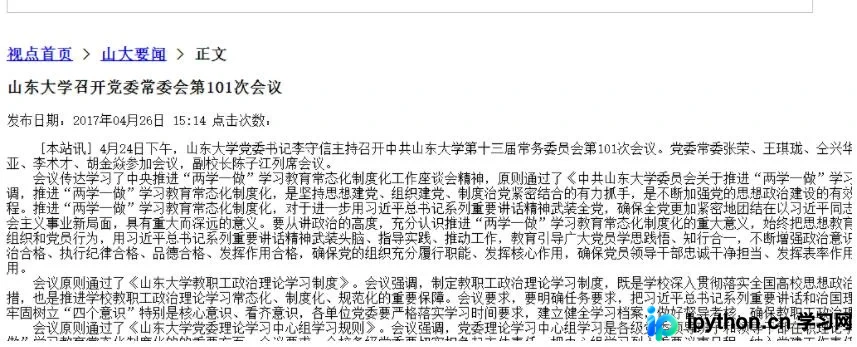
由于仅下载了网页的主干源码,其中引用的图片等资源并未包含在内。因此,此方法主要适用于提取文字内容,无法完整还原页面视觉效果。
以上即为Python下载网页并保存为本地HTML文件的完整示例,供读者参考。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















