


Python验证码识别实战:从灰度处理到TesserOCR识别全流程

本文详细讲解利用Python进行图像类验证码识别的完整流程。从生成测试验证码入手,依次演示灰度处理、二值化及基于邻域算法的降噪技术,并结合TesserOCR库实现自动识别。文章通过对比不同干扰程度下的识别效果,提供了处理简单至中等复杂度验证码的实用代码与策略。
前言
在开发爬虫程序时,验证码是一个无法回避的技术难点。目前的验证码主要可以分为四类:
- 图像类
- 滑动类
- 点击类
- 语音类
本文将重点探讨图像类验证码。这类验证码通常由数字、字母混合组成,部分国内网站甚至使用汉字。为了增加识别难度,生成时往往会加入噪点、干扰线、字符变形、重叠以及不同字体颜色等干扰因素。
针对此类验证码的识别,通常遵循以下处理步骤:
- 灰度处理
- 增加对比度(可选)
- 二值化
- 降噪处理
- 倾斜校正与字符分割
- 建立训练库
- 最终识别
出于实验目的,本文使用的验证码均由程序自动生成,而非从真实网站批量抓取。这样做的主要优势在于拥有大量已知准确结果的数据集,便于验证算法效果。
若需在真实环境中获取数据进行训练,可结合各大打码平台来构建数据集。
在生成验证码环节,本文使用Claptcha库(本地下载),Captcha库(本地下载)也是不错的替代选择。
为了生成最基础的纯数字且无干扰的验证码,需要对claptcha.py源码第285行的_drawLine函数进行修改,直接使其返回None,随后即可开始生成验证码:
from claptcha import Claptcha

c = Claptcha("8069","/usr/share/fonts/truetype/freefont/FreeMono.ttf")
t,_ = c.write('1.png')
请注意Ubuntu系统的字体路径配置,也可自行下载其他字体文件使用。生成的验证码效果如下:
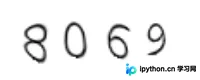
从图中可见,验证码存在形变。针对这类最简单的验证码,可以直接使用谷歌开源的tesserocr库进行识别。
首先执行安装命令:
apt-get install tesseract-ocr libtesseract-dev libleptonica-dev
pip install tesserocr
接着进行识别测试:
from PIL import Image
import tesserocr

p1 = Image.open('1.png')
tesserocr.image_to_text(p1)

'8069\n\n'
结果显示,对于此类简单验证码,即使不做任何预处理,识别率也已经相当高。有兴趣的读者可以使用更多数据进行测试,此处不再展开。
接下来,我们在验证码背景中添加噪点,观察效果:
c = Claptcha("8069","/usr/share/fonts/truetype/freefont/FreeMono.ttf",noise=0.4)
t,_ = c.write('2.png')
生成的验证码如下:
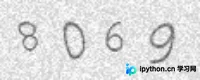
识别结果:
p2 = Image.open('2.png')
tesserocr.image_to_text(p2)
'8069\n\n'
效果尚可。随后生成一个包含字母和数字组合的验证码:
c2 = Claptcha("A4oO0zZ2","/usr/share/fonts/truetype/freefont/FreeMono.ttf")
t,_ = c2.write('3.png')
生成的验证码如下:
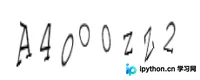
其中第3个字符是小写字母o,第4个是大写字母O,第5个是数字0,第6个是小写字母z,第7个是大写字母Z,最后一个字符是数字2。这种混淆对人眼极具挑战,但大多数现代验证码对大小写并不做严格区分,我们来看看自动识别的效果:
p3 = Image.open('3.png')
tesserocr.image_to_text(p3)
'AMOOZW\n\n'
既然人眼都难以分辨,计算机识别自然更加困难。然而,对于干扰较小、形变不严重的场景,使用tesserocr依然简单有效。接下来,我们将claptcha.py第285行的_drawLine函数还原,观察添加干扰线的情况。
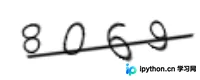
p4 = Image.open('4.png')
tesserocr.image_to_text(p4)
''
一旦加入干扰线,识别率便完全失效。那么,是否有办法去除这些干扰线呢?
尽管图片看起来是黑白的,但仍需进行灰度处理。否则,使用load()函数获取的是像素点的RGB元组而非单一灰度值。处理代码如下:
def binarizing(img,threshold):
 """传入image对象进行灰度、二值处理"""
 img = img.convert("L") # 转灰度
 pixdata = img.load()
 w, h = img.size
 # 遍历所有像素,大于阈值的为黑色
 for y in range(h):
  for x in range(w):
   if pixdata[x, y] < threshold:
    pixdata[x, y] = 0
   else:
    pixdata[x, y] = 255
 return img
处理后的图片效果如下:
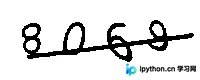
可以看出,处理后图像锐度显著提升。接下来尝试去除干扰线,常用方法包括4邻域和8邻域算法。所谓X邻域算法,可参考手机九宫格输入法:以按键5为待判断像素点,4邻域即判断其上下左右四个方向,8邻域则判断周围8个像素点。若这4或8个点中值为255(白色)的数量超过设定阈值,则判定该点为噪声,阈值可根据实际情况调整。
def depoint(img):
 """传入二值化后的图片进行降噪"""
 pixdata = img.load()
 w,h = img.size
 for y in range(1,h-1):
  for x in range(1,w-1):
   count = 0
   if pixdata[x,y-1] > 245:#上
    count = count + 1
   if pixdata[x,y+1] > 245:#下
    count = count + 1
   if pixdata[x-1,y] > 245:#左
    count = count + 1
   if pixdata[x+1,y] > 245:#右
    count = count + 1
   if pixdata[x-1,y-1] > 245:#左上
    count = count + 1
   if pixdata[x-1,y+1] > 245:#左下
    count = count + 1
   if pixdata[x+1,y-1] > 245:#右上
    count = count + 1
   if pixdata[x+1,y+1] > 245:#右下
    count = count + 1
   if count > 4:
    pixdata[x,y] = 255
 return img
处理后的图片如下:
结果似乎……毫无作用?确实如此,因为示例图片中干扰线的宽度与数字宽度一致。对于干扰线与数据像素宽度不同的情况,例如Captcha生成的验证码:
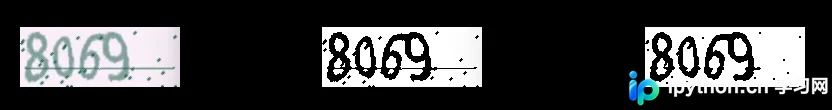
从左至右依次展示原图、二值化后图像及去除干扰线后的效果,总体降噪效果较为明显。此外,降噪操作可多次执行。例如,我对上述降噪后的结果再次执行一次降噪,可获得如下效果:
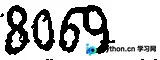
再次进行识别,得到结果:
p7 = Image.open('7.png')
tesserocr.image_to_text(p7)
'8069 ,,\n\n'
另外,从图片观察,实际数据颜色与噪点及干扰线颜色差异明显,据此可直接剔除噪点,此处不再展开。 作为系列文章的第一篇,本文主要记录如何将图片进行灰度处理、二值化及降噪,并结合tesserocr识别简单验证码。剩余内容将在下一篇文章中与大家分享。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















