


Python爬虫实战:抓取网页并转换为PDF电子书

本文介绍如何利用Python编写爬虫程序,从指定网页提取标题、正文及导航链接,并通过BeautifulSoup解析HTML。结合Requests库获取内容,使用wkhtmltopdf工具将生成的HTML文件转换为PDF格式,实现离线阅读与记忆。
爬虫开发的初衷
虽然官方文档和手册可以随时在线查阅,但如果能将其转化为纸质版或电子书,将极大地方便翻阅和记忆。单纯依靠手动复制粘贴效率极低,难以按时完成。因此,决定编写脚本将Android官方手册的内容抓取下来。
整体实现思路概述
- 第一步:分析网页结构
- 第二步:掌握BeautifulSoup库的使用
- 第三步:执行抓取并导出文件
参考资源列表:
* 将廖雪峰教程转换为PDF电子书的相关经验 * Requests库官方文档 * Beautiful Soup库官方文档
环境配置说明
在Ubuntu系统下使用PyCharm运行脚本已成功验证。若需将HTML转换为PDF,必须预先安装wkhtmltopdf工具。
详细操作流程
网页结构分析
以示例网页为例,主要任务是提取网页的正文内容、标题以及左侧导航栏中的所有链接地址。
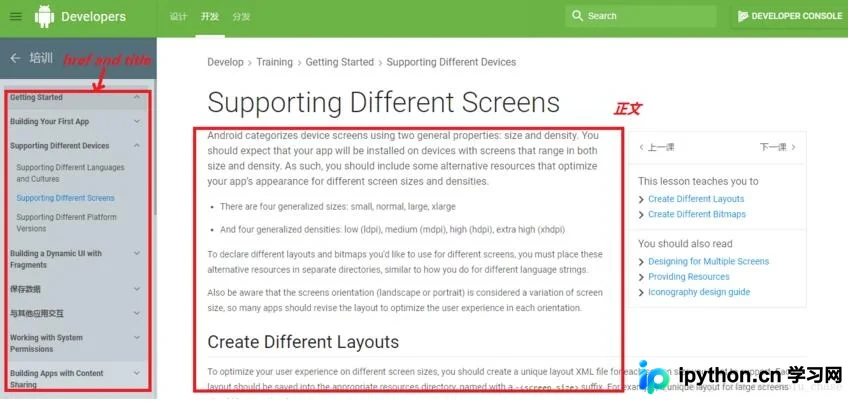
接下来的核心工作是定位并提取这些特定的HTML标签。
关于Requests库的应用
具体用法请参考官方文档。
proxies={
 "http":"http://vpn的IP:port",
 "https":"https://vpn的IP:port",
 }

response=requests.get(url,proxies=proxies)
Beautiful Soup库的应用指南
参考文档中主要介绍了两个核心功能:查找标签和修改标签。本文的具体需求如下:
1. 提取标题和所有链接地址,这主要涉及对标签的查找操作。
#对标签进行判断,一个标签含有href而不含有description,则返回true
#而我希望获取的是含有href属性而不含有description属性的<a>标签,(且只有a标签含有href)
def has_href_but_no_des(tag):
 return tag.has_attr('href') and not tag.has_attr('description')

#网页分析,获取网址和标题
def parse_url_to_html(url):

 response=requests.get(url,proxies=proxies)
 soup=BeautifulSoup(response.content,"html.parser")
 s=[]#获取所有的网址
 title=[]#获取对应的标题
 tag=soup.find(id="nav")#获取第一个id为"nav"的标签,这个里面包含了网址和标题
 for i in tag.find_all(has_href_but_no_des):
 s.append(i['href'])
 title.append(i.text)

 #获取的只是标签集,需要加html前缀
 htmls = "<html><head><meta charset='UTF-8'></head><body>"
 with open("android_training_3.html",'a') as f:
 f.write(htmls)
2. 对已获取的链接进行遍历,提取正文内容并将图片下载到本地存储;这涉及查找标签以及修改图片属性。
#网页操作,获取正文及图片
def get_htmls(urls,title):

 for i in range(len(urls)):
 response=requests.get(urls[i],proxies=proxies)
 soup=BeautifulSoup(response.content,"html.parser")
 htmls="<div><h1>"+str(i)+"."+title[i]+"</h1></div>"
 tag=soup.find(class_='jd-descr')
 #为image添加相对路径,并下载图片
 for img in tag.find_all('img'):
  im = requests.get(img['src'], proxies=proxies)
  filename = os.path.split(img['src'])[1]
  with open('image/' + filename, 'wb') as f:
  f.write(im.content)
  img['src']='image/'+filename
 htmls=htmls+str(tag)
 with open("android_training_3.html",'a') as f:
  f.write(htmls)
 print(" (%s) [%s] download end"%(i,title[i]))
 htmls="</body></html>"
 with open("android_training_3.html",'a') as f:
 f.write(htmls)
3. 将处理后的HTML转换为PDF文件。
此步骤需要下载并配置wkhtmltopdf工具。在Windows环境下执行时曾遇到错误,但在Ubuntu环境下运行正常。
def save_pdf(html):
 """
 把所有html文件转换成pdf文件
 """
 options = {
 'page-size': 'Letter',
 'encoding': "UTF-8",
 'custom-header': [
  ('Accept-Encoding', 'gzip')
 ]
 }
 pdfkit.from_file(html, "android_training_3.pdf", options=options)
最终效果展示
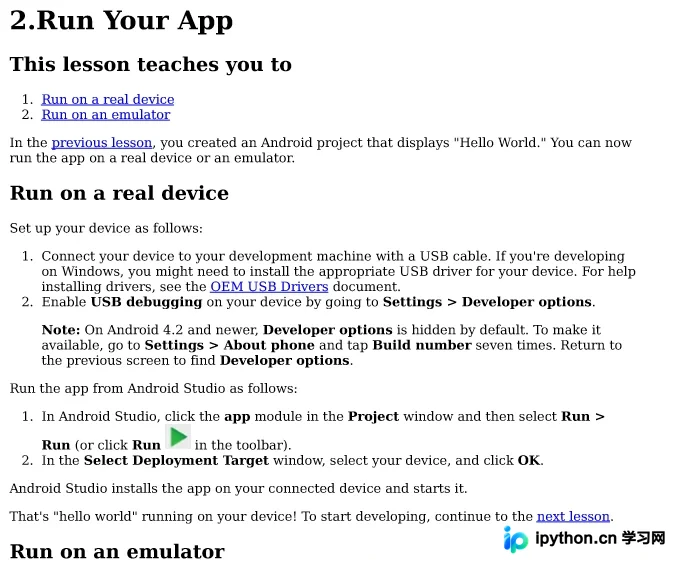
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















