


Python爬虫实战:从数据下载到解析保存的完整流程

本文详细讲解Python爬虫的核心流程,涵盖数据下载、解析与保存三大环节。通过对比urllib、Requests及Selenium等工具,结合淘宝图片抓取实例,演示如何利用正则表达式提取数据,并处理反爬策略与动态网页加载问题,为初学者提供实用的技术参考。
前言
近期完成Python基础学习后,我编写了几个爬虫程序进行实践。尽管网络上的教程众多,但部分因网站结构变更已失效。然而,爬虫开发仍遵循通用逻辑:获取数据、解析数据以及保存数据。下文将逐一展开说明。
1. 下载数据
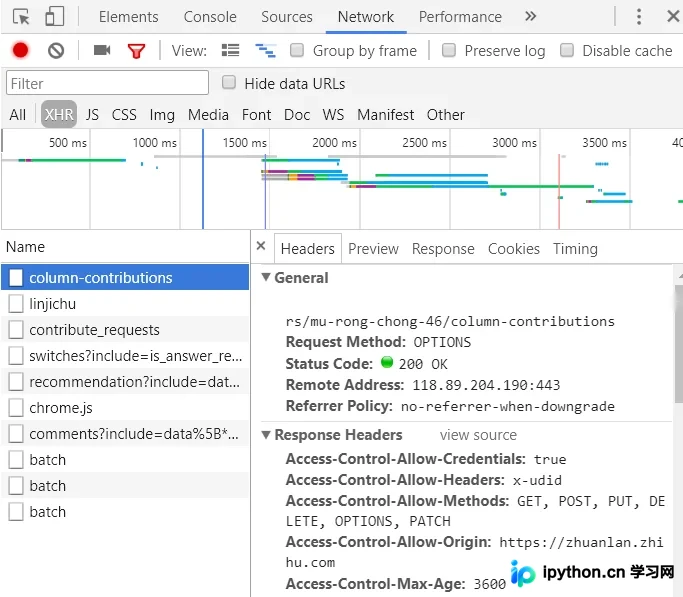
首先访问目标网站并分析URL结构。观察每次打开新页面时URL的变化规律,有时URL会携带上一页的特定数据(如xxID)。此时需在前一页面解析HTML以提取对应数据。若源码中未找到目标,可能是Ajax异步加载所致,此时应检查XHR请求。
部分网站设有反爬机制,可通过添加User-Agent字段来模拟浏览器行为。
self.user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)'
# 初始化 headers
self.headers = {'User-Agent': self.user_agent}
若上述方法无效,可在Chrome浏览器中按F12查看请求头与请求体,确认是否需要额外信息。例如,某些网站要求携带Referer字段以标识来源,请求时需一并带上。此外,使用Ctrl + Shift + C可定位HTML元素位置。
动态网页处理
部分网页属于动态加载,直接获取源码时数据尚未请求完成,导致无法提取。在Python中解决此类问题主要有两种途径:直接从JavaScript代码中提取内容,或使用Python第三方库执行JavaScript,直接获取浏览器渲染后的页面。
1. 查找请求接口:网页内容可能包含在API返回的数据中。复制该请求,去除复杂URL中无意义的参数,保留关键部分。注意:每删除一部分后需先测试网页是否可正常访问,确认无误后再继续精简,直至无法再删减。
2. Selenium:这是一个强大的网络数据采集工具(但速度较慢),最初用于网站自动化测试。近年来,它因能直接在浏览器中运行以获取精确快照而被广泛用于数据采集。Selenium库本质上是调用WebDriver的API。
WebDriver类似于可加载网站的浏览器,同时也能像BeautifulSoup对象一样查找页面元素,与页面元素交互(发送文本、点击等),并执行其他动作以运行网络爬虫。
PhantomJS:这是一款“无头”(headless)浏览器。它将网站加载至内存并执行页面JavaScript,但不向用户展示图形界面。将Selenium与PhantomJS结合使用,可构建功能强大的网络爬虫,处理Cookie、JavaScript、Header等任何所需操作。
用于下载数据的模块包括urllib、urllib2及Requests。
相较于前两者,Requests支持HTTP连接保持和连接池,支持使用Cookie维持会话,支持文件上传,支持自动确定响应内容编码,支持国际化URL及POST数据自动编码,且API更为简洁。但Requests直接使用时不支持异步调用,速度相对较慢。
html = requests.get(url, headers=headers) #没错,就是这么简单
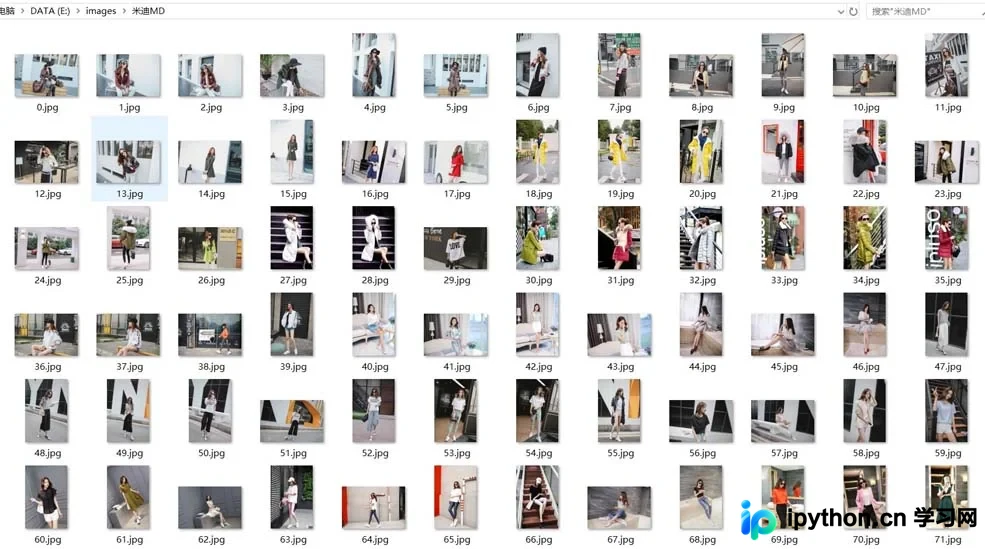
以下通过爬取淘宝模特图片的例子说明urllib2的使用:
user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)'
headers = {'User-Agent': user_agent}
# 注意:form data请求参数
params = 'q&viewFlag=A&sortType=default&searchStyle=&searchRegion=city%3A&searchFansNum=¤tPage=1&pageSize=100'
def getHome():
url = 'https://mm.taobao.com/tstar/search/tstar_model.do?_input_charset=utf-8'
req = urllib2.Request(url, headers=headers)
# decode('utf - 8')解码 把其他编码转换成unicode编码
# encode('gbk') 编码 把unicode编码转换成其他编码
# ”gbk”.decode('gbk').encode('utf - 8')
# unicode = 中文
# gbk = 英文
# utf - 8 = 日文
# 英文一 > 中文一 > 日文,unicode相当于转化器
html = urllib2.urlopen(req, data=params).read().decode('gbk').encode('utf-8')
# json转对象
peoples = json.loads(html)
for i in peoples['data']['searchDOList']:
#去下一个页面获取数据
getUseInfo(i['userId'], i['realName'])
2. 解析数据
数据解析有多种方式,本文仅涉及BeautifulSoup和正则表达式,本例采用正则表达式进行解析。
def getUseInfo(userId, realName):
 url = 'https://mm.taobao.com/self/aiShow.htm?userId=' + str(userId)
 req = urllib2.Request(url)
 html = urllib2.urlopen(req).read().decode('gbk').encode('utf-8')

 pattern = re.compile('<img.*?src=(.*?)/>', re.S)
 items = re.findall(pattern, html)
 x = 0
 for item in items:
 if re.match(r'.*(.jpg")$', item.strip()):
 tt = 'http:' + re.split('"', item.strip())[1]
 down_image(tt, x, realName)
 x = x + 1
 print('下载完毕')
正则表达式说明
match:匹配字符串开头,成功返回Match object,失败返回None,仅匹配一次。
search:在字符串中进行搜索,成功返回Match object,失败返回None,仅匹配一次。
findall:在字符串中查找所有匹配成功的组(即用括号括起来的部分)。返回list对象,每个list item是由每个匹配的所有组组成的list。
1).*? 是一个固定搭配,.和*代表可以匹配任意无限多个字符,加上?表示使用非贪婪模式进行匹配,即尽可能短地做匹配。
2)(.*?)代表一个分组,如果有5个(.*?)说明匹配了五个分组。
3)正则表达式中,“.”的作用是匹配除“\n”以外的任何字符,即在一行内进行匹配。这里的“行”是以“\n”进行区分的。HTML标签每行末尾有一个“\n”,但不可见。如果不使用re.S参数,则只在每一行内进行匹配,若一行没有则换下一行重新开始,不会跨行。而使用re.S参数后,正则表达式会将整个字符串作为一个整体,将“\n”视为普通字符加入其中,在整体中进行匹配。
3. 保存数据
数据解析后可保存至文件或数据库。本例演示保存至文件,过程较为简单,暂不赘述。后续文章将讲解如何将数据保存至数据库。
https://www.jb51.net/article/141674.htm
def down_image(url, filename, realName):
 req = urllib2.Request(url=url)
 folder = 'e:\\images\\%s' % realName
 if os.path.isdir(folder):
 pass
 else:
 os.makedirs(folder)

 f = folder + '\\%s.jpg' % filename
 if not os.path.isfile(f):
 print f
 binary_data = urllib2.urlopen(req).read()
 with open(f, 'wb') as temp_file:
 temp_file.write(binary_data)
GitHub地址,包含其他网站爬虫代码,欢迎Star:https://github.com/peiniwan/CreeperTest (本地下载)
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或工作具有一定的参考借鉴价值。如有疑问欢迎留言交流,感谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















