


Python爬虫实战:使用正则表达式与BeautifulSoup爬取豆瓣Top250

本文详细演示了如何使用Python编写爬虫程序,通过正则表达式和BeautifulSoup解析豆瓣电影Top250网页。文章涵盖了从构建请求头、提取电影链接与名称,到将数据保存为Excel文件和SQLite数据库的完整流程。代码包含完整的函数封装,适合初学者学习网络数据采集与本地存储技术。
免责声明与版权声明
本文分享的所有代码及示例仅供技术经验交流,严禁将相关技术用于非法用途。因滥用技术而产生的任何风险与法律责任由使用者自行承担,与作者无关。
本文档为个人学习过程中的实践记录,欢迎技术专家与同行提出批评与建议。
首先
这是作者首次撰写技术博客,深刻体会到博客在记录每日代码学习进度及作为复习笔记方面的价值。本文展示了首次尝试使用爬虫抓取网页数据的完整过程,具体目标为抓取豆瓣电影Top250榜单,欢迎读者指正。
当前示例仅抓取了电影链接和电影名称,如需获取更完整的数据抓取代码,请联系作者交流,QQ号码为1540741344。
开发环境配置
开发环境配置:PyCharm集成开发环境、Chrome浏览器。
网页结构分析与模块导入
网页结构分析
在编写代码前,需先访问目标网页,提取需要抓取的URL链接,并通过浏览器开发者工具分析网页源码,确定目标数据在HTML结构中的位置。
开发前需导入必要的Python模块,各模块功能描述如下。若不清楚如何导入包,可参考作者后续发布的教程。
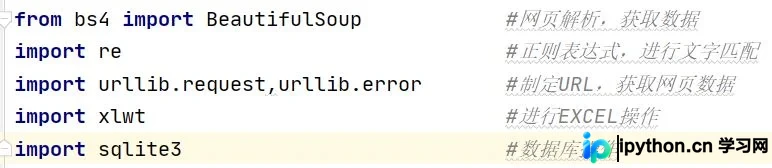
函数功能架构设计
为提高代码的可读性与可维护性,将功能拆分为多个函数。本项目共定义了7个函数,具体分工如下:
@主函数入口
主函数入口实现
if __name__=="__main__":    #程序执行入口
  main()
@获取网页HTML内容函数 askURL(url)
此处使用的请求头(User-Agent)是在Chrome浏览器中分析网页源码获得的。具体获取方法建议自行搜索,此处不再赘述。
获取网页HTML内容
def askURL(url): #得到指定网页信息的内容 #爬取一个网页的数据
  # 用户代理,本质上是告诉服务器,我们是以什么样的机器来访问网站,以便接受什么样的水平数据
  head={"User-Agent":"Mozilla / 5.0(Windows NT 10.0;Win64;x64) AppleWebKit / 537.36(KHTML, likeGecko) Chrome / 84.0.4147.89 Safari / 537.36"}
  request=urllib.request.Request(url,headers=head)     #request对象接受封装的信息,通过urllib携带headers访问信息访问url
  response=urllib.request.urlopen(request)         #用于接收返回的网页信息
  html=response.read().decode("utf-8")           #通过read方法读取response对象里的网页信息,使用“utf-8”
  return html
@解析基础URL数据函数 getData(baseURL) 其中findlink和findname为正则表达式规则,建议预先定义为全局变量。
定义正则表达式规则
findlink=r'<a class="" href="(.*?)"'
findname=r'<span class="title">(.*?)</span>'
解析并提取电影数据
def getData(baseURL):
  dataList=[]                   #初始化datalist用于存储获取到的数据
  for i in range(0,10):
    url=baseURL+str(i*25)
    html=askURL(url)                  #保存获取到的源码
    soup=BeautifulSoup(html,"html.parser")       #对html进行逐一解析,使用html.parser解析器进行解析
    for item in soup.find_all("div",class_="item"):   #查找符合要求的字符串 ,形成列表,find_all是查找所有的class是item的div
      data=[]                     #初始化data,用于捕获一次爬取一个div里面的内容
      item=str(item)                 #将item数据类型转化为字符串类型
      # print(item)
      link=re.findall(findlink,item)[0]        #使用re里的findall方法根据正则提取item里面的电影链接
      data.append(link)                #将网页链接追加到data里
      name=re.findall(findname,item)[0]        #使用re里的findall方法根据正则提取item里面的电影名字
      data.append(name)                #将电影名字链接追加到data里
      # print(link)
      # print(name)
      dataList.append(data)              #将捕获的电影链接和电影名存到datalist里面
  return dataList                     #返回一个列表,里面存放的是每个电影的信息
  print(dataList)
@将捕获的数据保存至Excel文件函数 saveData(dataList,savepath)
数据保存至Excel文件
def saveData(dataList,savepath):              #保存捕获的内容到excel里,datalist是捕获的数据列表,savepath是保存路径
  book=xlwt.Workbook(encoding="utf-8",style_compression=0)#初始化book对象,这里首先要导入xlwt的包
  sheet=book.add_sheet("test",cell_overwrite_ok=True)   #创建工作表
  col=["电影详情链接","电影名称"]              #列名
  for i in range(0,2):
    sheet.write(0,i,col[i])               #将列名逐一写入到excel
  for i in range(0,250):
    data=dataList[i]                  #依次将datalist里的数据获取
    for j in range(0,2):
      sheet.write(i+1,j,data[j])           #将data里面的数据逐一写入
  book.save(savepath)
@将捕获的数据保存至数据库函数
数据保存至SQLite数据库
def saveDataDb(dataList,dbpath):
  initDb(dbpath)                     #用一个函数初始化数据库
  conn=sqlite3.connect(dbpath)              #初始化数据库
  cur=conn.cursor()                    #获取游标
  for data in dataList:
    for index in range(len(data)):
      data[index]='"'+data[index]+'" '        #将每条数据都加上""
    #每条数据之间用,隔开,定义sql语句的格式
    sql='''
      insert into test(link,name) values (%s)
    '''%','.join (data)
    cur.execute(sql)                  #执行sql语句
    conn.commit()                    #提交数据库操作
  conn.close()
  print("爬取存入数据库成功!")
@初始化数据库函数 initDb(dbpath)
数据库初始化操作
def initDb(dbpath):
  conn=sqlite3.connect(dbpath)
  cur=conn.cursor()
  sql='''
    create table test(
      id integer primary key autoincrement,
      link text,
      name varchar

    )
  '''
  cur.execute(sql)
  conn.commit()
  cur.close()
  conn.close()
@主执行函数 main(),用于调用上述其他函数完成整体流程
主流程控制函数
def main():
  dbpath="testSpider.db"               #用于指定数据库存储路径
  savepath="testSpider.xls"             #用于指定excel存储路径
  baseURL="https://movie.douban.com/top250?start="  #爬取的网页初始链接
  dataList=getData(baseURL)
  saveData(dataList,savepath)
  saveDataDb(dataList,dbpath)
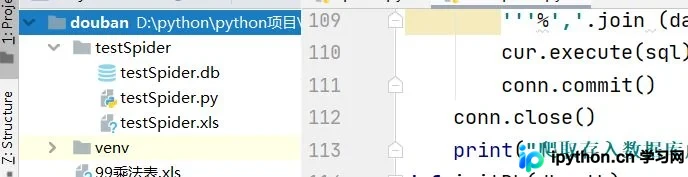
运行程序后,可在左侧目录中看到生成的Excel文件和数据库文件。
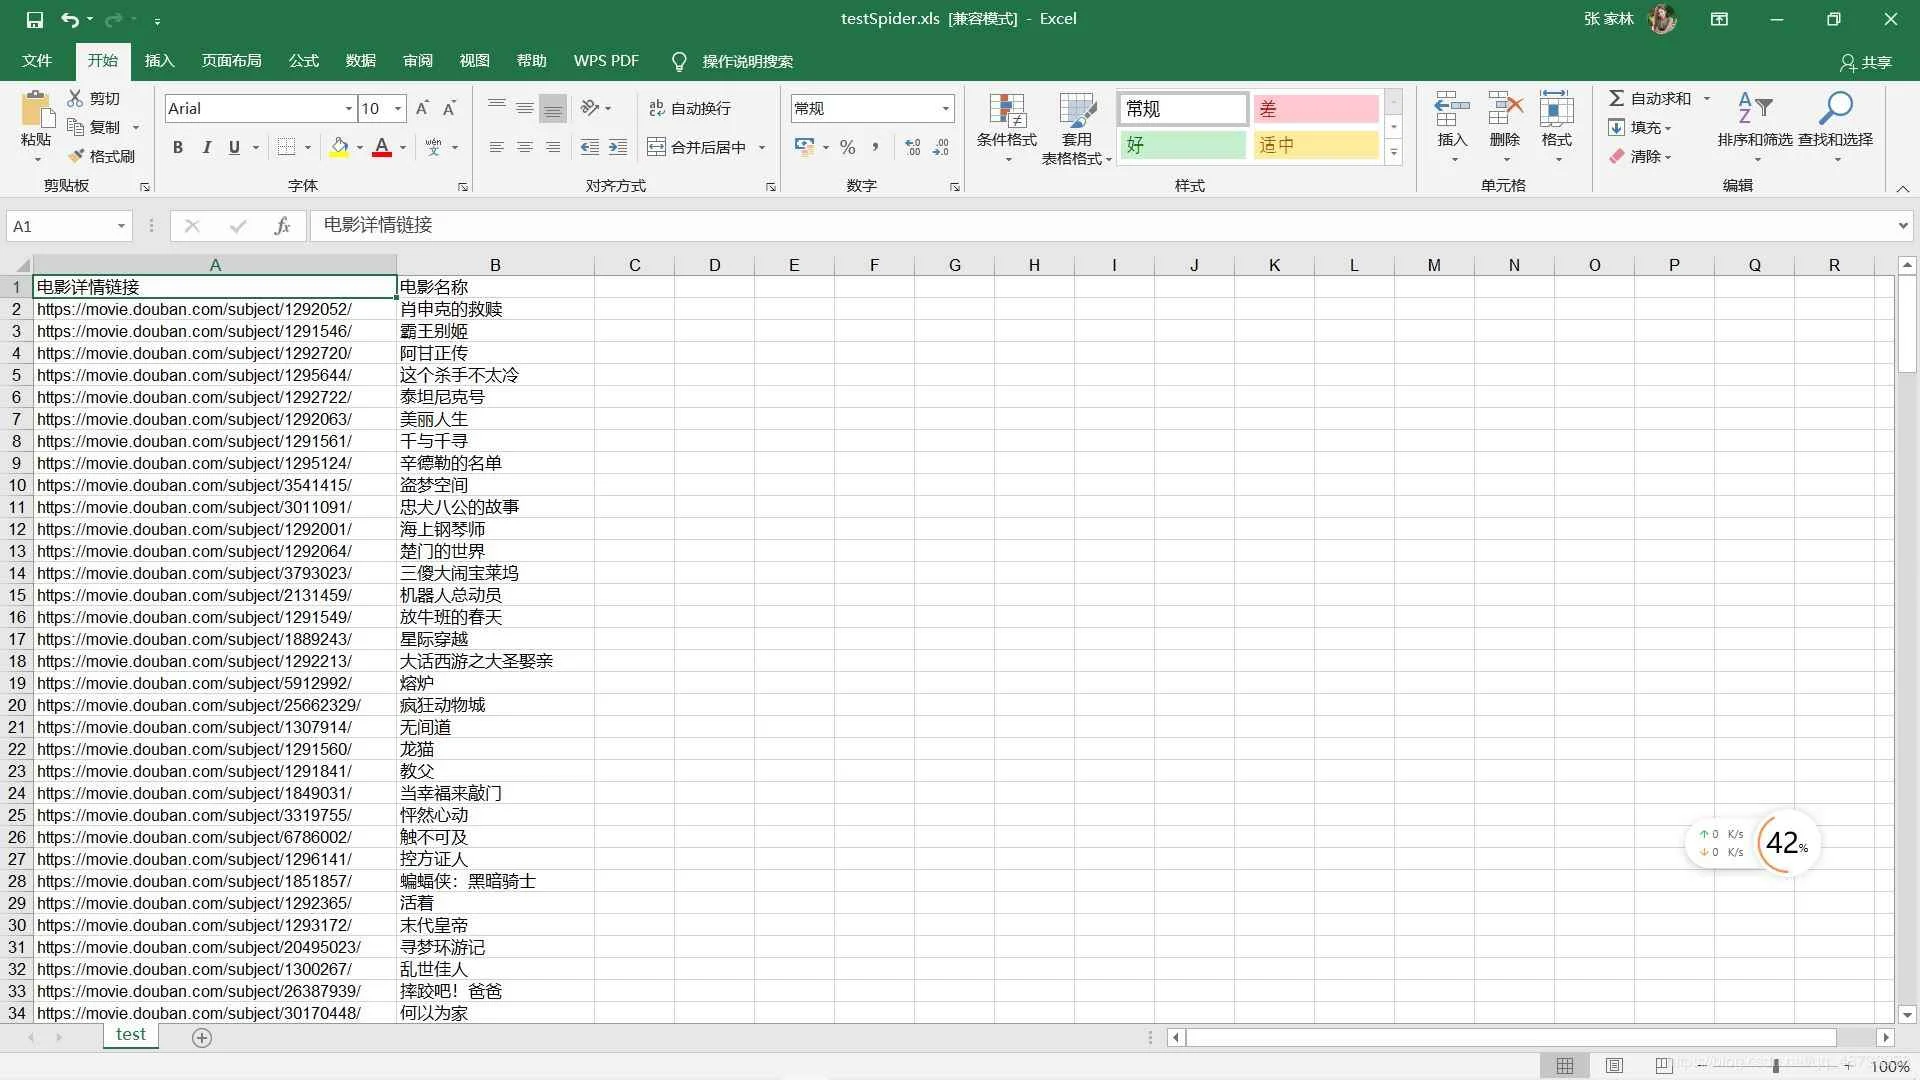
Excel文件可直接使用办公软件打开查看。
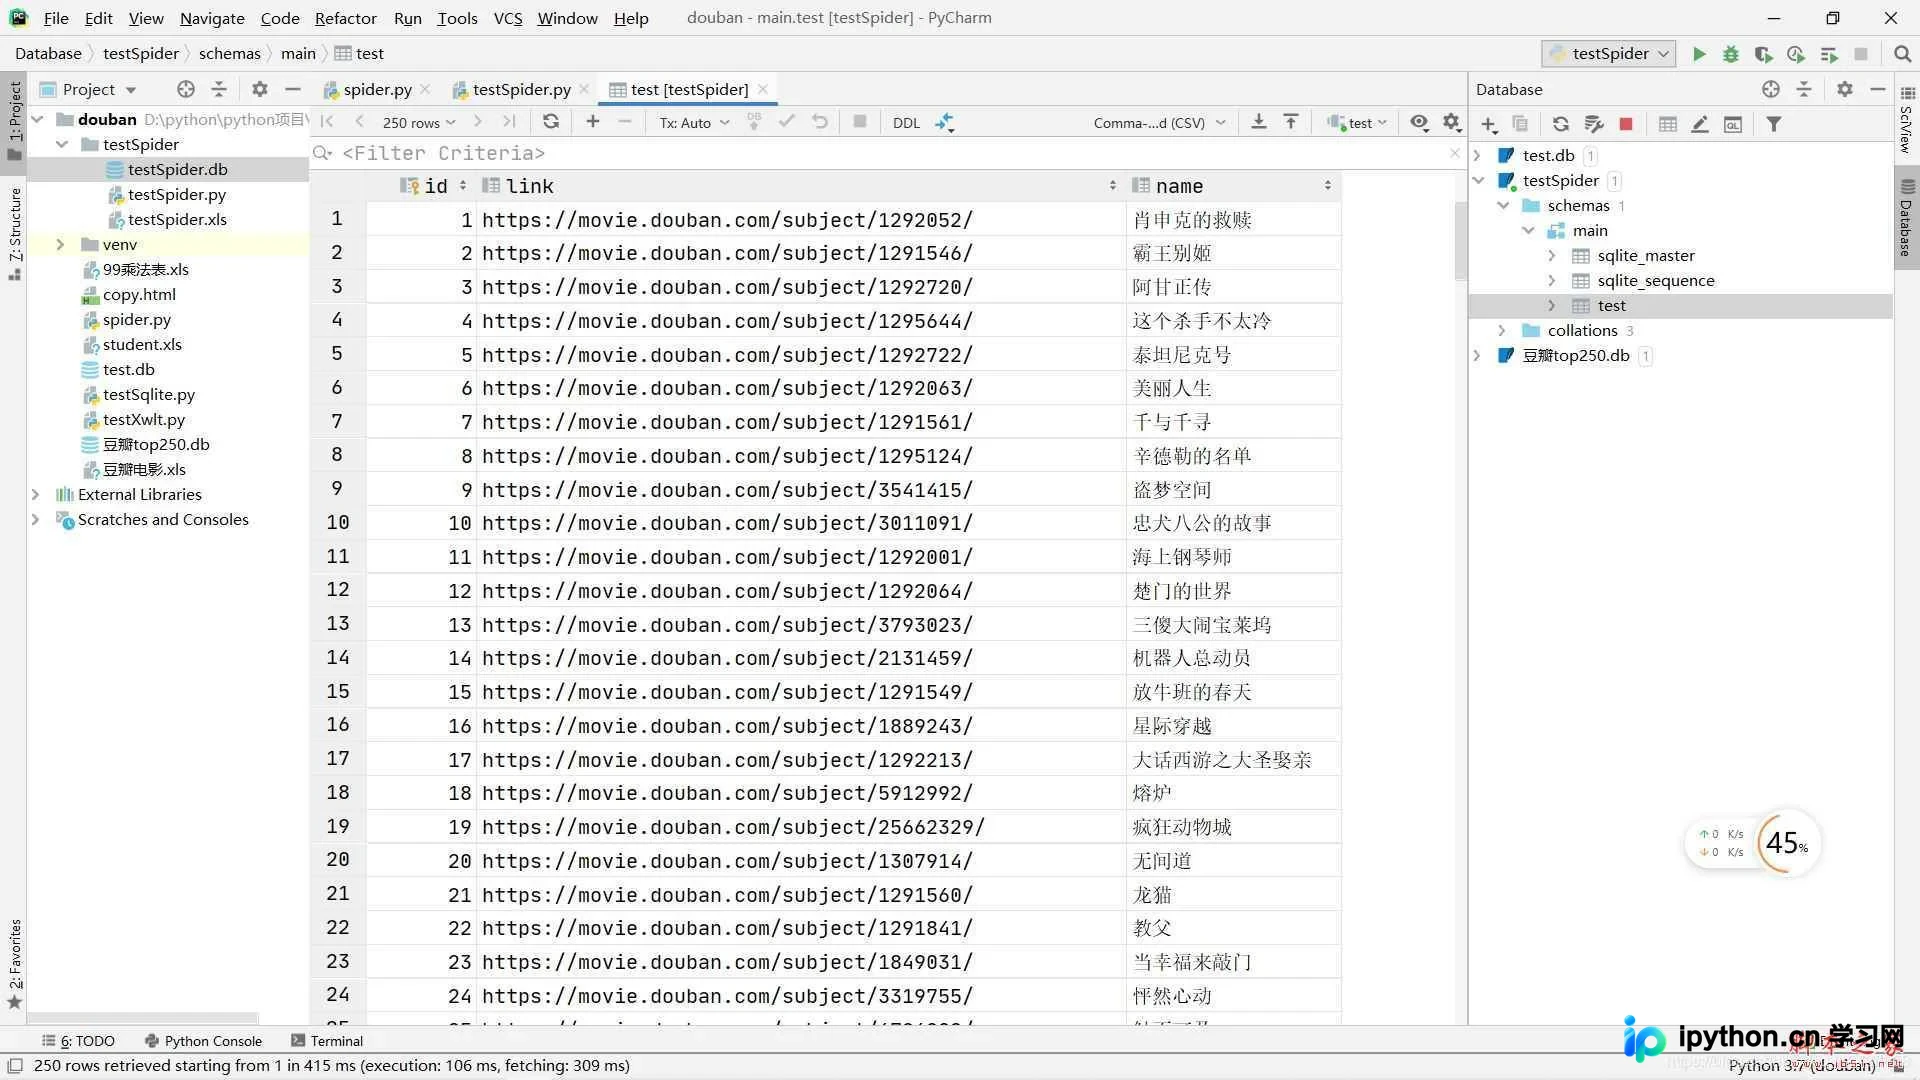
双击DB文件,右侧将自动打开数据库查看界面。
至此,爬虫的基础内容已全部介绍完毕。如有任何疑问或希望进一步交流,可添加QQ 1540741344联系作者。
以下为完整的源代码实现:
import re                  #网页解析,获取数据
from bs4 import BeautifulSoup        #正则表达式,进行文字匹配
import urllib.request,urllib.error     #制定URL,获取网页数据
import xlwt
import sqlite3

findlink=r'<a class="" href="(.*?)"'
findname=r'<span class="title">(.*?)</span>'
def main():
  dbpath="testSpider.db"               #用于指定数据库存储路径
  savepath="testSpider.xls"             #用于指定excel存储路径
  baseURL="https://movie.douban.com/top250?start="  #爬取的网页初始链接
  dataList=getData(baseURL)
  saveData(dataList,savepath)
  saveDataDb(dataList,dbpath)
def askURL(url): #得到指定网页信息的内容 #爬取一个网页的数据
  # 用户代理,本质上是告诉服务器,我们是以什么样的机器来访问网站,以便接受什么样的水平数据
  head={"User-Agent":"Mozilla / 5.0(Windows NT 10.0;Win64;x64) AppleWebKit / 537.36(KHTML, likeGecko) Chrome / 84.0.4147.89 Safari / 537.36"}
  request=urllib.request.Request(url,headers=head)     #request对象接受封装的信息,通过urllib携带headers访问信息访问url
  response=urllib.request.urlopen(request)         #用于接收返回的网页信息
  html=response.read().decode("utf-8")           #通过read方法读取response对象里的网页信息,使用“utf-8”
  return html                       #返回捕获的网页内容,此时还是未处理过的
def getData(baseURL):
  dataList=[]                   #初始化datalist用于存储获取到的数据
  for i in range(0,10):
    url=baseURL+str(i*25)
    html=askURL(url)                  #保存获取到的源码
    soup=BeautifulSoup(html,"html.parser")       #对html进行逐一解析,使用html.parser解析器进行解析
    for item in soup.find_all("div",class_="item"):   #查找符合要求的字符串 ,形成列表,find_all是查找所有的class是item的div
      data=[]                     #初始化data,用于捕获一次爬取一个div里面的内容
      item=str(item)                 #将item数据类型转化为字符串类型
      # print(item)
      link=re.findall(findlink,item)[0]        #使用re里的findall方法根据正则提取item里面的电影链接
      data.append(link)                #将网页链接追加到data里
      name=re.findall(findname,item)[0]        #使用re里的findall方法根据正则提取item里面的电影名字
      data.append(name)                #将电影名字链接追加到data里
      # print(link)
      # print(name)
      dataList.append(data)              #将捕获的电影链接和电影名存到datalist里面
  return dataList                     #返回一个列表,里面存放的是每个电影的信息
  print(dataList)

def saveData(dataList,savepath):              #保存捕获的内容到excel里,datalist是捕获的数据列表,savepath是保存路径
  book=xlwt.Workbook(encoding="utf-8",style_compression=0)#初始化book对象,这里首先要导入xlwt的包
  sheet=book.add_sheet("test",cell_overwrite_ok=True)   #创建工作表
  col=["电影详情链接","电影名称"]              #列名
  for i in range(0,2):
    sheet.write(0,i,col[i])               #将列名逐一写入到excel
  for i in range(0,250):
    data=dataList[i]                  #依次将datalist里的数据获取
    for j in range(0,2):
      sheet.write(i+1,j,data[j])           #将data里面的数据逐一写入
  book.save(savepath)                   #保存excel文件

def saveDataDb(dataList,dbpath):
  initDb(dbpath)                     #用一个函数初始化数据库
  conn=sqlite3.connect(dbpath)              #初始化数据库
  cur=conn.cursor()                    #获取游标
  for data in dataList:
    for index in range(len(data)):
      data[index]='"'+data[index]+'" '        #将每条数据都加上""
    #每条数据之间用,隔开,定义sql语句的格式
    sql='''
      insert into test(link,name) values (%s)
    '''%','.join (data)
    cur.execute(sql)                  #执行sql语句
    conn.commit()                    #提交数据库操作
  conn.close()
  print("爬取存入数据库成功!")
def initDb(dbpath):
  conn=sqlite3.connect(dbpath)
  cur=conn.cursor()
  sql='''
    create table test(
      id integer primary key autoincrement,
      link text,
      name varchar

    )
  '''
  cur.execute(sql)
  conn.commit()
  cur.close()
  conn.close()
if __name__=="__main__":    #程序执行入口
  main()
关于Python爬虫使用正则表达式抓取网站内容的介绍到此结束。更多Python正则表达式相关内容,请搜索本站历史文章或继续浏览后续文章,希望大家今后能继续支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















