


Python基于pyCUDA实现GPU加速并行计算入门教程

发布时间:2026-10-13 |
3人浏览过
本文介绍如何利用pyCUDA在Python中实现GPU加速并行计算。pyCUDA作为CUDA的Python接口,提供了灵活的编码方式、自动生命周期管理及丰富的线性代数工具。文章详细解析了pyCUDA的工作流程,包括设备交互、Profiler控制、动态编译等核心功能,并通过具体代码示例展示了如何调用GPU进行矩阵乘法运算,帮助开发者快速上手高性能计算开发。
本文分享一个使用Python结合pyCUDA实现GPU加速并行计算的具体实例,供读者参考学习。
Nvidia的CUDA架构允许开发者直接操作GPU并进行底层编程,但基于C语言的CUDA开发过程复杂且周期较长。Python凭借简单易学、语法简洁及开发高效等优势,成为广泛使用的编程语言。作为CUDA支持的第四种语言,pyCUDA有望在高性能计算领域发挥重要作用。
pyCUDA的主要特性
- 实现对CUDA功能的完整Python封装。
- 提供更为灵活、快速的编码体验,支持代码的自适应调节。
- 具备更强的鲁棒性,能够自动管理目标生命周期并执行错误检测。
- 内置易用的工具包,涵盖基于GPU的线性代数库、reduction和scan操作,并增加了快速傅里叶变换(FFT)包及线性代数包LAPACK。
- 提供完整的帮助文档,可通过Wiki查阅。
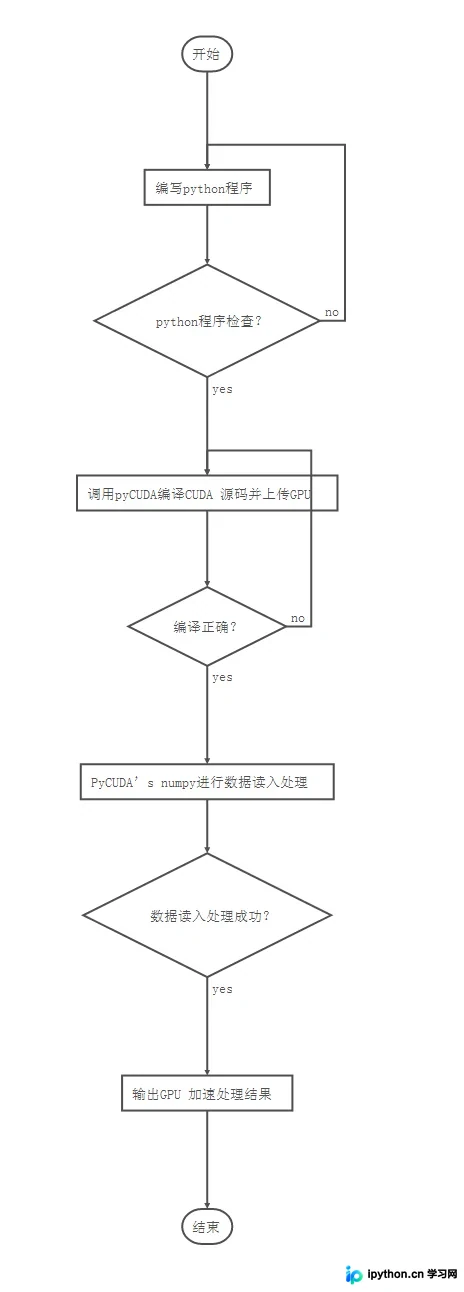
pyCUDA的工作机制
具体的调用流程如下所示。
基础调用示例
import pycuda.autoinit
import pycuda.driver as drv
import numpy
from pycuda.compiler import SourceModule
mod = SourceModule("""
__global__ void multiply_them(float *dest, float *a, float *b)
{
 const int i = threadIdx.x;
 dest[i] = a[i] * b[i];
}
""")
multiply_them = mod.get_function("multiply_them")
a = numpy.random.randn(400).astype(numpy.float32)
b = numpy.random.randn(400).astype(numpy.float32)
dest = numpy.zeros_like(a)
multiply_them(
  drv.Out(dest), drv.In(a), drv.In(b),
  block=(400,1,1), grid=(1,1))
print dest-a*b
#tips: copy from hello_gpu.py in the package.
核心功能详解
- 设备交互
- Profiler控制
- 动态编译
- OpenGL交互
- GPU数组处理
- 高级编程技巧
补充资源说明:
针对GPU加速Python还有其他功能包可供选择,例如用于图像处理的pyGPU,以及专注于GPU加速机器学习的scikitCUDA。此外,Matlab也提供了对应的并行计算工具箱和GPU计算技术工具包,相关教程和介绍文档也可供参考。
感兴趣的用户可进一步查阅本站专题,包括《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望上述内容能对各位的Python程序设计工作提供帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















