


Python使用jieba库进行文本分词及生成词云的方法

本文介绍如何利用Python中的jieba库进行文本分词,并结合wordcloud库绘制词云图。教程涵盖环境配置、文件读取、多余字符清理、自定义词典添加以及词云参数设置等关键步骤,通过《老九门》小说案例演示完整流程,帮助读者掌握自然语言处理的基础技能。
本文详细介绍在Python环境中利用jieba库实现文本分词及词云绘制的具体方法,供开发者参考学习。
主要目标包括:
1. 读取外部文本文件; 2. 调用jieba库对文本内容进行分词处理; 3. 利用wordcloud包生成并展示词云图像。
运行环境配置如下:
Python 3.6.0 | Anaconda 4.3.1 (64-bit)
开发工具选择:
Jupyter Notebook
本文选取网络小说《老九门》作为测试文本,对其进行分词处理并生成对应的词云图。
分词功能采用广泛使用的jieba库,相关文档可参考:https://github.com/fxsjy/jieba
也可通过本站链接下载jieba库文件。
词云绘制功能依赖wordcloud包,参考地址为:https://github.com/amueller/word_cloud
同样支持通过本站链接下载wordcloud库。
需注意,上述两个第三方库并未预装在Anaconda中,需按照官方文档指引手动安装。
import wordcloud as wc
import jieba
import matplotlib.pyplot as plt
from scipy.misc import imread
%matplotlib inline
plt.rc('figure', figsize=(15, 15))
首先,程序读取目标文件,并将内容存储为字符串变量。
all_text = open(file='老九门.txt', encoding='utf-8').read()
检查字符串内容后发现存在大量无效字符,如换行符'\n'和全角空格'\u3000'。
all_text
'\ufeff《盗墓笔记》中,一段与二月红有关的故事。\n《老九门》壹:二月红①\n丝帐许久没有换过了。\n\u3000\u3000她半夜入不了眠,睁开眼睛,便看到床边垂下的帐面,在月光下看着有一死暗淡。原来可是丝丝的带着光亮,好像最白的银拉出来的丝一般。\n\u3000\u3000果然再好的东西,也总是由好往坏了去。\n\u3000\u3000以往一过立秋,... ...<以下省略>
在正式分词前,需先剔除这些冗余字符以优化数据质量。
all_text = all_text.replace('\n', '' )
all_text = all_text.replace('\u3000', '')
接下来尝试执行首次分词,将所有分词结果用空格连接并输出,以观察初步分词效果:
seg_list = jieba.cut(all_text, cut_all=False)
words =' '
for seg in seg_list:
  words = words + seg + ' '
print(words)
《 盗墓 笔记 》 中 , 一段 与 二月 红 有关 的 故事 。 《 老 九门 》 壹 : 二月 红 ① 丝帐 许久 没有 换过 了 。 她 半夜 入 不了 眠 , 睁开眼睛 , 便 看到 床边 垂下 的 帐面 , 在 月光 下 看着 有 一死 暗淡 。 原来 可是 丝丝 的 带 着 光亮 , 好像 最白 的 银拉 出来 的 丝 一般 。 果然 再 好 的 东西 , 也 总是 由 好 往坏 了 去 。 以往 一过 立秋 , 她 就 会 亲自 拆 下 这块 帐头 , 亲自 去 漂洗 , 她 知道 这 东西 的 脾气 , 得 小心 伺候 着 , 一寸 一寸 地过 水 。 如今 不让 她 下床 , 这 东西 没 人 伺候 了 , 倒 也 显得 越来越 不值 当 被 这么 细心 对待 起来 。 也许 , 下 一个 立秋 的 时候 , 才 有人 敢动 这个 东西 , 但 那个 人 , 必然 不是 自己 了 。 中午 大夫 和 他 说 的 那些 话 , 虽然 是 在 屋外 , 但是 她 还是 听到 了 几分 , 自己 的 病 , 不 知道 还有 多少 日子 可熬 。 她 舒 了 口气 , 胸中 的 那丝 痛楚 似乎 好 了 一些 。 多少 日 ... ...<以下省略>
观察分词结果可知,部分专有名词如“盗墓笔记”、“老九门”、“二月红”等被错误拆分。这是由于默认分词策略基于通用语料库,而在该小说语境下,这些词汇应视为整体。
为解决此问题,jieba提供了“用户自定义词典”机制。将特定词汇加入词典后,分词时会将其识别为完整词语。
在项目目录下创建文本文件dict.txt,并录入以下自定义词汇:
老九门 二月红 盗墓笔记 张大佛爷 解九爷 解九 狗五
加载上述词典文件后,再次执行分词操作,结果如下:
jieba.load_userdict('dict.txt')
all_seg = jieba.cut(all_text, cut_all=False)
all_word =' '
for seg in all_seg:
  all_word = all_word + seg + ' '
print(all_word)
《 盗墓笔记 》 中 , 一段 与 二月红 有关 的 故事 。 《 老九门 》 壹 : 二月红 ① 丝帐 许久 没有 换过 了 。 她 半夜 入 不了 眠 , 睁开眼睛 , 便 看到 床边 垂下 的 帐面 , 在 月光 下 看着 有 一死 暗淡 。 原来 可是 丝丝 的 带 着 光亮 , 好像 最白 的 银拉 出来 的 丝 一般 。 果然 再 好 的 东西 , 也 总是 由 好 往坏 了 去 。 以往 一过 立秋 , 她 就 会 亲自 拆 下 这块 帐头 , 亲自 去 漂洗 , 她 知道 这 东西 的 脾气 , 得 小心 伺候 着 , 一寸 一寸 地过 水 。 如今 不让 她 下床 , 这 东西 没 人 伺候 了 , 倒 也 显得 越来越 不值 当 被 这么 细心 对待 起来 。 也许 , 下 一个 立秋 的 时候 , 才 有人 敢动 这个 东西 , 但 那个 人 , 必然 不是 自己 了 。 中午 大夫 和 他 说 的 那些 话 , 虽然 是 在 屋外 , 但是 她 还是 听到 了 几分 , 自己 的 病 , 不 知道 还有 多少 日子 可熬 。 她 舒 了 口气 , 胸中 的 那丝 痛楚 似乎 好 了 一些 。 多少 日子 了 ? ... ...<以下省略>
改进后的分词结果中,人名和书名均保持完整,未再被拆分。
随后进入词云制作环节。
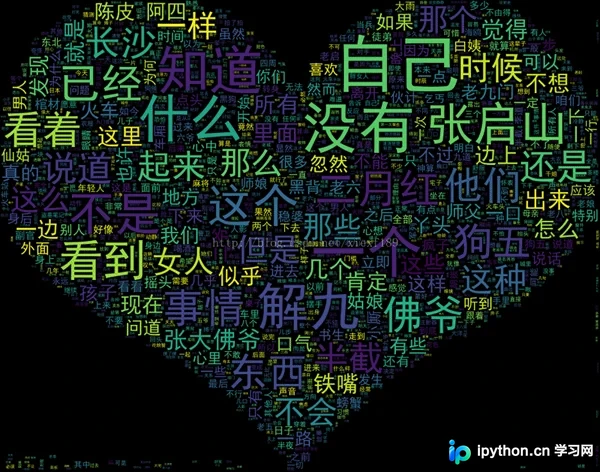
词云生成依赖wordcloud库,其中字体和背景图片是两个关键参数。字体用于显示文字,背景图片则决定词云的形状轮廓。本例选用了一张心形图案作为背景。
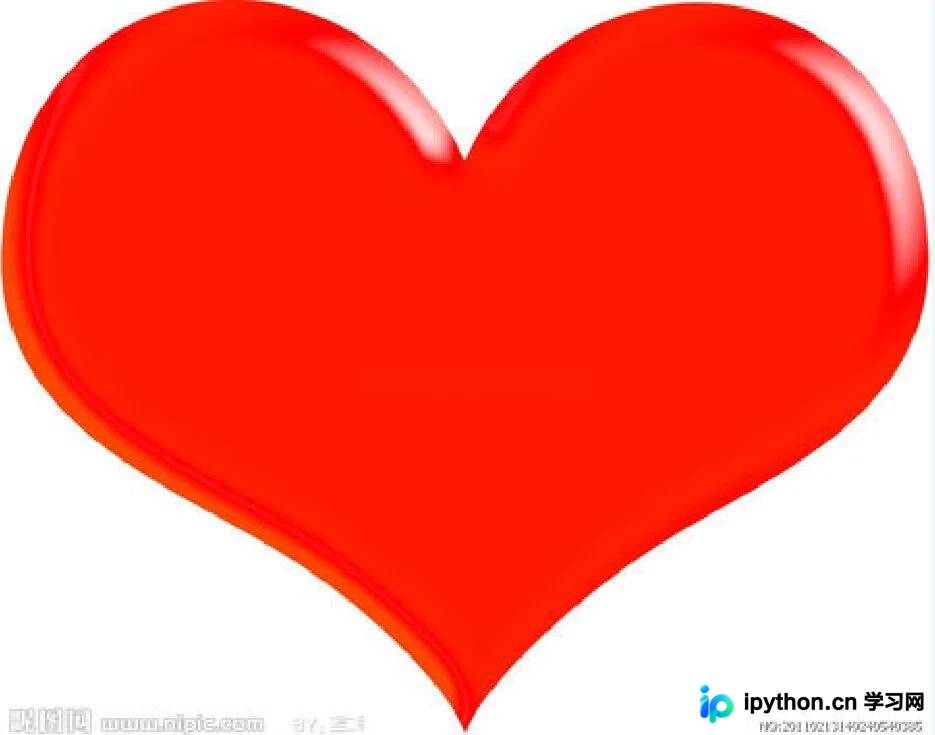
词云生成的具体代码实现如下:
# 引入字体
font=r"C:\WINDOWS\Fonts\simhei.ttf"
#读取背景图片,生成矩阵
color_mask = imread("love.jpg")
# 生成词云对象,设置参数
cloud = wc.WordCloud( font_path=font,#设置字体
           background_color="black", #背景颜色
           max_words=2000,# 词云显示的最大词数
           mask=color_mask,#设置背景图片
           max_font_size=100, #字体最大值
           random_state=42)
# 绘制词云图
mywc = cloud.generate(all_word)
plt.imshow(mywc)
<matplotlib.image.AxesImage at 0x1ecebf5e588>
# 把词云图保存到磁盘文件中
mywc.to_file('老九门wordcloud.png')
<wordcloud.wordcloud.WordCloud at 0x1ece4b9bc88>
以上即为使用Python进行文本分词及绘制词云图的完整流程。关于jieba和wordcloud的高级用法,建议进一步深入研究与实践。
感兴趣的用户可查阅本站相关专题,如《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》,以获取更多Python编程知识。
希望本文内容能对各位Python程序员的开发工作提供有益帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















