


Python处理数据并导入Hive表的完整流程

本文详细介绍如何利用Python将本地TXT文件中的数据清洗并导入Hive表。核心步骤包括:分析源数据与目标Hive表结构的差异,通过字段筛选与重排序实现结构对齐,处理JSON字段及空值,最后创建对应Hive表并使用LOAD DATA命令完成数据加载。
接到任务后,需要将TXT文件中的部分数据存入Hive中一个结构已存在的表。整个处理流程包含三个主要步骤:首先,对原始数据进行清洗和转换,使其结构与Hive目标表的字段结构保持一致;其次,参照Hive中已有表的结构定义,创建一张新的数据表;最后,将处理好的本地TXT文件数据上传并加载到Hive中新建的表中。
第一步需要解决源数据与Hive目标表结构不匹配的问题。原Hive表的结构与组长提供的TXT文件结构存在显著差异,具体对比情况如下文图示所示。
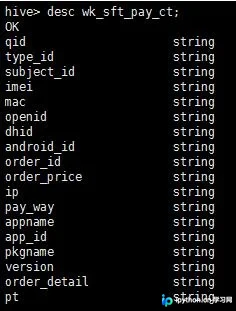
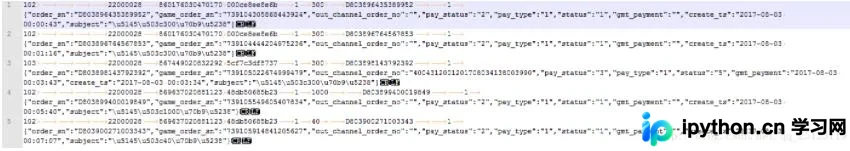
通过对比可以发现,原有的Hive表包含17个字段,而组长提供的TXT文件中仅包含9个字段。此外,TXT文件中的最后一个字段为JSON格式,且字段顺序与Hive表不一致。因此,必须执行筛选操作,将能够对应的字段放置到Hive表指定的位置,对于无法对应的字段则填充为空值。
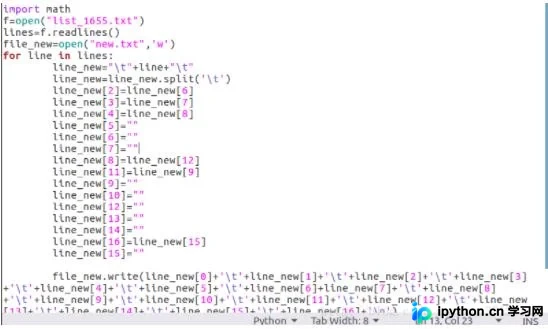
在处理过程中需注意几个关键点:原始数据是以Tab键作为分隔符的,因此必须准确计算Tab的数量以确定数据的实际位置信息。随后,依据Hive表中定义的数据顺序,重新排列新建表中的数据顺序。处理后的结果示例如下。
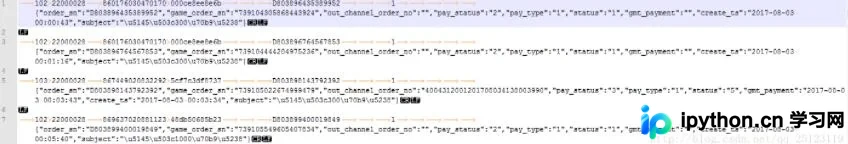
例如,在处理后的数据行中,line[0]为null,line[1]为102,其余字段依此类推进行对应。
第三步是将本地TXT文件导入到Hive表中。首先,需要创建一个与原有Hive表结构完全一致的新数据表,然后将清洗后的数据导入该表中。
hive> creat table new_sft(x1 string,x2 string ,...,xn string) partitioned by (d string);
创建好目标表后,执行数据导入操作,将数据加载到新创建的表中。
hive> load data local inpath‘/home/opendev/1.txt' into table new_sft;
以下是最终导入Hive表后的结果展示。
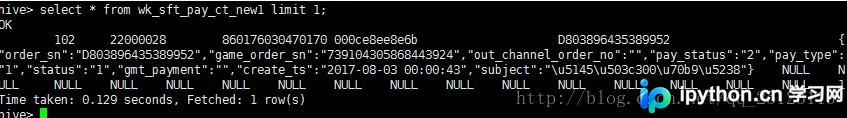
以上即为Python处理数据并存储至Hive表的完整方法,希望能为读者提供有价值的参考。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















