


Python爬虫实现登录并导出CSV数据详解

发布时间:2026-10-13 |
5人浏览过
本文介绍使用Python编写简单爬虫,通过模拟登录获取HTML页面,利用正则表达式解析目标数据行,并将结果逐行写入CSV文件的全过程。包含核心逻辑说明、完整代码示例及导出结果展示,适用于需要批量抓取网页数据并保存为表格格式的场景。
处理流程如下:首先模拟用户登录获取会话,接着请求并获取目标HTML页面内容,然后使用正则表达式解析出所有符合特定条件的数据行,随后将这些行中的各列数据逐一提取并存入名为CSVData的临时列表变量中,最后将该列表内容写入到指定的CSV文件中。
核心代码逻辑如下:
 ####写入Csv文件中
      with open(self.CsvFileName, 'wb') as csvfile:
        spamwriter = csv.writer(csvfile, dialect='excel')
        #设置标题
        spamwriter.writerow(["游戏账号","用户类型","游戏名称","渠道","充值类型","充值金额","返利金额","单号","日期"])
        #将CsvData中的数据循环写入到CsvFileName文件中
        for item in self.CsvData:
          spamwriter.writerow(item)
完整实现代码如下:
# coding=utf-8
import urllib
import urllib2
import cookielib
import re
import csv
import sys

class Pyw():
  #初始化数据
  def __init__(self):
    #登录的Url地址
    self.LoginUrl="http://v.pyw.cn/login/check"
    #所要获取的Url地址
    self.PageUrl="http://v.pyw.cn/Data/accountdetail/%s"
    # 传输的数据:用户名、密码、是否记住用户名
    self.PostData = urllib.urlencode({
      "username": "15880xxxxxx",
      "password": "a123456",
      "remember": "1"
    })
    #第几笔记录
    self.PageIndex=0;
    #循环获取共4页内容
    self.PageTotal=1
    #正则解析出tr
    self.TrExp=re.compile("(?isu)<tr[^>]*>(.*?)</tr>")
    #正则解析出td
    self.TdExp = re.compile("(?isu)<td[^>]*>(.*?)</td>")
    #创建cookie
    self.cookie = cookielib.CookieJar()
    #构建opener
    self.opener=urllib2.build_opener(urllib2.HTTPCookieProcessor(self.cookie))
    #解析页面总页数
    self.Total=4
    #####设置csv文件
    self.CsvFileName="Pyw.csv"
    #####存储Csv数据
    self.CsvData=[]

   #解析网页中的内容
  def GetPageItem(self,PageHtml):
    #循环取出Table中的所有行
    for row in self.TrExp.findall(PageHtml):
      #取出当前行的所有列
      coloumn=self.TdExp.findall(row)
      #判断符合的记录
      if len(coloumn) == 9:
        # print "游戏账号:%s" % coloumn[0].strip()
        # print "用户类型:%s" % coloumn[1].strip()
        # print "游戏名称:%s" % coloumn[2].strip()
        # print "渠道:%s" % coloumn[3].strip()
        # print "充值类型:%s" % coloumn[4].strip()
        # print "充值金额:%s" % coloumn[5].strip().replace("¥", "")
        # print "返利金额:%s" % coloumn[6].strip().replace("¥", "")
        # print "单号:%s" % coloumn[7].strip()
        # print "日期:%s" % coloumn[8].strip()
        #拼凑行数据
        d=[coloumn[0].strip(),
          coloumn[1].strip(),
          coloumn[2].strip(),
          coloumn[3].strip(),
          coloumn[4].strip(),
          coloumn[5].strip().replace("¥", ""),
          coloumn[6].strip().replace("¥", ""),
          coloumn[7].strip(),
          coloumn[8].strip()]
        self.CsvData.append(d)

  #模拟登录并获取页面数据
  def GetPageHtml(self):
    try:
      #模拟登录
      request=urllib2.Request(url=self.LoginUrl,data=self.PostData)
      ResultHtml=self.opener.open(request)
      #开始执行获取页面数据
      while self.PageTotal<=self.Total:
        #动态拼凑所要解析的Url
        m_PageUrl = self.PageUrl % self.PageTotal
        #计算当期第几页
        self.PageTotal = self.PageTotal + 1
        #获取当前解析页面的所有内容
        ResultHtml=self.opener.open(m_PageUrl)
        #解析网页中的内容
        self.GetPageItem(ResultHtml.read())

      ####写入Csv文件中
      with open(self.CsvFileName, 'wb') as csvfile:
        spamwriter = csv.writer(csvfile, dialect='excel')
        #设置标题
        spamwriter.writerow(["游戏账号","用户类型","游戏名称","渠道","充值类型","充值金额","返利金额","单号","日期"])
        #将CsvData中的数据循环写入到CsvFileName文件中
        for item in self.CsvData:
          spamwriter.writerow(item)

      print "成功导出CSV文件!"
    except Exception,e:
      print "404 error!%s" % e
#实例化类
p=Pyw()
#执行方法
p.GetPageHtml()
导出后的CSV文件内容示例如下:
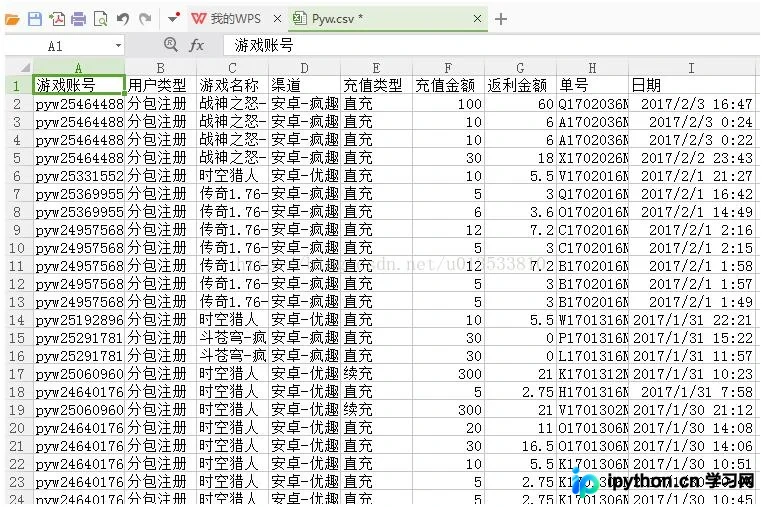
以上就是Python爬虫简单导出CSV文件的完整实例讲解,希望能为读者提供有价值的参考。欢迎大家继续支持本站获取更多技术内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















