


Python实现GitHub自动登录:抓取CSRF Token与Cookie交互详解

发布时间:2026-10-13 |
6人浏览过
本文详细解析使用Python爬虫登录GitHub的技术流程。通过分析登录页面,提取CSRF Token与初始Cookie,利用Requests库发送GET请求获取必要参数,随后构造POST请求提交用户名和密码完成身份验证。最后演示如何携带登录后的Cookie访问个人详情页,实现自动化信息查看。
前言分析目标网站的登录方式
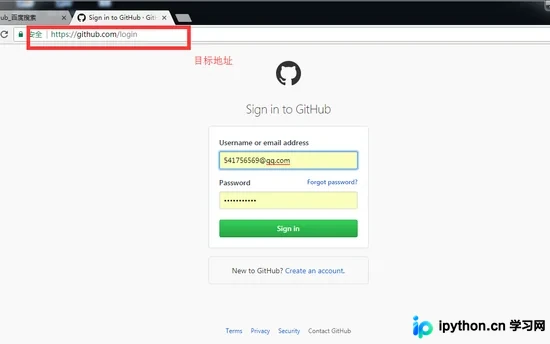
目标地址: https://github.com/login
登录方式做出分析:
首先,系统采用Form表单机制提交用户信息。
其次,页面包含csrf_token字段以进行跨站请求伪造防护。
第三,在发送包含用户名和密码的POST请求前,必须先执行一次GET请求以获取并携带相应的Cookie。
第四,一旦登录成功,后续访问其他受保护页面时,仅需携带首次登录成功返回的Cookie即可维持会话状态。
通过GET请求获取所需的Token和Cookie信息。
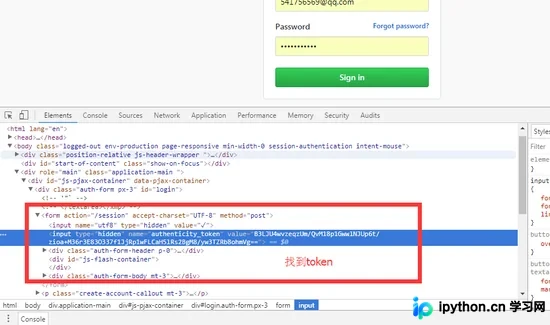
代码:
import requests
from bs4 import BeautifulSoup
r1 = requests.get('https://github.com/login')
soup = BeautifulSoup(r1.text,features='lxml') #生成soup 对象
s1 = soup.find(name='input',attrs={'name':'authenticity_token'}).get('value')
#查到我们要的token
r1_cookies = r1.cookies.get_dict() # 下次提交用户名时用的cookie
# print(r1_cookies)
# print(s1)
#结果::
{'logged_in': 'no', '_gh_sess': 'VDFWa2hJWjFMb1hpRUFLRDVhUmc3MXg1Tk02TDhsUnhDMERuNGpyT2Y4STlQZ2xCV1lCZEFhK21wdFR1bkpGYUV0WEJzcDEydWFzcm93
aVc4Nk91Q2JicmtRV0NIQ0lRSWM4aFhrSVFYbCtCczBwdnhVN0YySVJJNUFpQnhyTzNuRkJwNDJZUWxUcEk2M2JkM3VSMDdXVHNOY1htQkthckJQZDJyUVR2RzBNUkU3VnltRVF2U
m1admU3c3YzSGlyVnVZVm0ycnA1eUhET1JRVWNLN0pSbndKWjljMGttNG5URWJ1eU8rQjZXNEMxVEthcGVObDFBY2gvc2ZzWXcvWWZab29wQWJyU0l6cmZscWhBQUlzYTA3dTRtb
3l1S0hDYytHY2V1SUhEWlZvVlZoSWZpTzBjNmlidFF2dzI2bWgtLTJON1lqbm5jWUtSYmtiVEM1clJPakE9PQ%3D%3D--897dbc36c123940c8eae5d86f276dead8318fd6c'}
pRz0wapEbu5shksGCeSN0FijWoU9ALw8EPUsXlqgcw1Ezirl0VbSKvkTYqIe8VhxhPH2H/uzGaV6XX+yjTGoVA==
提取这两个关键值后,即可进行下一步的登录请求发送。
第二步:采用POST方式提交用户名和密码。
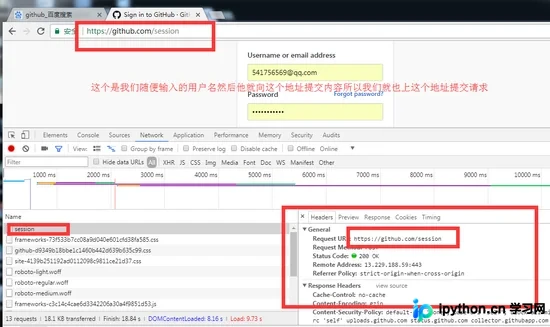
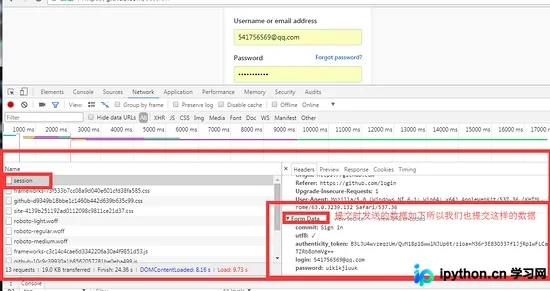
代码::
该代码片段接续上述GET请求逻辑,仅展示POST请求部分。
r2 = requests.post(
  'https://github.com/session',
  data ={
    'commit':'Sign in',
    'utf8':'✓',
    'authenticity_token':s1,
    'login':'541756569@qq.com',
    'password':'用户名密码'         # 填上正确的用户名即可
  },
  cookies = r1.cookies.get_dict(),    # 这里需要第一次的cookie
)
print(r2.cookies.get_dict())   # 这个是成功以后的cookie
执行成功后,将返回登录页面的响应信息。
基于POST登录成功后,进一步查看个人详情页。
此时只需携带登录成功后的Cookie即可访问。
#完整代码
import requests
from bs4 import BeautifulSoup
r1 = requests.get('https://github.com/login')
soup = BeautifulSoup(r1.text,features='lxml')
s1 = soup.find(name='input',attrs={'name':'authenticity_token'}).get('value')
r1_cookies = r1.cookies.get_dict()
print(r1_cookies)
print(s1)
r2 = requests.post(
  'https://github.com/session',
  data ={
    'commit':'Sign in',
    'utf8':'✓',
    'authenticity_token':s1,
    'login':'541756569@qq.com',
    'password':'密码'
  },
  cookies = r1.cookies.get_dict(),
)
查看个人详情页
print(r2.cookies.get_dict())
 r3 = requests.get(
    'https://github.com/13131052183/product',  #查看个人的详情页
    cookies = r2.cookies.get_dict()
 )
 print(r3.text)
总结
以上所述是小编给大家介绍的Python爬虫使用脚本登录Github并查看信息,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















